「機能の制約を思い出すために、3年前のチームミーティングの録画を見返す人間はいない。人は物事を文書に書き留め、その記録を参照するのだ」
開発者のKevin Liao氏は、エッセイ『Agents Don’t Need Memory. They Need Documentation.』の中で、現行のAIエージェントエコシステムにおける記憶ソリューションには構造的な工学的欠陥があると指摘した。多くのプロダクトがRAGアーキテクチャの上にバックグラウンドデーモンやリランカー、自動要約アルゴリズムを次々と積み重ねる一方で、実際の現場ではブラックボックス化した記憶がもたらす管理上の混乱に直面し続けている。
RAGの抽選方式では解決できない5つの工学的落とし穴
現在市場に出回っているエージェント記憶プラグインは、ほぼ同一の設計パターンを採用している。過去の会話ログを走査して記憶スニペットを生成し、ベクトルDBに格納した上で、プロンプトが入力されるたびに上位5件を検索してコンテキストに注入する。Liao氏はこの仕組みを「RAGスニペットの抽選大会」と表現する。細切れに分割されたベクトル記録では、コードが書かれた本来の動機や、当時の開発環境の状態が完全に失われてしまうからだ。
 図:孤立し文脈の追跡が困難な記憶スニペット。出典:liao.gg
コサイン類似度マッチングは埋め込み空間における断片同士の距離を算出するに過ぎず、現在のシステムにおいてどのルールが正しいかを判断できない。過去の記録をそのまま「現在の事実」として扱うことは、日夜変更が加わるコードベースにおいて重大なリスクを孕む。例えば認証ロジックが刷新された場合、データベース内に残る古い断片がエージェントに陳腐化した指示を流し込むことになる。1万件の埋め込みデータが潜むブラックボックスの中で、どの情報が古びており、どれが一度も参照されていないのかを人間が判別することは極めて困難だ。仮に全体検索ツールを与えたとしても、エージェント自身が「自分は何を知らないのか」「いつ検索すべきか」を判断することはできない。
4つの段階で再構築するドキュメント駆動ワークフロー
こうしたブラックボックス記憶の管理破綻に対し、Liao氏が提唱するのが「ドキュメントベースの記憶(Document-based Memory)」である。このアプローチではバックグラウンドの常駐プロセスやベクトルインターフェースを排し、プレーンなMarkdownによる構造化ドキュメント体系を導入する。単一の AGENTS.md だけで大規模開発を支え切ることは難しく、開発指示、仕様、設計判断の記録、先行調査などを体系的にカバーする環境が必要となる。
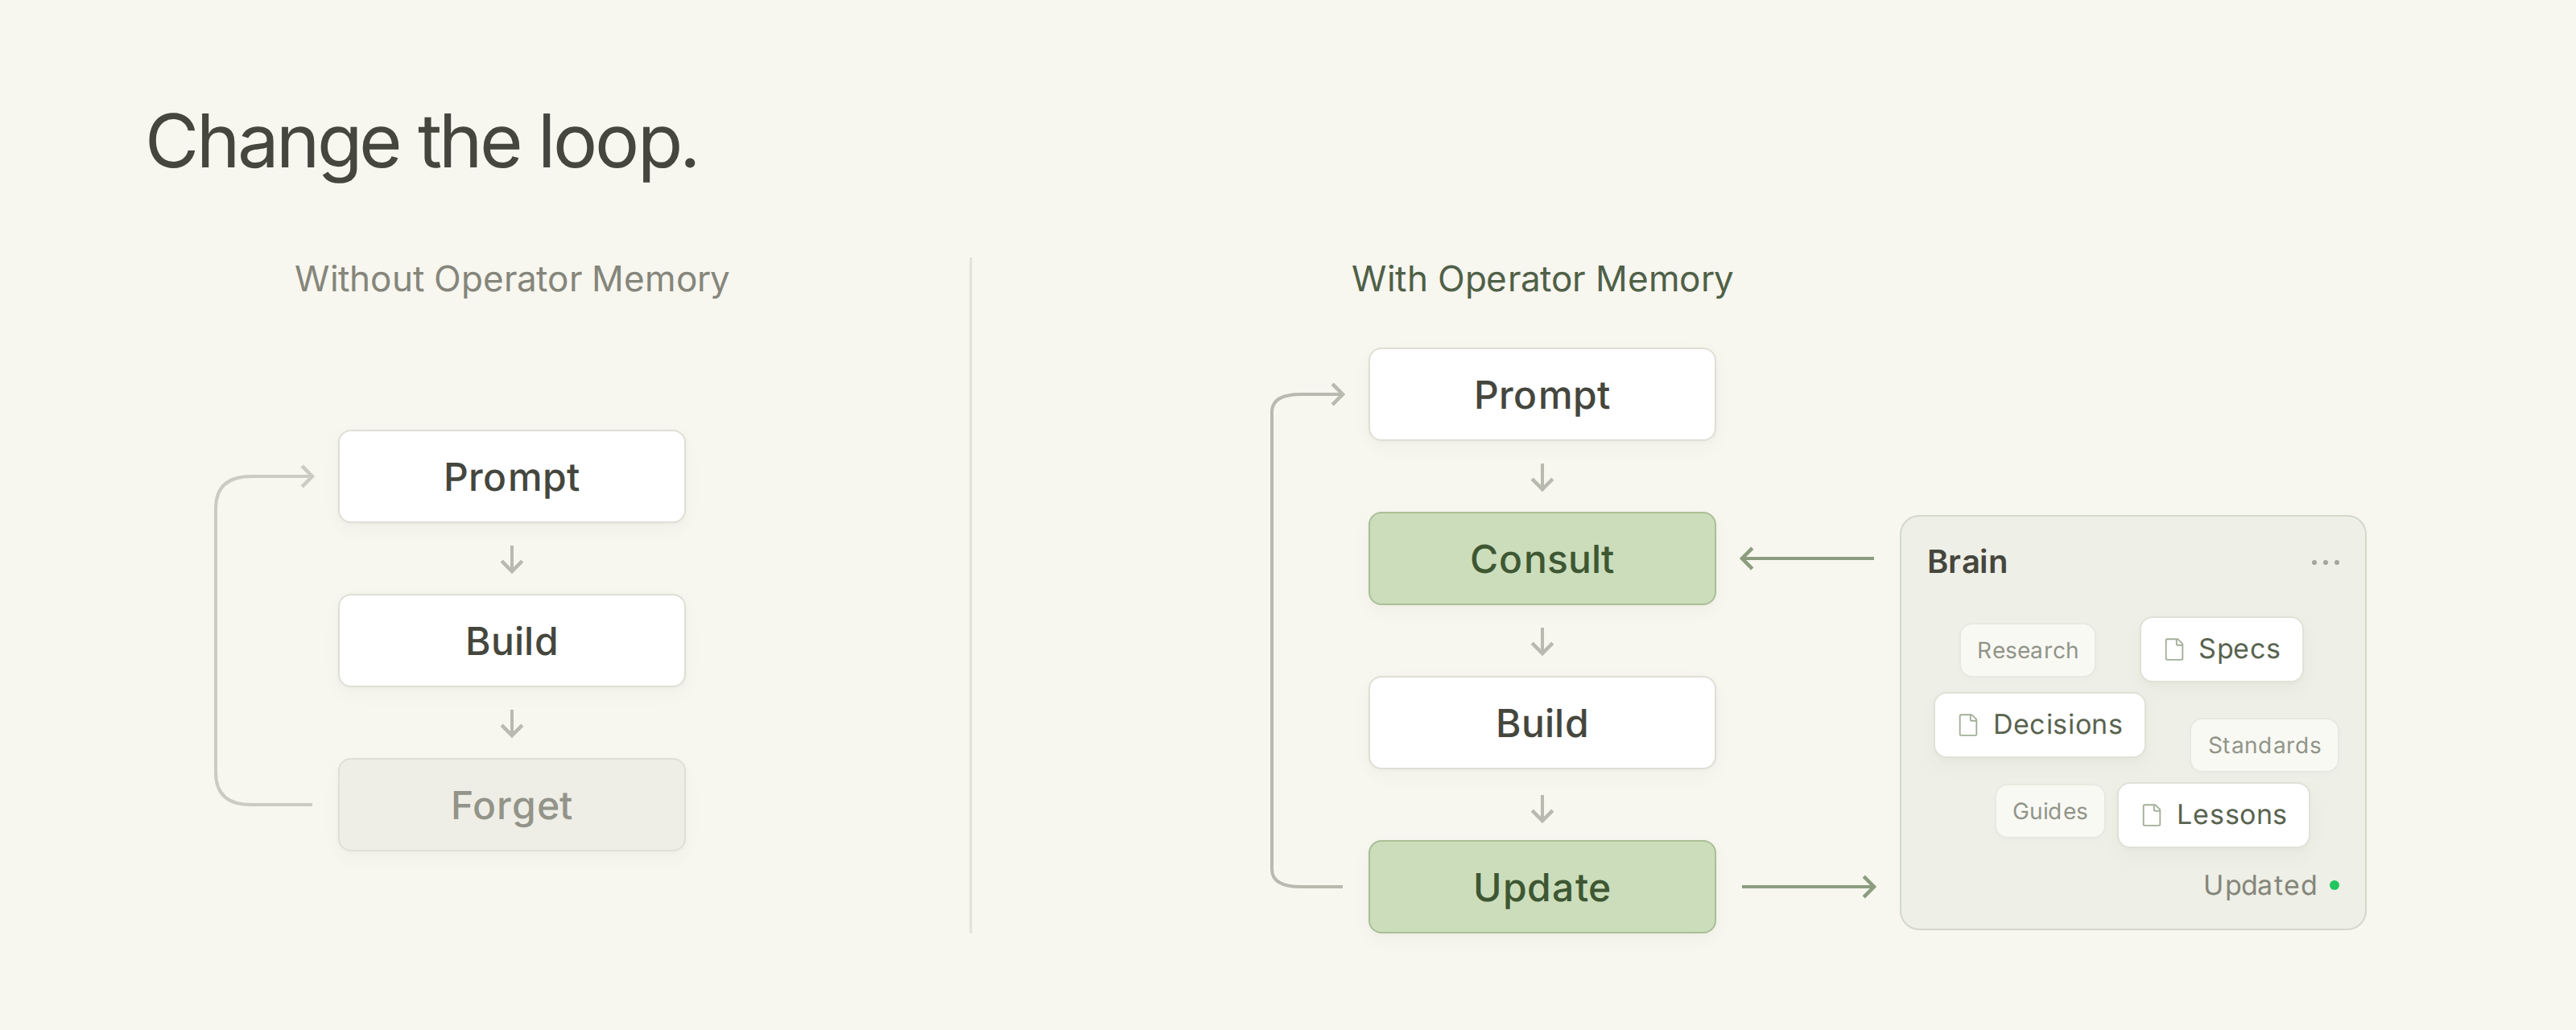 図:prompt → build → forget から prompt → consult → build → update へのサイクルの対比。出典:liao.gg
ここにおいて開発サイクルは、一方通行の prompt → build → forget から、prompt → consult → build → update へと進化する。エージェントはタスクを受け取ると、まず担当モジュールの関連文書を参照し、コードの実装を終えた後、新たに発生した制約や最新の状態をプロジェクト文書へ書き戻す。記憶は外付けの不透明な検索DBから、人間とエージェントが共に読み、更新し、共有できる透明なワークスペースへと姿を変える。
実践から生まれた3層ディレクトリ構造の原則
記憶の媒体を通常のドキュメントに回帰させたことで、コミュニティからは実践的なディレクトリ構成法が提案されている。すべての対話記録を単一の場所に放り込むのをやめ、実行手順を管理する .agents/plans/、調査メモを置く .agents/notes/、検証済みの最終結論を収める .agents/knowledge/ という3層の階層アーキテクチャを敷く運用だ。
この設計において、notesは一時的な試行錯誤の置き場と位置づけられ、実証を経て定着した知見のみがknowledgeへと昇格・蓄積される。特定ドメインの文書が増加した場合には、ローカルの INDEX.md を配置してナビゲーションを担保する。記録媒体をプレーンテキストに戻すことで、先人たちが築き上げてきたファイル構成法やエンジニアリングガバナンスの知見を、そのままAI開発チームの運用に適用できるのだ。
コミュニティの議論:テキスト指示だけでコードの幻覚を防げるのか
一方で、プレーンテキストによるプロトコルの拘束力に対して懐疑的な見方を示す開発者も存在する。プロンプトや文書内で「JSONのパースにはjqのみを使用し、スクリプトの一時作成を禁ず」と明記していても、モデルは複雑なJSONを前にすると独自のPythonスクリプトを書いて実行してしまう現実が報告されている。
確率統計に基づいて出力するLLMにとって、テキストによる指示の強制力には限界がある。そのため、テキスト規約に加えてコンパイラレベルのハードインターセプトを併用すべきだという議論が浮上している。リンターや静的解析のルールを、修正ガイド付きのエラーメッセージとしてモデルにフィードバックすることで、厳密な境界線を敷いてエージェントを本来の実行パスへと誘導する手法である。
エンジニアリングの常識がツールチェーンをプレーンテキストへと回帰させる
静的なMarkdownインデックスを保守するにせよ、厳格なLint検査を配備するにせよ、両者が目指す本質は一つである。現代のソフトウェア開発ツールチェーンには、透明性、決定性、そして監査可能性が不可欠だということだ。従来の記憶プラグインの多くは、文脈管理の問題を単なる検索の再現率(recall)のゲームに矮小化し、機能モジュールを増築することで状態管理の破綻をごまかそうとしてきた。
ソフトウェアエンジニアリングにおける知識の正当な入れ物は、コードレビューに耐え、バージョン管理が可能なプレーンテキストである。エージェントに必要なのは、ブラックボックスの記憶装置ではなく、作業前に参照し、完了後に自ら更新できる生きたドキュメントなのだ。
参考リンク:
- Agents Don’t Need Memory. They Need Documentation.
- Hacker News における関連議論
- Operator Memory リポジトリ