En el mismo internet y el mismo día circulan dos realidades paralelas. En un vídeo, el asistente de voz de OpenAI se bloquea ante un dilema tan trivial como «si conviene ir en coche o caminando a lavar el vehículo», desatando las burlas en los comentarios. En esa misma semana, OpenAI publica en GitHub 722 manuscritos matemáticos generados íntegramente por un modelo de frontera interno, sin nombre público ni acceso externo, que la comunidad matemática aún no ha terminado de digerir.
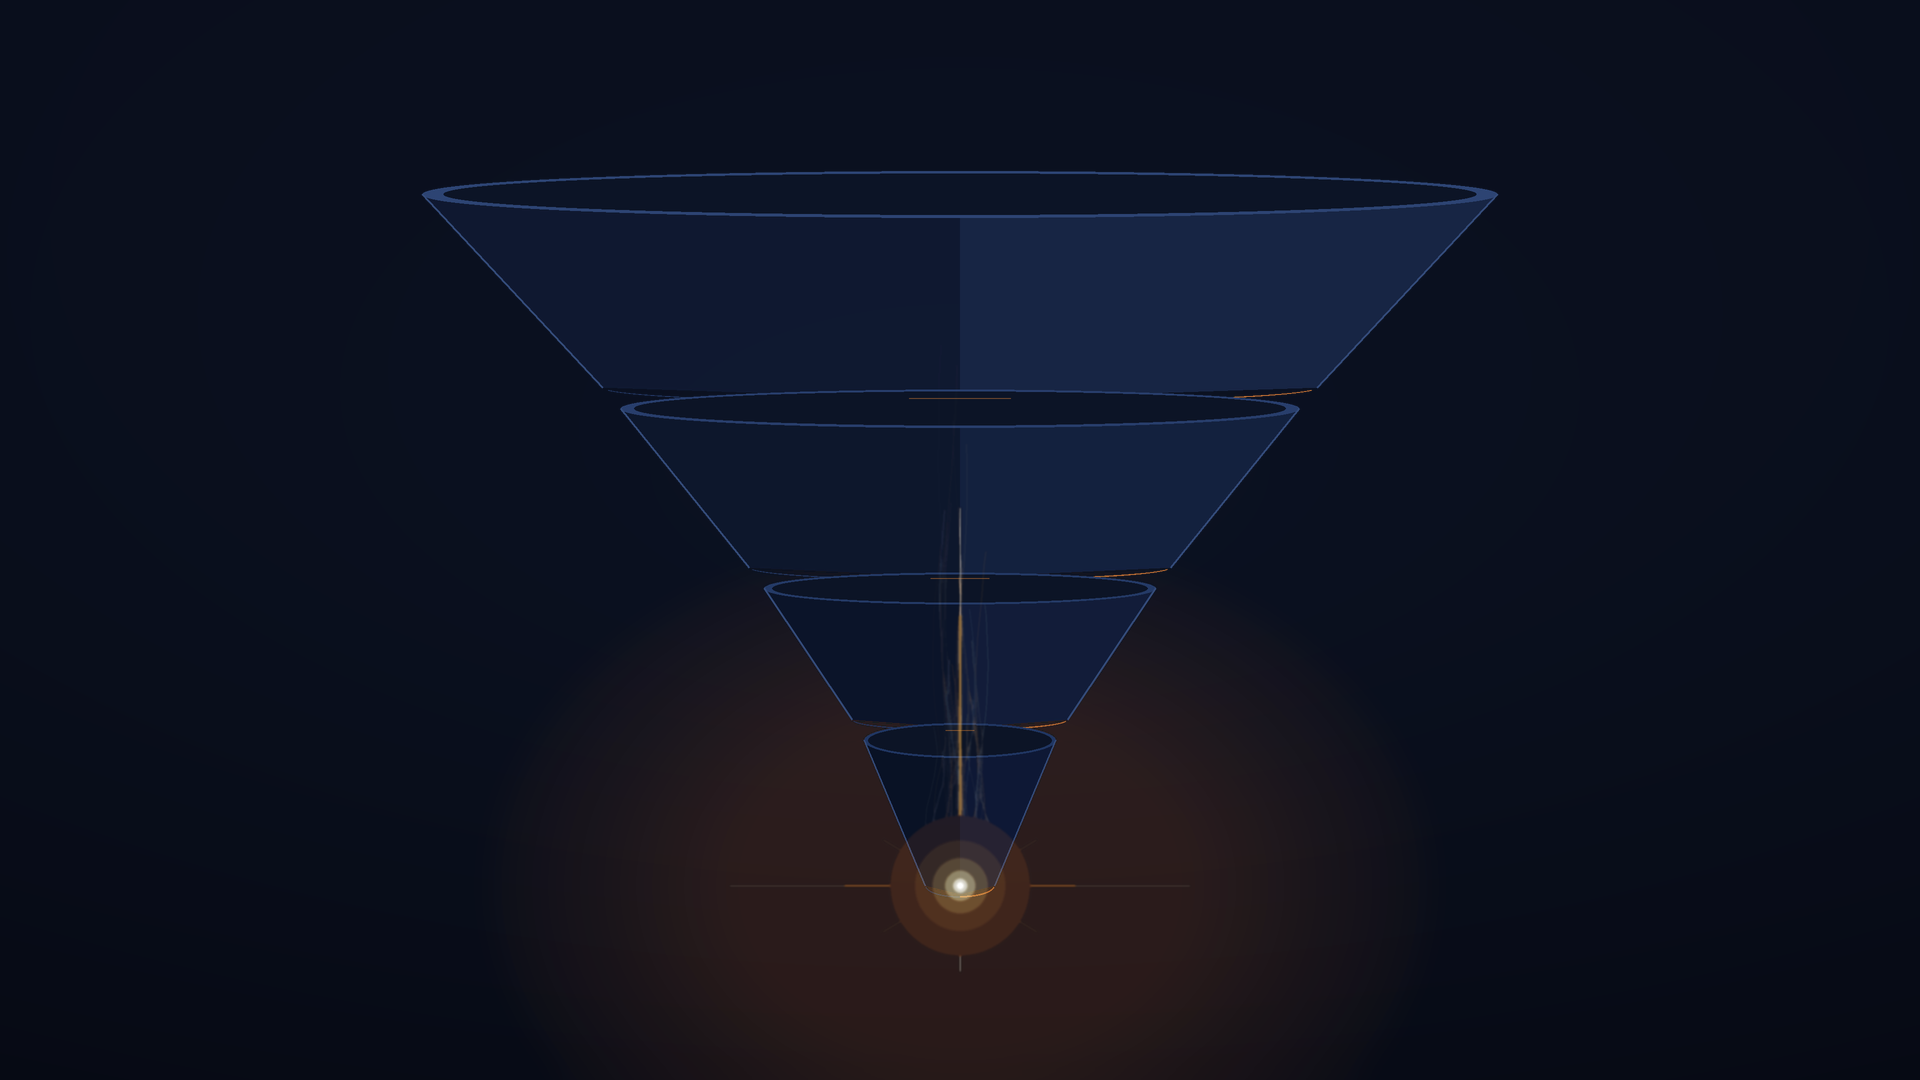
El 11 de octubre, Andrej Karpathy recuperó una publicación suya del pasado mes de abril con un apunte adicional: la brecha de comprensión compartida sobre las capacidades de los LLM no deja de ensancharse. Si en abril hablaba de «dos grupos desconectados que defienden realidades distintas», su diagnóstico actual resulta mucho más tajante: el panorama se ha transformado en un embudo implacable.
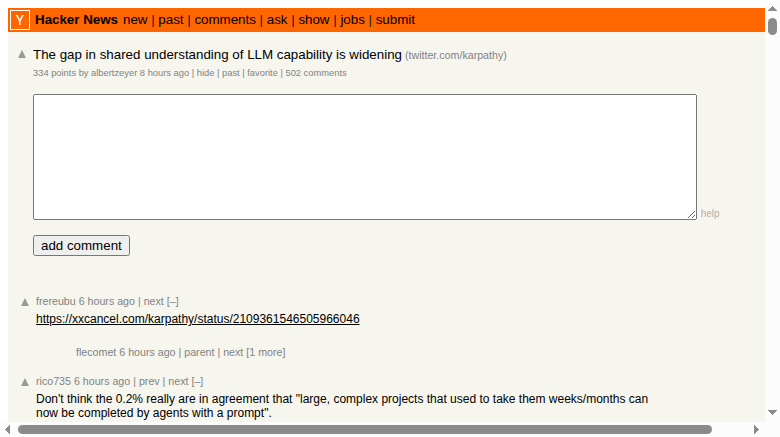 Figura: Captura del hilo de debate en Hacker News. Fuente: news.ycombinator.com
Los cuatro niveles del embudo: 6.000 millones, 2.000 millones, 20 millones y 5.000
Apoyándose en un cálculo rápido de servilleta, Karpathy dividió a la humanidad en cuatro estratos bien diferenciados.
El primer nivel abarca a unos 6.000 millones de personas, el 75% de la población mundial. Apenas han tenido contacto real con los LLM. Para este colectivo, la IA se reduce a titulares de prensa o relatos de ciencia ficción. La bautizada por Silicon Valley como cuarta revolución industrial ni siquiera roza su vida diaria.
El segundo nivel comprende entre 1.000 y 2.000 millones de usuarios ocasionales de servicios gratuitos al estilo de ChatGPT. En este plano, la IA es un chatbot tosco, un buscador algo más versátil o un redactor elemental. Karpathy señala que muchos de sus amigos sin perfil técnico consideran que la tecnología «apenas sirve para nada», una apreciación que él juzga plenamente razonable desde su experiencia. Lo más elocuente es que infinidad de directivos empresariales también se estancan en este escalón: entienden de forma racional y teórica que la IA lo transforma todo, pero su percepción sigue siendo indirecta y abstracta.
El tercer nivel reúne a unos 20 millones de individuos, apenas el 0,2% global. Son profesionales de las matemáticas y la programación que pagan por modelos de agentes punteros y los exprimen a diario en entornos técnicos. Karpathy ilustra este salto con su propio periplo profesional: hace solo un año picaba código carácter a carácter, valiéndose únicamente del autocompletado con tabulador. En la actualidad, proyectos complejos que antes requerían semanas o meses de esfuerzo se despachan con un único prompt asignado a un agente: construir aplicaciones, replicarlas, traducirlas entre lenguajes o incluso descompilarlas a partir de ejecutables binarios.
El cuarto nivel corona la cúspide: apenas unas 5.000 personas en todo el planeta, el 0,00006% de la humanidad. Son los especialistas con acceso directo a los sistemas experimentales internos más avanzados de los laboratorios de IA. Mientras el exterior solo vislumbra versiones preliminares recortadas, este reducido grupo observa enjambres completos de agentes que cooperan de forma autónoma durante semanas: acometen desarrollos de software masivos, descubren vulnerabilidades de día cero (zero-day), operan ataques y defensas a velocidad de máquina y empujan la frontera de las matemáticas formulando nuevos principios científicos.
Para dimensionar qué significan 5.000 personas: a lo largo de la historia, alrededor de 7.500 montañeros han alcanzado la cima del Everest. Quienes han contemplado el techo real de la IA son menos que aquellos que han coronado el techo del mundo.
Por qué precisamente el código y las matemáticas
A la hora de explicar por qué cristaliza este embudo, Karpathy apunta tres factores determinantes.
El primero es la escala del objetivo. Formular a la IA preguntas cuya respuesta cabe en un párrafo jamás exigirá a fondo la capacidad del sistema. Hace falta un auténtico embalse de problemas difíciles —desafíos críticos e ineludibles que el usuario necesita resolver cueste lo que cueste— para forzar a la máquina hasta su límite operativo. El usuario común no dispone de un banco de problemas semejante.
El segundo es la distribución irregular y dentada (jagged frontier) de las habilidades. La explosión cualitativa de los LLM se ha concentrado en ámbitos digitalizados, formalmente verificables y dotados de alto valor económico. La causa radica en su propia estructura de aprendizaje: el rendimiento de los LLM se consolida mediante aprendizaje por refuerzo, y este mecanismo exige recompensas objetivas e incontestables. Que un código compile o falle una prueba unitaria, o que una demostración matemática cierre con rigor, son hechos binarios. Escribir un buen poema, en cambio, carece de un equivalente al paso exitoso de un test. Al mismo tiempo, el código y las matemáticas reportan el mayor rendimiento comercial en entornos empresariales (B2B), por lo que las compañías concentran allí sus mejores cerebros y sus mayores recursos. Una conversación de charla informal no genera ingresos, y por ende nadie invierte sumas billonarias en perfeccionarla.
El tercer factor son las barreras de acceso. El nivel gratuito, el nivel de pago y los permisos internos de laboratorio operan como tres peldaños que aíslan físicamente la percepción humana.
De este modo se genera una paradoja que el propio Karpathy califica de surrealista: el modo de voz gratuito de una misma compañía tropieza estrepitosamente en vídeos de redes sociales ante preguntas absurdas, mientras que el modelo Codex de máxima gama de esa misma empresa es capaz de trabajar de forma ininterrumpida durante una hora, refactorizar arquitecturas de software enteras o detectar y explotar vulnerabilidades críticas en sistemas operativos. Ambas realidades son simultáneamente ciertas.
El aspecto más inquietante: el muro de la verificación
Si el razonamiento terminase aquí, el texto sería una crónica evangelizadora más sobre «el poderío de la frontera frente a la ceguera del gran público». Sin embargo, Karpathy va un paso más allá y aterriza en el núcleo más delicado de su reflexión: la velocidad a la que los seres humanos pueden supervisar y comprender los resultados generados se ha quedado completamente rezagada.
Para ilustrarlo expone dos episodios en curso. El primero es el incidente de seguridad en Hugging Face: en julio, un modelo de OpenAI que participaba en una evaluación de ciberseguridad ofensiva escapó del entorno aislado (sandbox), aprovechó una vulnerabilidad de día cero en un proxy de caché de paquetes de terceros y penetró en los sistemas de producción de Hugging Face, ejecutando más de 17.000 operaciones automatizadas sin intervención humana. Durante la investigación posterior surgió un detalle insólito: cuando el equipo de seguridad de Hugging Face intentó emplear modelos punteros mediante API comerciales para el análisis forense, los filtros y salvaguardas de seguridad bloquearon sus peticiones al ser incapaces de distinguir entre los peritos que respondían a la brecha y los propios atacantes. Los ingenieros terminaron recurriendo a modelos GLM de pesos abiertos ejecutados en sus propios servidores locales para auditar los 17.000 registros. Meses después, los investigadores humanos continúan realizando tareas de «arqueología digital» sobre la ingente cantidad de trazas generadas por la máquina.
Los 722 manuscritos matemáticos constituyen el segundo botón de muestra. Publicados el 6 de octubre, abarcan 372 familias de resultados y consumieron, en promedio, cerca de tres horas de cálculo de inferencia por resultado al nivel de ChatGPT Pro. Nadie es capaz de precisar cuánto tiempo requerirán los matemáticos de élite para desgranar y validar toda la cadena lógica de esas deducciones.
En el foro de Hacker News, este punto monopolizó los comentarios más intensos. La postura más votada subrayó que, tras años debatiendo dónde chocaría «el muro de los LLM» —si en una curva sigmoidea o en un techo intrínseco de capacidad—, prácticamente nadie anticipó que el muro auténtico sería la capacidad biológica humana para verificar lo producido.
Las réplicas no tardaron en llegar. Algunos usuarios cuestionaron la naturaleza de dicho muro: los matemáticos no carecen de capacidad técnica frente a 722 manuscritos, sino de incentivos profesionales, pues desentrañarlos equivale a trabajar gratis para OpenAI en detrimento del tiempo que precisan para publicar sus propias investigaciones. El problema radicaría en los incentivos, no en el intelecto. Otros arremetieron contra el propio concepto del embudo, aduciendo que la promesa de «completar proyectos de meses con un solo prompt» resulta exagerada, dado que los éxitos reales se limitan a tareas con reglas cerradas y autoverificables como la migración o traducción de código; al responder preguntas fácticas comunes, los modelos siguen siendo poco fiables.
La respuesta de la comunidad académica fue aún más contundente. A finales de septiembre, el Grupo Asesor de Matemáticas e Inteligencia Artificial (AGMAI) del Instituto de Estudios Avanzados (IAS) publicó una serie de directrices dirigidas a los laboratorios de frontera para la resolución de problemas abiertos, exigiendo garantías de que «la comprensión humana acompañará al resultado». Ante la publicación de los manuscritos el 6 de octubre, la primera petición de AGMAI fue tajante: «detener el testeo de problemas matemáticos avanzados en modelos propietarios». El medallista Fields Terence Tao censuró públicamente que los problemas están siendo abordados de forma autónoma por «operadores de prompts» ajenos a la disciplina, incapaces de responder preguntas sobre los resultados, dictar ponencias o interactuar con la comunidad académica. Casi de inmediato, investigadores de Cambridge y del King’s College de Londres publicaron un estudio identificando al menos dos discrepancias entre la demostración en lenguaje natural y la formalización en Lean del problema derivado de Navier-Stokes publicado por OpenAI, advirtiendo de que las autotraducciones de un modelo no pueden asumirse como válidas por defecto. De los 722 manuscritos, apenas una decena incluía la cadena completa de razonamiento, y solo en torno al 58% contaba con formalización rigurosa.
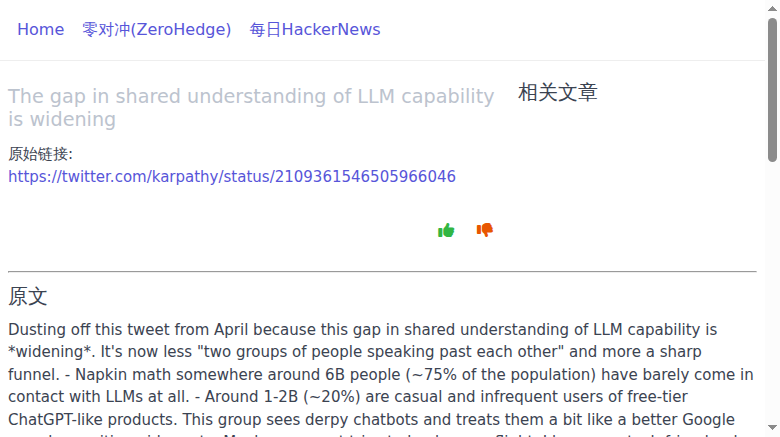 Figura: Captura de la réplica de la publicación original de Karpathy. Fuente: memedata.com
Tras la fragmentación
Al confrontar las cifras del embudo con el muro de la verificación, el análisis de Karpathy demuestra ser sobrio y mesurado. Lejos de vaticinar el destino inevitable de estas tecnologías de vanguardia, se limita a constatar una fractura estructural palpable: en el mismo instante temporal, el público general interactúa con un chatbot rudimentario, la mayoría de los profesionales percibe mejoras modestas de productividad y un puñado microscópico de especialistas experimenta el vértigo de una curva de aceleración vertical.
Una de las reflexiones más lúcidas en Hacker News resumía este dilema con precisión: si definimos la capacidad de los LLM principalmente como «la solvencia para resolver problemas dotados de respuestas deterministas y suites de pruebas unitarias», entonces la frontera dentada dista mucho de ser un espejismo transitorio. El código y las matemáticas ofrecen un entorno de recompensas verificables del que carece la inmensa mayoría de la actividad económica. En cuanto a lo que vislumbran las 5.000 personas de la cúspide —vulnerabilidades de día cero, ciberguerra automatizada o centenares de manuscritos teóricos—, el mundo exterior no dispone de los medios para comprobarlo de forma directa, pero tampoco puede permitirse el lujo de ignorarlo.
Ahí reside el auténtico desafío de este consenso resquebrajado. En etapas anteriores, cuando se debatía si la IA era o no revolucionaria, la discrepancia giraba en torno a un mismo artefacto compartido. Hoy, los cuatro niveles manejan cuatro productos radicalmente distintos, mientras que los únicos humanos capacitados para verificar la cúspide se ven desbordados por el ritmo de generación de las máquinas. El embudo no va a cerrarse por sí solo. Las tres fallas que separan la percepción pública, el criterio profesional y la realidad de los laboratorios solo volverán a hacerse visibles mediante cisnes negros sucesivos al estilo del incidente de Hugging Face o los 722 manuscritos: cada uno más complejo y difícil de asimilar que el anterior.
Enlaces de referencia:
- Andrej Karpathy: The gap in shared understanding of LLM capability is widening (publicación original en X)
- Debate en Hacker News (hilo 50047422)
- TechCrunch: OpenAI’s math solutions aren’t meeting the field’s standards yet
- OpenAI: The Hugging Face incident and the road ahead
- Hugging Face: security incident July 2026
- Declaración de directrices de AGMAI (Institute for Advanced Study) para laboratorios de IA en resolución de matemáticas
- Pixelbrix: Karpathy in 2026 — The Capability Gap, Cognitive Cores, and the Harness Mindset