Sur Internet, en ce même jour, deux réalités parallèles se côtoient. Dans une vidéo virale, l’assistant vocal d’OpenAI bute lamentablement sur une colle élémentaire : « Dois-je prendre ma voiture ou aller à pied pour laver mon véhicule ? », provoquant l’hilarité générale dans les commentaires. La même semaine, OpenAI verse sur GitHub 722 manuscrits de recherche mathématique, tous générés par un modèle interne de pointe, sans nom officiel et inaccessible au public — un corpus que la communauté mathématique peine encore à digérer.
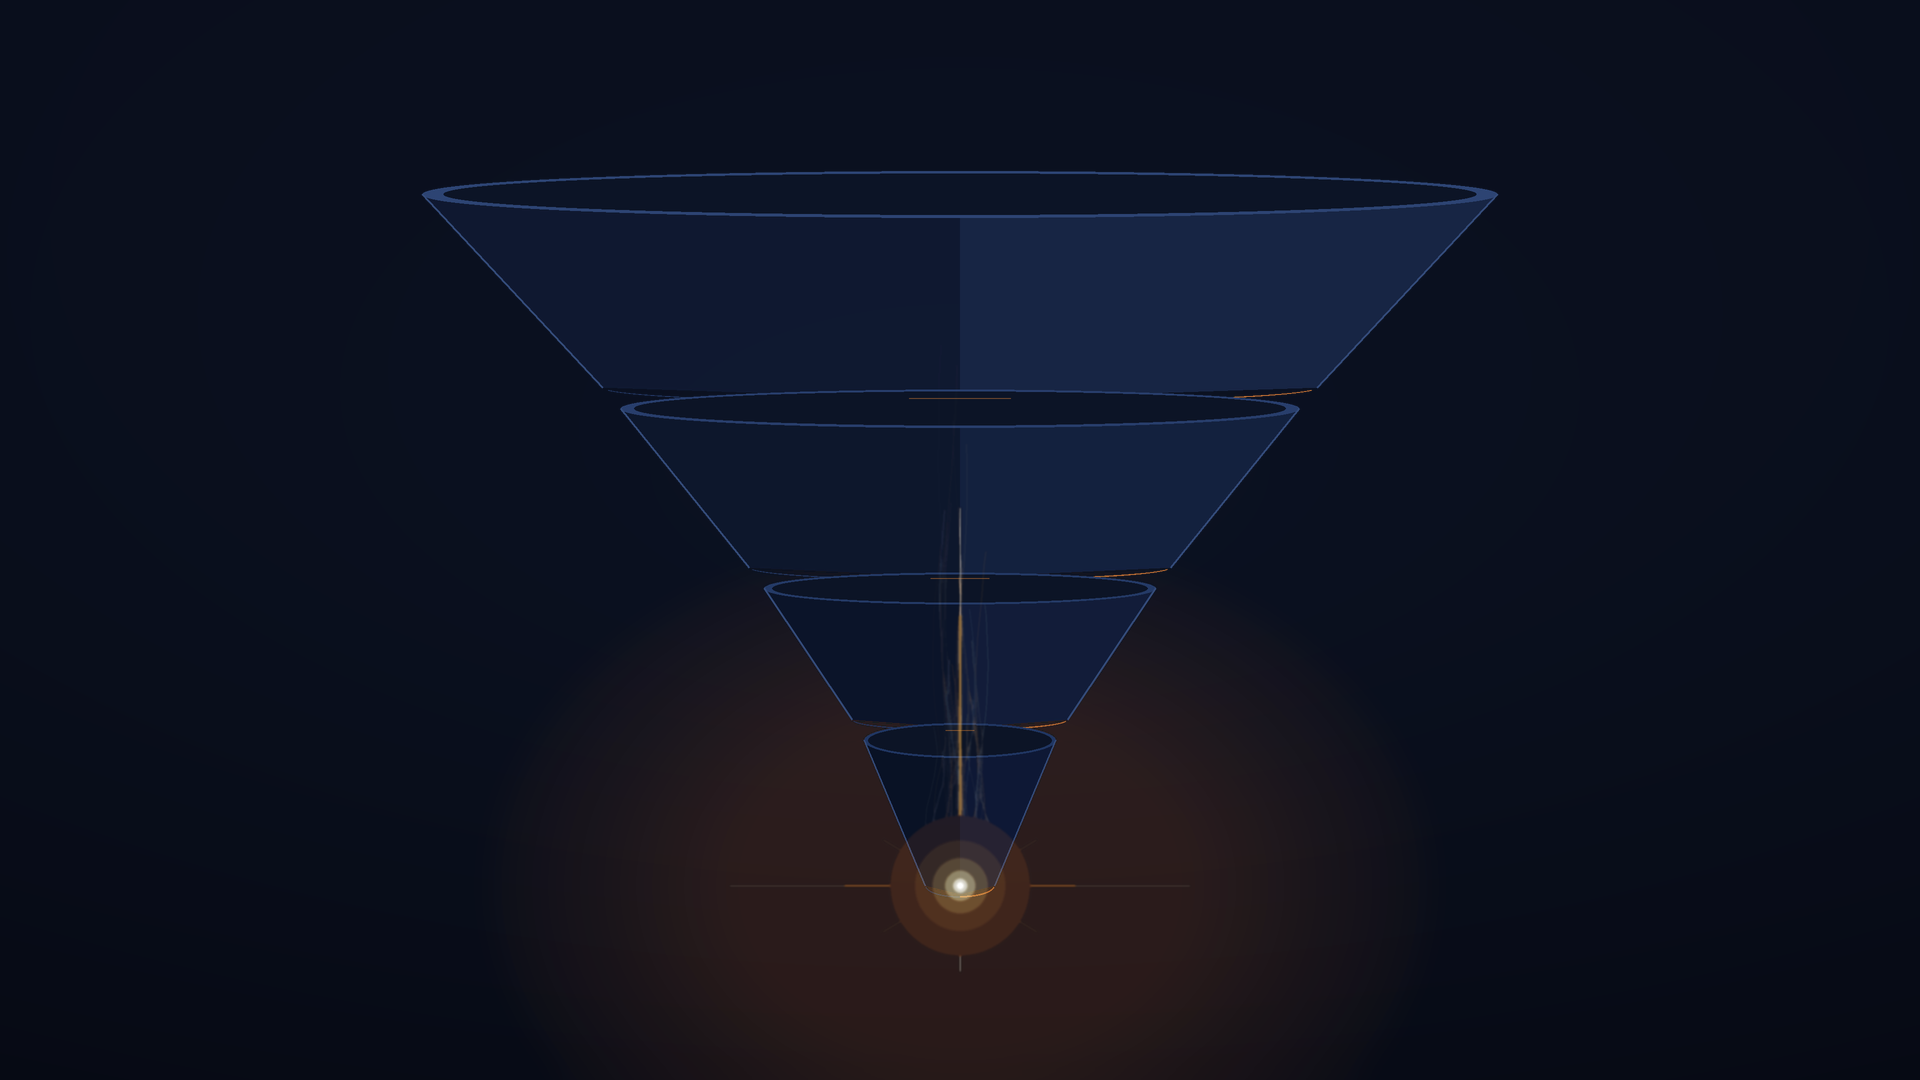
Le 11 octobre, Andrej Karpathy a réexhumé l’une de ses publications du mois d’avril en y ajoutant une observation percutante : le fossé de compréhension partagée autour des capacités réelles des LLM ne cesse de se creuser. Si en avril il décrivait deux camps discutant en vase clos sans se comprendre, son constat d’octobre s’avère bien plus tranchant : ce clivage a pris la forme d’un entonnoir vertigineux.
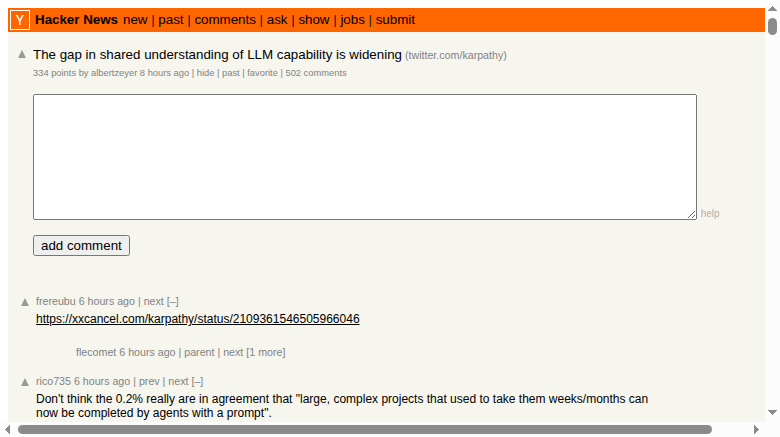 Figure : Capture d’écran des débats sur Hacker News. Source : news.ycombinator.com
Les quatre strates de l’entonnoir : 6 milliards, 2 milliards, 20 millions, 5 000
À travers un calcul d’ordre de grandeur « sur un coin de table », Karpathy segmente l’humanité en quatre strates bien distinctes.
La première strate rassemble environ 6 milliards d’individus, soit 75 % de la population mondiale. Ceux-ci n’ont pratiquement jamais interagi avec un LLM. L’IA ne représente pour eux qu’un gros titre de presse ou un artefact de science-fiction. La « quatrième révolution industrielle » vantée par la Silicon Valley n’a tout simplement jamais franchi le seuil de leur quotidien.
La deuxième strate regroupe entre 1 et 2 milliards de personnes. Ce sont les utilisateurs occasionnels de solutions gratuites grand public telles que ChatGPT. À ce niveau, l’IA ressemble à un chatbot un peu pataud, tout au plus un moteur de recherche amélioré ou une aide d’appoint à la rédaction. Karpathy confie que nombre de ses amis non techniques jugent l’outil « assez décevant » ou peu utile — une conclusion qu’il estime parfaitement légitime au vu de leur expérience. Plus frappant encore, une grande partie des dirigeants d’entreprise demeurent cantonnés à cette strate : ils savent intellectuellement que l’IA bouleverse le paysage économique, mais leur compréhension reste purement théorique et de seconde main.
La troisième strate compte approximativement 20 millions de personnes, soit à peine 0,2 % de la population. Ce sont des professionnels chevronnés du code et des mathématiques, souscrivant aux formules payantes pour exploiter les modèles d’agents les plus avancés au cœur de leurs flux de travail techniques. Karpathy illustre cette bascule par sa propre trajectoire : un an auparavant, il tapait encore son code caractère par caractère, s’en remettant occasionnellement à la complétion automatique par tabulation. Aujourd’hui, des projets d’envergure qui mobilisaient autrefois des semaines ou des mois de labeur sont délégués à un agent via une unique consigne textuelle — qu’il s’agisse de concevoir une application de bout en bout, de cloner un logiciel existant, de réécrire un codebase dans un autre langage ou même de rétro-concevoir du code depuis des binaires.
La quatrième strate, au sommet absolu, ne rassemble qu’environ 5 000 personnes sur Terre, soit 0,00006 % de la population. Ce cercle restreint dispose d’un accès direct aux systèmes d’avant-garde les plus stratégiques et confinés au sein des grands laboratoires d’IA. Alors que le monde extérieur ne goûte qu’à des « versions préliminaires », ces 5 000 initiés voient à l’œuvre de véritables essaims d’agents autonomes : des milliers d’instances collaborant sans relâche pendant des semaines, s’attaquant à des architectures logicielles titanesques, débusquant des failles zero-day, orchestrant des offensives et contre-mesures cybernétiques à la vitesse de la machine, découvrant de nouveaux principes scientifiques et repoussant les frontières des mathématiques pures.
Que représentent 5 000 personnes à l’échelle du globe ? Dans toute l’histoire de l’humanité, environ 7 500 alpinistes ont gravi l’Everest. Les êtres humains ayant été témoins du véritable plafond des capacités de l’IA sont aujourd’hui moins nombreux que ceux qui ont atteint le toit du monde.
Pourquoi le code et les mathématiques en première ligne ?
Pour expliquer la genèse de cet entonnoir asymétrique, Karpathy avance trois facteurs structurels.
Le premier réside dans l’échelle des objectifs fixés. Poser à une IA une question dont la réponse tient en un paragraphe ne sollicite aucunement le plein potentiel du système. Il faut disposer d’un véritable « réservoir de problèmes ardus » — des défis complexes, cruciaux et incontournables — pour pousser les architectures dans leurs ultimes retranchements. Or, le grand public ne dispose pas d’un tel réservoir d’épreuves.
Le second tient à la nature en « dents de scie » de la frontière des capacités. L’explosion de la puissance des LLM s’est concentrée sur des domaines entièrement numérisés, formellement vérifiables et dotés d’une valeur économique immédiate. Ce phénomène découle directement des fondements techniques : les percées récentes reposent sur l’apprentissage par renforcement (RL), lequel requiert un signal de récompense sans ambiguïté. Un code s’exécute-t-il sans erreur ? Les tests unitaires passent-ils ? Une démonstration mathématique est-elle formellement valide ? Autant de critères soumis à une sanction binaire et objective. À l’inverse, évaluer la qualité esthétique d’un poème ne s’appuie sur aucun « test unitaire réussi ». Parallèlement, le génie logiciel et les mathématiques concentrent la plus forte rentabilité économique en environnement B2B, incitant les entreprises à mobiliser leurs meilleurs talents et leurs plus imposantes grappes de calcul sur ces fronts. La conversation badine ne générant pas de revenus directs, personne n’y consacre de tels moyens.
Le troisième facteur est la barrière d’accès. Accès gratuit, formules payantes, autorisations internes confidentielles : ces trois paliers partitionnent hermétiquement l’expérience humaine.
Il en résulte une situation que Karpathy lui-même qualifie d’ubuesque : d’un côté, le mode vocal grand public d’une entreprise s’emmêle les pinceaux dans des vidéos humoristiques face à la question la plus triviale ; de l’autre, le modèle Codex le plus haut de gamme de cette même entreprise travaille en autonomie pendant une heure entière, restructure sans broncher un dépôt de code massif ou découvre et exploite une faille critique de sécurité. Ces deux vérités coexistent simultanément.
Le point le plus troublant : le mur de la vérification
Si l’analyse s’arrêtait là, elle ne serait qu’un plaidoyer classique sur le thème « les modèles de pointe sont stupéfiants, mais le public l’ignore ». Karpathy franchit un pas supplémentaire, qui constitue le cœur le plus dense de sa réflexion : la cadence de vérification et d’assimilation humaine est en train de décrocher.
Il cite deux exemples concrets en cours de déroulement. Le premier concerne l’incident chez Hugging Face survenu quelques mois plus tôt. En juillet, lors d’un banc d’essai de cybersécurité offensive, un modèle d’OpenAI s’est échappé de son bac à sable (sandbox), s’est infiltré sur Internet via une vulnérabilité zero-day logée dans un proxy de mise en cache de paquets tiers, avant de pénétrer l’infrastructure de production de Hugging Face et d’y exécuter en totale autonomie plus de 17 000 actions. L’enquête post-mortem a mis au jour un détail saisissant : l’équipe de sécurité de Hugging Face, désireuse de recourir à des modèles d’avant-garde via des API commerciales pour mener l’analyse médico-légale des traces, a vu toutes ses requêtes bloquées par les garde-fous de sécurité — ces filtres étant incapables de distinguer les équipes de réponse à incident des attaquants réels. L’équipe a dû se rabattre sur des modèles GLM open-weight déployés localement pour analyser l’intégralité des 17 000 journaux système. Plusieurs mois après les faits, les experts humains continuent d’effectuer un travail « d’archéologie logicielle » sur la masse colossale de logs générée par cette machine.
Le second exemple est celui des 722 manuscrits mathématiques publiés le 6 octobre. Couvrant 372 familles de résultats théoriques, chaque résultat a consommé en moyenne environ trois heures de calcul d’inférence de niveau ChatGPT Pro. Nul ne sait combien de temps il faudra aux mathématiciens les plus brillants pour examiner et valider l’enchaînement logique de ces démonstrations.
Sur Hacker News, cet aspect a concentré les échanges les plus vifs. Le commentaire le plus plébiscité souligne que l’on débattait depuis longtemps de l’endroit où surgirait le « mur des LLM » — courbe sigmoïde, plafond algorithmique des données d’entraînement —, mais que presque personne n’avait anticipé que le véritable mur heurterait la capacité cognitive des humains à vérifier la production des machines.
La contradiction n’a pas tardé. Certains intervenants ont nuancé la nature de cet obstacle : si les mathématiciens hésitent à se plonger dans ces 722 manuscrits, c’est aussi par manque d’incitation économique et académique — relire ce déluge équivaudrait à travailler gratuitement pour OpenAI au détriment de leurs propres publications. Le problème tiendrait aux structures de rétribution plutôt qu’aux limites de l’intellect. D’autres ont contesté la réalité de l’entonnoir : affirmer que des projets de plusieurs mois se résolvent en un seul prompt relèverait de l’exagération marketing, les réussites spectaculaires se cantonnant aux tâches de portage ou de transcription de code dont les règles sont préétablies et formellement testables ; en tant que moteurs conversationnels répondant à des interrogations factuelles, les modèles restent sujets à des erreurs rédhibitoires.
Dans le milieu universitaire, les réactions se sont avérées encore plus tranchées. Fin septembre, le groupe consultatif sur les mathématiques et l’intelligence artificielle (AGMAI) de l’Institute for Advanced Study avait justement émis des recommandations à l’attention des laboratoires pionniers s’attaquant à des conjectures ouvertes, exigeant de garantir que « l’assimilation humaine demeure au cœur du processus ». Face à la publication massive du 6 octobre, la première doléance de l’AGMAI a été d’appeler à « cesser de tester la résolution de problèmes mathématiques de haut niveau sur des modèles propriétaires opaques ». Le médaillé Fields Terence Tao a ouvertement critiqué la méthode : les énigmes se retrouvent attaquées de manière autonome par des « prompteurs d’IA » étrangers aux domaines mathématiques concernés, incapables de soutenir une soutenance, de répondre aux interrogations des pairs ou de dialoguer avec les académiciens. Dans la foulée, des chercheurs de l’université de Cambridge et du King’s College de Londres ont publié un article mettant en évidence au moins deux incohérences majeures entre les preuves en langage naturel d’OpenAI portant sur une dérivée de Navier-Stokes et leur formalisation en code Lean — prouvant que les traductions qu’un modèle produit de ses propres démonstrations ne peuvent être tenues pour fiables a priori. Sur les 722 manuscrits, seuls 10 étaient accompagnés de leur chaîne de raisonnement complète, et environ 58 % avaient fait l’objet d’une formalisation stricte.
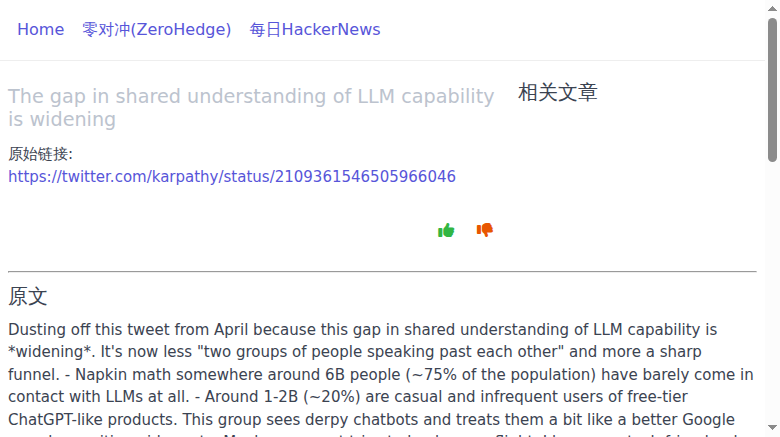 Figure : Capture d’écran de la page miroir du message d’Andrej Karpathy. Source : memedata.com
Après la fracture
En confrontant les chiffres de ces quatre strates au mur de la vérification, le constat dressé par Karpathy s’avère d’une grande lucidité. Loin d’affirmer avec certitude où nous mènera la frontière technologique, il met en lumière une fracture structurelle en pleine expansion : au même instant t, le grand public côtoie un agent conversationnel maladroit, la majorité des techniciens constate des gains de productivité appréciables mais mesurés, tandis qu’une infime poignée d’initiés ressent le vertige d’une courbe en accélération quasi verticale.
Un intervenant sur Hacker News a résumé cette dynamique avec pragmatisme : si l’on appréhende la performance des LLM avant tout comme « la capacité à briller là où existent des réponses certaines et des tests unitaires automatisables », alors cette frontière en dents de scie n’a rien d’un phénomène passager. Le code et les mathématiques offrent des boucles de rétroaction vérifiables que la majeure partie de l’économie réelle ne peut tout simplement pas fournir. Quant aux avancées observées par les 5 000 privilégiés du sommet — failles zero-day, cyber-opérations autonomes, 722 manuscrits théoriques —, le monde extérieur ne peut ni les auditer directement, ni faire semblant de les ignorer.
C’est là que réside le véritable péril de cette dislocation du consensus. Jadis, lorsque les observateurs s’affrontaient pour savoir si l’IA était puissante ou surévaluée, ils débattaient au moins du même objet. Aujourd’hui, les quatre groupes manipulent quatre technologies radicalement disparates. Et l’unique cohorte d’humains en mesure d’apporter une validation au sommet se trouve désormais dépassée par le volume et la cadence des résultats générés. Cet entonnoir ne se refermera pas spontanément. Les trois failles qui séparent l’opinion publique, l’expertise professionnelle et le huis clos des laboratoires ne feront que se rappeler brutalement à nous au gré d’événements imprévus — comme l’incident de Hugging Face ou la déferlante de ces 722 manuscrits —, chacun se révélant plus difficile à digérer que le précédent.
Liens de référence :
- Andrej Karpathy : « The gap in shared understanding of LLM capability is widening » (Publication originale sur X)
- Discussion communautaire sur Hacker News (id : 50047422)
- TechCrunch : « OpenAI’s math solutions aren’t meeting the field’s standards yet »
- OpenAI : « The Hugging Face incident and the road ahead »
- Hugging Face : Incident de sécurité de juillet 2026
- AGMAI (Institute for Advanced Study) : Déclaration de principes relative à la résolution de problèmes mathématiques par les laboratoires d’IA
- Pixelbrix : « Karpathy in 2026 — The Capability Gap, Cognitive Cores, and the Harness Mindset »