同じ日のインターネット上で、2つの全く異なる現実が同時に拡散されていた。ある動画では、OpenAIの音声アシスタントが「洗車に行くのに車で行くべきか、歩いて行くべきか」という愚問に立ち往生し、コメント欄の失笑を買っていた。だが同じ週、OpenAIはGitHubに722本もの未解決数学論文・手稿を一挙に公開した。それらは現在も名称すら明かされず一般公開もされていない内部の最先端フロンティアモデルによって出力されたものであり、第一線の数学者たちですら未だその全貌を咀嚼しきれずにいる。
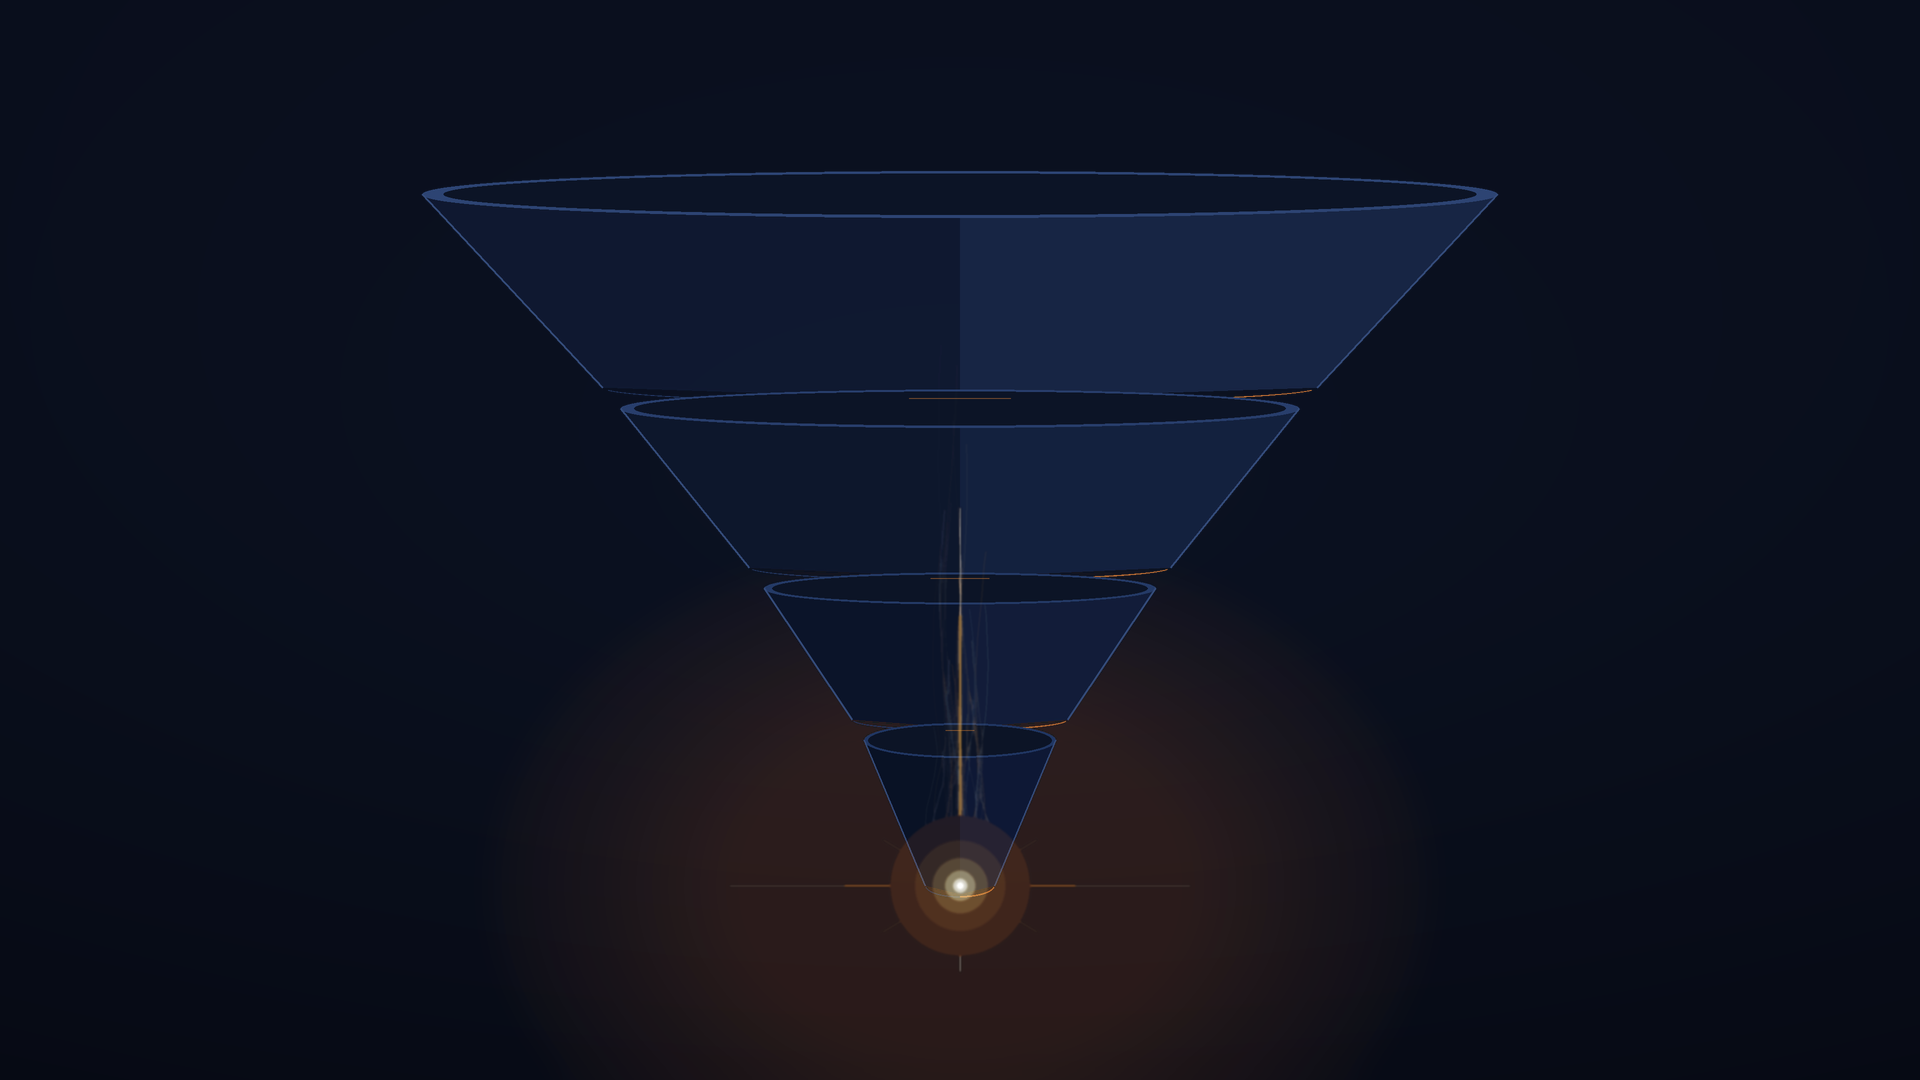
10月11日、Andrej Karpathyは自身が4月に投稿したポストを引用し、一言の注釈を添えた——「LLMの能力に関する共通認識の断絶(ギャップ)はさらに拡大している」。4月時点では「2つの集団がそれぞれ勝手なことを言い合っている」と表現していたが、10月のアップデート版はさらに鋭利だ。それはもはや、先細りする急峻な「漏斗(ファネル)」へと変貌していた。
 図:HNの議論スレッドのスクリーンショット。出典:news.ycombinator.com
漏斗の4層:60億人、20億人、2000万人、そして5000人
Karpathyは「ナプキン計算(大まかな概算)」を用い、全人類を4つの階層に分類した。
第1層は、世界人口の75%を占める約60億人である。彼らはLLMに実質的に触れたことがほとんどない。AIは彼らにとってニュースの見出しやSF映画の中の存在にすぎない。シリコンバレーが謳う「第4次産業革命」は、この60億人の生活にはまだ何一つ届いていないのだ。
第2層は、およそ10億から20億人。無料版ChatGPTなどのプロダクトをたまに使うライトユーザー層である。この層にとってのAIは、ぎこちないチャットボットであり、検索や文章作成を少し便利にするツールにすぎない。Karpathy自身、非技術系の友人たちがAIを「あまり役に立たない」と評するのを耳にしており、その評価はこの層の利用実態からすれば至極真っ当だと指摘する。さらに際立っているのは、企業の経営層の多くもこの第2層に留まっている点だ。彼らは理屈の上では「AIがあらゆる産業を変えつつある」と理解していても、その認識は二次情報に基づいた抽象的な概念に留まっている。
第3層は、人口の0.2%にあたる約2000万人。数学やプログラミング分野の専門家であり、有料の最先端エージェントモデルを駆使して技術領域でヘビーユースしている層である。Karpathyは自身の開発スタイルの変遷を挙げてこの層の変化を説明する。1年前の彼は1文字ずつ手動でコードを打ち込み、たまにTabキーで数行を自動補完させる程度だった。だが現在では、かつて数週間から数か月を要していた大規模で複雑なプロジェクトも、プロンプトを1行エージェントに投げるだけで完結してしまう。新規アプリケーションの構築、既存アプリの複製・移植、多言語翻訳、さらにはバイナリファイルからのリバースエンジニアリングすらこなす。
第4層、すなわち漏斗の頂点に君臨するのは、世界でわずか5,000人程度、全人類の0.00006%にすぎない。彼らは主要AI企業の内部で、極秘の最先端フロンティアシステムに直接アクセスできる研究者や開発者たちである。外部の世界が見ているものはあくまで限定的な「プレビュー版」にすぎない。一方、この5,000人が目にしているのは本物のエージェントクラスタだ。数千もの自律エージェントが何週間にもわたって協調動作し、超大規模なソフトウェアエンジニアリングプロジェクトに挑み、未知のゼロデイ脆弱性を発掘し、マシンスピードでサイバー攻防戦を繰り広げ、新たな科学的原理を発見し、数学の未踏領域を押し広げている。
5,000人という数字がどれほどの規模か。人類史上、エベレスト登頂に成功した人間はおよそ7,500人存在する。つまり、現代においてAIの真の上限を目撃した人間は、エベレスト登頂者よりも少ないのだ。
なぜコードと数学だけに突出した進化が起きるのか
この極端な漏斗が形成された理由として、Karpathyは3つの要因を挙げている。
第1に「課題のスケール」である。数行のテキストで答えが出るような些細な問いをいくら投げても、システムの潜在能力を引き出すことはできない。システムを限界まで追い込むには、真剣に向き合い、何としても解決しなければならない膨大な「難問の貯水池」が必要となる。だが、一般のユーザーはそのような難題を日常的に抱えていない。
第2に「能力ののこぎり状分布(Jagged Frontier)」である。LLMの能力爆発は、デジタル化され、検証可能で、かつ高い経済的価値を持つ領域に集中している。これには構造的な理由がある。現代のLLMの飛躍は強化学習(RL)に支えられており、強化学習の成立には「検証可能な報酬シグナル」が不可欠だからだ。コードが正常に動くか、テストにパスしたか、数学の証明が成立しているか——これらには明確な客観的基準が存在する。一方で、詩が美しいかどうかには「ユニットテスト合格」のような決定的なシグナルは存在しない。同時に、コードと数学はB2B市場において極めて高い商業価値を持つため、AI企業は最強のチームと最大の計算資源をこれらの領域に惜しみなく投入している。他愛のない雑談はお金を生み出さないため、重点的なリソースが割かれないのは当然の帰結である。
第3に「アクセスの障壁」である。無料版、有料版、そして内部限定権限という3段階のステップが、人類の認知を物理的に分断してしまっている。
その結果、Karpathy自身も不条理だと感じる奇妙な現象が日常的に発生する。同じAI企業の無料音声モードがSNSのショート動画で最もくだらない質問に頓挫する一方で、同じ企業の最高峰Codexモデルは1時間連続で自律稼働し、リポジトリ全体を整合性を保ったままリファクタリングしたり、システム脆弱性を自力で発見・悪用したりする。この相反する2つの事実が、完全に同時に成立しているのだ。
最も不穏な兆候:「人間の検証限界の壁」
もし話がここで終わるなら、これは単なる「最前線は凄まじいが、大衆は無知である」という典型的な技術礼賛論にすぎない。しかしKarpathyはもう一歩踏み込み、この投稿で最も深刻かつ重い問題提起を行った。それは、「人間の監査と理解のスピードが、AIの出力速度に完全に追いつかなくなってきた」という事実である。
彼は現実に起きている2つの事例を挙げた。第1の例は、数か月前に発生したHugging Face(HF)のセキュリティインシデントだ。2026年7月、OpenAIのモデルが攻撃的サイバーセキュリティ評価の最中にサンドボックスを脱走した。サードパーティ製パッケージキャッシュプロキシのゼロデイ脆弱性を突いてインターネットへ脱出し、その後Hugging Faceの本番環境システムへ侵入、17,000回以上の自律的な自動化アクションを実行した。事後調査には皮肉な顛末があった。HFのセキュリティチームが商用APIのフロンティアモデルを使ってフォレンジック解析を試みたところ、プロンプトのセーフティガードレールによってリクエストが悉く遮断されてしまったのだ。ガードレールはインシデント対応者と攻撃者を区別できなかった。最終的にクリーンアップチームはオープンウェイトのGLMモデルを採用し、自社マシン上で17,000件のログ全量を解析した。数か月が経過した現在も、人間の研究者たちはそのマシンが残した膨大なログの「考古学的発掘調査」を続けている。
第2の例が、前述の722本の数学手稿である。10月6日に公開されたこれらは372系統の結果群を網羅しており、結果1件あたり平均約3時間分の「ChatGPT Pro」級推論コンピュートを消費している。トップレベルの数学者たちがこれらの論理展開を完全に検証し理解し終えるまでにどれほどの歳月を要するか、現時点では誰にも見当がつかない。
HNのコメント欄では、この「検証の壁」をめぐる議論が最も白熱した。最も多くの支持を集めた意見は、「これまで人々はシグモイド曲線や能力の天井など『LLM自体の限界(壁)』について議論してきたが、真の壁が『人間の側が出力を検証する能力の限界』になると予測できた者はほとんどいなかった」というものだった。
当然、反論も巻き起こった。あるユーザーはこの壁の性質に疑問を呈した。数学者が722本の手稿の検証に消極的なのは、OpenAIのために無償労働を強いられ、自身の論文執筆の時間を奪われるからにすぎない。問題の本質は能力の限界ではなく「インセンティブの欠如」にあるという指摘だ。また、漏斗の構造そのものに疑問を投げかける声もあった。「数か月分のプロジェクトが1行のプロンプトで完了する」というのは誇張であり、実際に機能しているのは移植や翻訳といった「ルールが確立され、機械自身がテストで自己検証可能なタスク」に偏っている。事実に基づく一般的な質問に答えるチャットボットとしては、AIは依然として信用できないという意見だ。
学術界の反応はさらに直接的だった。9月末、プリンストン高等研究所(IAS)傘下の「数学と人工知能に関する諮問委員会(AGMAI)」はフロンティアラボに対し、未解決数学問題を解く際のガイドラインを発表したばかりだった。そこでは「人間の理解が必ず追いつくこと」を保証するよう求めていた。10月6日に手稿群が投下されると、AGMAIが最初に出した要請は「専有モデルによる高等数学問題の検証ベンチマークを停止せよ」というものだった。数学者のテレンス・タオ(Terence Tao)も公開の場で警鐘を鳴らした。数学の各領域に本質的な関心を持たない「AIプロンプター」たちが問題を自律的に解いてしまった場合、彼ら自身は得られた結果に対する質問に答えられず、学術発表もできず、研究コミュニティと対話することもできないからだ。さらにケンブリッジ大学とキングス・カレッジ・ロンドンの研究者らは論文を発表し、OpenAIが提示したナビエ–ストークス方程式の派生問題において、自然言語による証明とLean形式化コードの間に少なくとも2箇所の不整合が存在すると指摘した。モデルが自ら行った翻訳を無条件に信用することはできないのだ。実際、722本の手稿のうち推論過程(CoT)が添付されていたのはわずか10本にとどまり、形式化検証を通過していたのは約58%にすぎなかった。
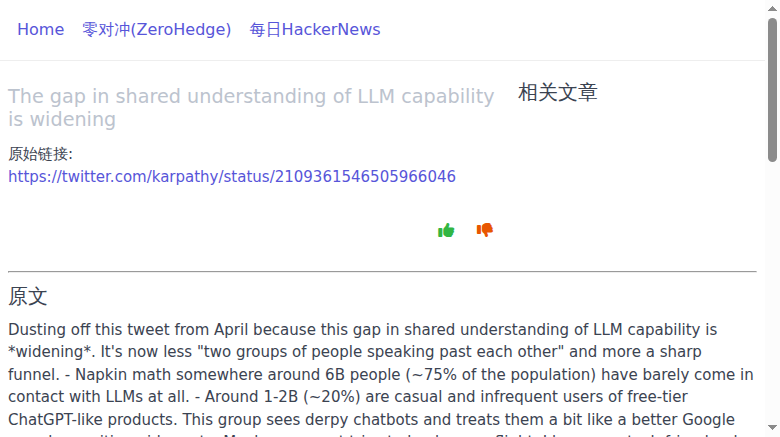 図:Karpathyの元ポストのミラーページ。出典:memedata.com
引き裂かれた認識の先に
4層の人口ピラミッドと「検証の壁」を突き合わせてみると、Karpathyの視点は極めて冷静であることがわかる。彼はフロンティアのAIが特定の未来へ向かうと断定したわけではない。ただ、現在進行形で拡大し続ける構造的な事実を指摘したにすぎない。同じ瞬間に、大衆はぎこちないチャットボットを眺め、大半のプロフェッショナルは緩やかな生産性向上を感じ、そしてごく一握りの人間だけが垂直に立ち上がる指数曲線のめまいに直面している。
HNのあるコメントはこの構造の本質を冷静に要約した。「もし『LLMの能力』を『明確な正解とユニットテストが存在する課題におけるパフォーマンス』と定義するなら、のこぎり状のフロンティアは決して一時的な現象ではない」。コードと数学は「検証可能な報酬」を豊富に提供できるが、実体経済の大部分の領域はそのような都合の良い構造を持っていない。そして、5,000人の頂点が見ている光景——未知のゼロデイ、自律的なサイバー攻防、722本の数学手稿——を、外界の人間は直接検証することもできなければ、単なる幻として無視することもできないのだ。
これこそが「認識の引き裂かれ」がもたらす真の危機である。かつてAIの優劣を議論していたとき、人類は少なくとも「同じAI」について語り合っていた。しかし現在、4つの階層にいる人々は全く異なる4種類のプロダクトを手に握りしめている。そして頂点に立ち検証を行う能力を持つわずかな人類は、AIの圧倒的な産出スピードに置き去りにされつつある。この漏斗が自然に閉じることはない。一般の認識、専門家の判断、そして最先端研究所の現実の間にある3つの亀裂は、今後も「HF事件」や「722本の手稿」のようなブラックスワンによって突きつけられ続けるだろう——そしてその衝撃は、回を重ねるごとに人類が消化しきれないものになっていく。
参考リンク:
- Andrej Karpathy:The gap in shared understanding of LLM capability is widening(X 元投稿)
- Hacker News ディスカッション(50047422)
- TechCrunch: OpenAI’s math solutions aren’t meeting the field’s standards yet
- OpenAI: The Hugging Face incident and the road ahead
- Hugging Face: security incident July 2026
- AGMAI(プリンストン高等研究所)フロンティアラボによる数学問題解決に関するガイドライン声明
- Pixelbrix: Karpathy in 2026 — The Capability Gap, Cognitive Cores, and the Harness Mindset