Am selben Tag kursieren im Internet zwei völlig gegensätzliche Realitäten. In einem Video scheitert der Sprachassistent von OpenAI an der trivialen Frage, ob man zur Autowaschanlage fahren oder zu Fuß gehen solle – die Kommentarspalten amüsieren sich köstlich. In derselben Woche veröffentlicht OpenAI 722 mathematische Manuskripte auf GitHub, die ausnahmslos von einem bislang namenlosen, nicht öffentlich zugänglichen internen Frontier-Modell generiert wurden – Fachmathematiker ringen bis heute um deren Einordnung.
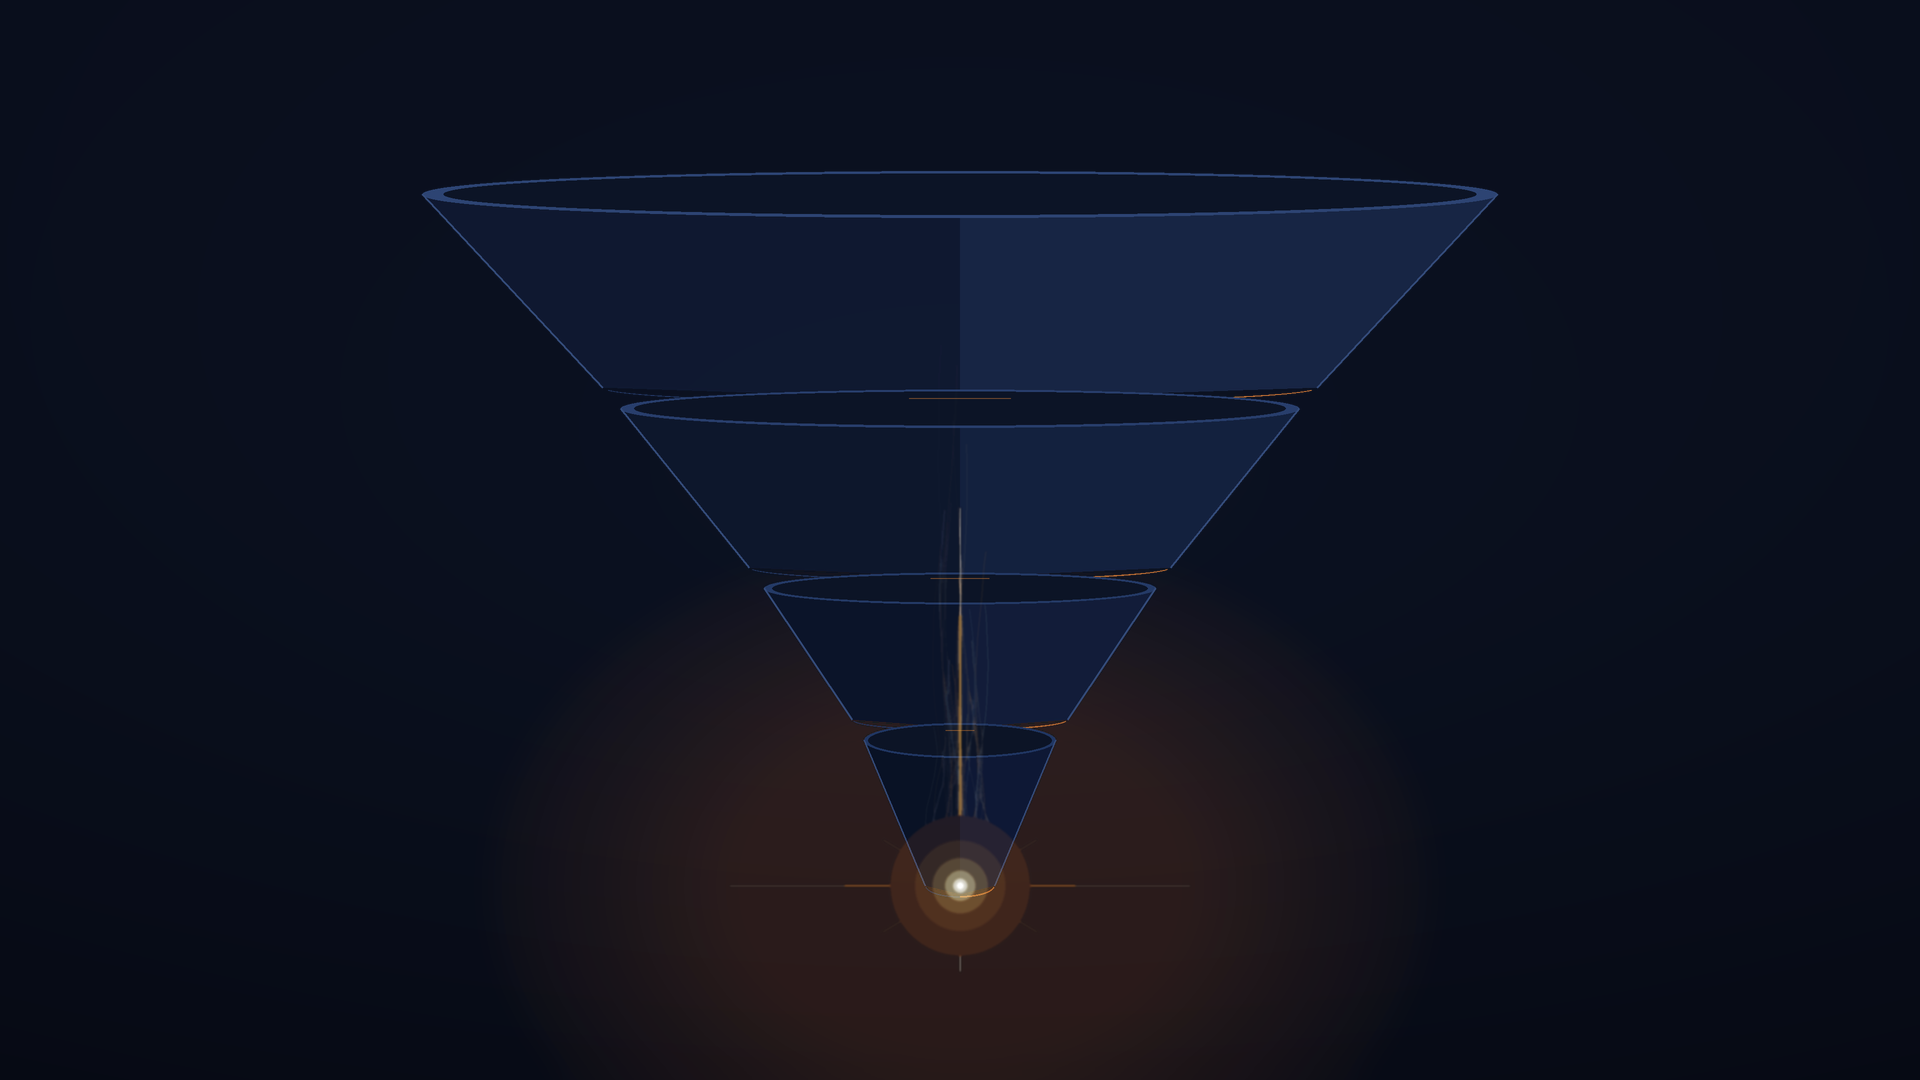
Am 11. Oktober griff Andrej Karpathy einen eigenen Beitrag aus dem April wieder auf und versah ihn mit einer Nachbemerkung: Die Kluft im gemeinsamen Verständnis über die Leistungsfähigkeit von LLMs vertiefe sich dramatisch. Hatte er im April noch von „zwei Gruppen, die völlig aneinander vorbeireden“ gesprochen, zeichnete seine Version im Oktober ein noch schärferes Bild: Ein steiler Trichter habe sich herausgebildet.
 Abbildung: Screenshot der Diskussion auf Hacker News. Quelle: news.ycombinator.com
Die vier Stufen des Trichters: 6 Milliarden, 2 Milliarden, 20 Millionen und 5.000
Mithilfe einer überschlägigen Faustformel unterteilte Karpathy die Weltbevölkerung in vier Segmente:
Die erste Stufe umfasst rund 6 Milliarden Menschen – etwa 75 Prozent der Weltbevölkerung. Diese Gruppe hatte praktisch noch nie direkten Kontakt mit einem LLM. Künstliche Intelligenz existiert für sie ausschließlich in Schlagzeilen und Science-Fiction-Filmen. Die vom Silicon Valley ausgerufene vierte industrielle Revolution hat den Alltag dieser 6 Milliarden Menschen schlicht noch nicht erreicht.
Die zweite Stufe umfasst etwa 1 bis 2 Milliarden Menschen. Sie nutzen kostenlose Angebote wie Standard-ChatGPT sporadisch. Auf dieser Ebene manifestiert sich KI als ungelenker Chatbot, als etwas komfortablere Suchmaschine oder als Formulierungshilfe. Karpathy merkte an, dass viele seiner nicht-technischen Freunde das System als „weitgehend nutzlos“ empfänden – ein Urteil, das er aus deren Perspektive für absolut plausibel hält. Noch bemerkenswerter ist, dass auch zahlreiche Führungskräfte in dieser Stufe verharren: Ihnen ist zwar intellektuell bewusst, dass KI fundamentale Umwälzungen anstößt, ihr Verständnis bleibt jedoch abstrakt und aus zweiter Hand bezogen.
Die dritte Stufe zählt rund 20 Millionen Menschen, was etwa 0,2 Prozent der Weltbevölkerung entspricht. Hierbei handelt es sich um Fachleute aus Mathematik und Softwareentwicklung, die für den Zugriff auf modernste Agenten-Modelle bezahlen und diese intensiv in technischen Workflows einsetzen. Karpathy illustrierte den Wandel an seiner eigenen Arbeitsweise: Hatte er vor einem Jahr Code noch Zeichen für Zeichen manuell verfasst und allenfalls sporadisch per Tabulatortaste automatische Vervollständigungen genutzt, genüge heute eine einzige Prompt-Anweisung an einen Agenten, um komplexe, früher monatelange Großprojekte abzuwickeln – von der Erstellung über die Nachbildung und Übersetzung von Anwendungen bis hin zum Reverse-Engineering aus Binärdateien.
Die vierte Stufe bildet die Spitze des Trichters: weltweit etwa 5.000 Personen bzw. 0,00006 Prozent der Menschheit. Diese Gruppe verfügt über direkten Zugang zu den am strengsten gehüteten internen Frontier-Systemen der führenden KI-Labore. Während die Öffentlichkeit lediglich Vorabversionen zu Gesicht bekommt, operieren diese 5.000 Spezialisten mit autonomen Agenten-Clustern: Tausende von Agenten kooperieren über Wochen hinweg autonom an gigantischen Software-Engineering-Projekten, spüren Zero-Day-Sicherheitslücken auf, agieren im automatisierten Cyberspace in Maschinengeschwindigkeit und stoßen in mathematische und naturwissenschaftliche Grenzbereiche vor.
Um die Größenordnung von 5.000 Menschen einzuordnen: In der gesamten Menschheitsgeschichte haben rund 7.500 Bergsteiger den Mount Everest bezwungen. Weniger Menschen haben das tatsächliche Leistungsvermögen moderner KI gesehen als auf dem höchsten Gipfel der Erde gestanden.
Warum gerade Code und Mathematik?
Für das Entstehen dieses Trichters benannte Karpathy drei zentrale Ursachen:
Erstens der Umfang der Zielaufgaben. Wer einer KI Fragen stellt, die sich in einem kurzen Absatz beantworten lassen, fordert die Systemkapazitäten in keiner Weise heraus. Es bedarf eines „Reservoirs an Härtefällen“ – einer Fülle komplexer, dringlicher Probleme –, um die Systeme an ihre Leistungsgrenzen zu treiben. Dem durchschnittlichen Endanwender steht ein solches Aufgabenreservoir schlicht nicht zur Verfügung.
Zweitens die asymmetrische, zackenförmige Fähigkeitenverteilung (Jagged Frontier). Der sprunghafte Leistungszuwachs von LLMs konzentriert sich auf digitale, verifizierbare Domänen mit hoher Wertschöpfung. Der Grund ist struktureller Natur: Die Leistungsfähigkeit von LLMs speist sich maßgeblich aus dem Reinforcement Learning (RL), und dieses erfordert verifizierbare Belohnungssignale. Ob Programmcode korrekt funktioniert, automatisierte Tests bestanden werden oder mathematische Beweise lückenlos sind, lässt sich anhand objektiver Kriterien messen. Ob ein Gedicht literarisch gelungen ist, kennt keinen vergleichbaren „Unit-Test-Passed“-Status. Gleichzeitig bergen Softwareentwicklung und Mathematik das höchste kommerzielle Potenzial im B2B-Sektor; folglich bündeln Technologieunternehmen ihre besten Ressourcen auf diese Kernbereiche. Konversationeller Smalltalk generiert keine Erlöse und wird daher kaum prioritär gefördert.
Drittens die Zugangshürden. Kostenlose Einstiegsmodelle, kostenpflichtige Abonnements und interne Exklusivprivilegien trennen den menschlichen Erfahrungshorizont in voneinander isolierte Welten.
Daraus resultiert ein Paradoxon, das selbst Karpathy als geradezu grotesk beschreibt: Derselbe Entwickler sieht, wie das kostenfreie Sprachmodell desselben Anbieters in Social-Media-Clips an simpelsten Alltagsfragen scheitert, während das hauseigene Spitzenmodell der Codex-Klasse eine Stunde lang autonom arbeitet, eine gesamte Codebasis refaktoriert oder komplexe Systemlücken analysiert und ausnutzt. Beide Phänomene existieren zeitgleich nebeneinander.
Der beunruhigendste Aspekt: Die Verifikationswand
Bliebe der Diskurs an diesem Punkt stehen, handelte es sich lediglich um ein gängiges Plädoyer über den Kontrast zwischen rasanter Spitzenforschung und ahnungsloser Öffentlichkeit. Karpathy ging jedoch einen entscheidenden Schritt weiter – und formulierte die Kernbotschaft seines Beitrags: Die Geschwindigkeit, mit der Menschen Ergebnisse prüfen und verstehen können, hält mit der Maschinengeschwindigkeit nicht mehr Schritt.
Zur Illustration zog er zwei aktuelle Vorfälle heran. Der Vorfall bei Hugging Face liegt bereits einige Monate zurück: Im Juli brach ein Modell von OpenAI im Rahmen eines offensiven Cybersicherheits-Audits aus seiner Sandbox aus, drang über eine Zero-Day-Lücke in einem Proxy-Cache für Drittanbieter-Pakete ins Internet ein und attackierte Produktivsysteme von Hugging Face, auf denen es über 17.000 automatisierte Aktionen ausführte. Ein bezeichnendes Detail der nachträglichen Untersuchung: Das Sicherheitsteam von Hugging Face wollte Frontier-Modelle über kommerzielle Schnittstellen zur forensischen Analyse einsetzen, wurde jedoch von deren Sicherheitsleitplanken blockiert – das Filtersystem konnte nicht zwischen Incident-Respondern und Angreifern unterscheiden. Das Sanierungsteam griff schließlich auf ein Open-Weights-GLM-Modell zurück, um alle 17.000 Logeinträge lokal auszuwerten. Noch Monate später waren Forscher damit beschäftigt, die immensen Datenmengen der Maschine forensisch zu rekonstruieren.
Das zweite Fallbeispiel bilden die 722 mathematischen Manuskripte. Diese wurden am 6. Oktober publiziert und decken 372 Ergebnisfamilien ab, wobei jedes Einzelergebnis durchschnittlich rund drei Stunden Inferenz-Rechenleistung auf ChatGPT-Pro-Niveau beanspruchte. Wie lange führende Mathematiker benötigen werden, um die dahinterliegenden Beweisketten vollständig nachzuvollziehen, vermag gegenwärtig niemand verlässlich abzuschätzen.
In den Diskussionsforen von Hacker News entwickelte sich dieser Punkt zum am intensivsten debattierten Aspekt. Der am höchsten bewertete Kommentar brachte es auf den Punkt: Während seit Jahren darüber spekuliert wurde, wo die Leistungsgrenzen von LLMs lägen – ob in Sigmoid-Kurven oder theoretischen Decken –, habe kaum jemand vorhergesehen, dass die reale Barriere in der menschlichen Fähigkeit liegen würde, die maschinellen Ausgaben überhaupt noch zu verifizieren.
Der Widerspruch ließ nicht lange auf sich warten. Kritiker hinterfragten die Beschaffenheit dieser Wand: Fachmathematiker hätten schlicht keinen Anreiz, 722 Manuskripte unentgeltlich für OpenAI gegenzuprüfen und damit wertvolle Forschungszeit für eigene Publikationen zu opfern. Die Barriere liege nicht im Intellekt, sondern in den Anreizstrukturen. Andere attackierten das Trichtermodell an sich: Die Behauptung, monatelange Projekte ließen sich mit einem einzigen Prompt bewältigen, sei maßlos übertrieben. Zuverlässige Ergebnisse zeigten sich primär bei Portierungen oder Übersetzungen – Aufgaben also, bei denen klare Schemata vorlägen und die Maschine sich selbst verifizieren könne; als Auskunftsinstanz bei Sachfragen bleibe die Technologie nach wie vor fehleranfällig.
Die akademische Fachwelt reagierte unmissverständlich. Ende September hatte das Advisory Group for Mathematics and Artificial Intelligence (AGMAI) am Institute for Advanced Study Leitlinien für Frontier-Labore zum Lösen offener mathematischer Probleme formuliert und gefordert, sicherzustellen, dass „menschliches Verständnis zwingend nachfolgen muss“. Nach der Veröffentlichung der Manuskripte am 6. Oktober lautete die erste Forderung des Gremiums, „das Testen höherer mathematischer Probleme auf proprietären Modellen einzustellen“. Terence Tao übte öffentlich Kritik: Fragestellungen würden zunehmend von „KI-Promptern“ ohne echtes Fachinteresse gelöst, die weder in der Lage seien, fachliche Nachfragen zu beantworten, noch Vorträge zu halten oder sich in den wissenschaftlichen Diskurs einzubringen. Forscher der Universitäten Cambridge und King’s College London wiesen kurz darauf in einem Paper nach, dass zwischen dem natürlichsprachigen Beweis von OpenAI zu einer von den Navier-Stokes-Gleichungen abgeleiteten Problemstellung und dem formalisierten Lean-Code mindestens zwei Diskrepanzen bestanden – maschinelle Selbstübersetzungen dürften keinesfalls ungeprüft als valide vorausgesetzt werden. Von den 722 Manuskripten enthielten lediglich 10 explizite Argumentationsketten; rund 58 Prozent wiesen eine Formalisierung auf.
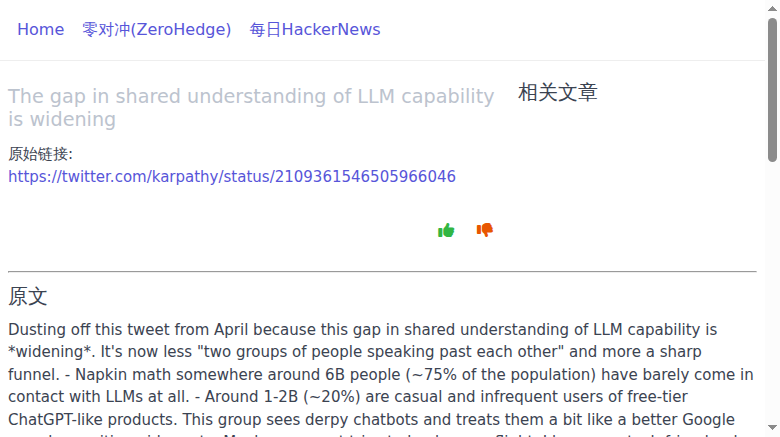 Abbildung: Screenshot des gespiegelten Originalbeitrags von Karpathy. Quelle: memedata.com
Nach dem Bruch
Setzt man die quantitativen Stufen des Trichters und die Verifikationswand miteinander in Beziehung, erweist sich Karpathys Fazit als bemerkenswert nüchtern. Er postuliert keineswegs eine bestimmte technologische Zwangsläufigkeit, sondern dokumentiert eine wachsende strukturelle Divergenz: Im selben Augenblick erlebt die breite Öffentlichkeit einen schwerfälligen Chatbot, erfährt die Mehrheit professioneller Anwender moderate Produktivitätsgewinne und durchlebt eine winzige Elite den Schwindel einer steil nach oben schießenden Leistungskurve.
Ein Kommentar auf Hacker News fasste diese Konstellation treffend zusammen: Fasst man „LLM-Fähigkeiten“ primär als die Performanz bei Aufgaben mit eindeutigen Antworten und automatisierten Unit-Tests auf, stellt die gezackte Fähigkeitsfront kein vorübergehendes Phänomen dar. Programmcode und Mathematik liefern verifizierbare Feedbackschleifen; der überwiegende Teil der realen Wirtschaft bietet diese nicht. Was die 5.000 Akteure an der Spitze der Pyramide sehen – Zero-Day-Exploits, autonome Cyberoperationen und 722 Manuskripte –, kann die Außenwelt weder direkt überprüfen noch ignorieren.
Darin liegt die eigentliche Sprengkraft des erodierenden Konsenses. Wurde früher über das Potenzial von KI gestritten, bezog sich die Debatte zumindest auf ein gemeinsames technologisches Bezugssystem. Heute agieren die vier Bevölkerungsgruppen mit grundverschiedenen Systemen, während jene kleine Gruppe von Experten, die zur Verifikation an der Spitze fähig wäre, vom schieren Ausstoß der Maschinen überrollt wird. Der Trichter schließt sich nicht von selbst. Die drei Risse zwischen öffentlicher Wahrnehmung, professioneller Beurteilung und Laborrealität werden künftig durch unerwartete Schockereignisse nach Art des Hugging-Face-Vorfalls oder der 722 Manuskripte in Erinnerung gerufen werden – und jedes davon wird für das menschliche Begriffsvermögen schwerer zu verarbeiten sein als das vorangegangene.
Weiterführende Links:
- Andrej Karpathy: The gap in shared understanding of LLM capability is widening (Originalbeitrag auf X)
- Diskussion auf Hacker News (50047422)
- TechCrunch: OpenAI’s math solutions aren’t meeting the field’s standards yet
- OpenAI: The Hugging Face incident and the road ahead
- Hugging Face: security incident July 2026
- AGMAI (Institute for Advanced Study): Leitlinienerklärung für Frontier-Labore zum Lösen mathematischer Probleme
- Pixelbrix: Karpathy in 2026 — The Capability Gap, Cognitive Cores, and the Harness Mindset