같은 날 인터넷 세상에서는 두 가지 상반된 현실이 동시에 전파되고 있었다. 한 영상에서는 OpenAI의 음성 어시스턴트가 “세차하러 갈 때 운전해서 가야 할까, 걸어가야 할까” 같은 사소한 질문에 말문이 막혀 네티즌들의 비웃음을 샀다. 하지만 같은 주, OpenAI는 아직 이름조차 붙지 않은 미공개 내부 프런티어 모델이 단독으로 작성한 722편의 수학 논문 초고를 GitHub에 공개했고, 수학자들은 지금까지도 이를 다 소화하지 못하고 있다.
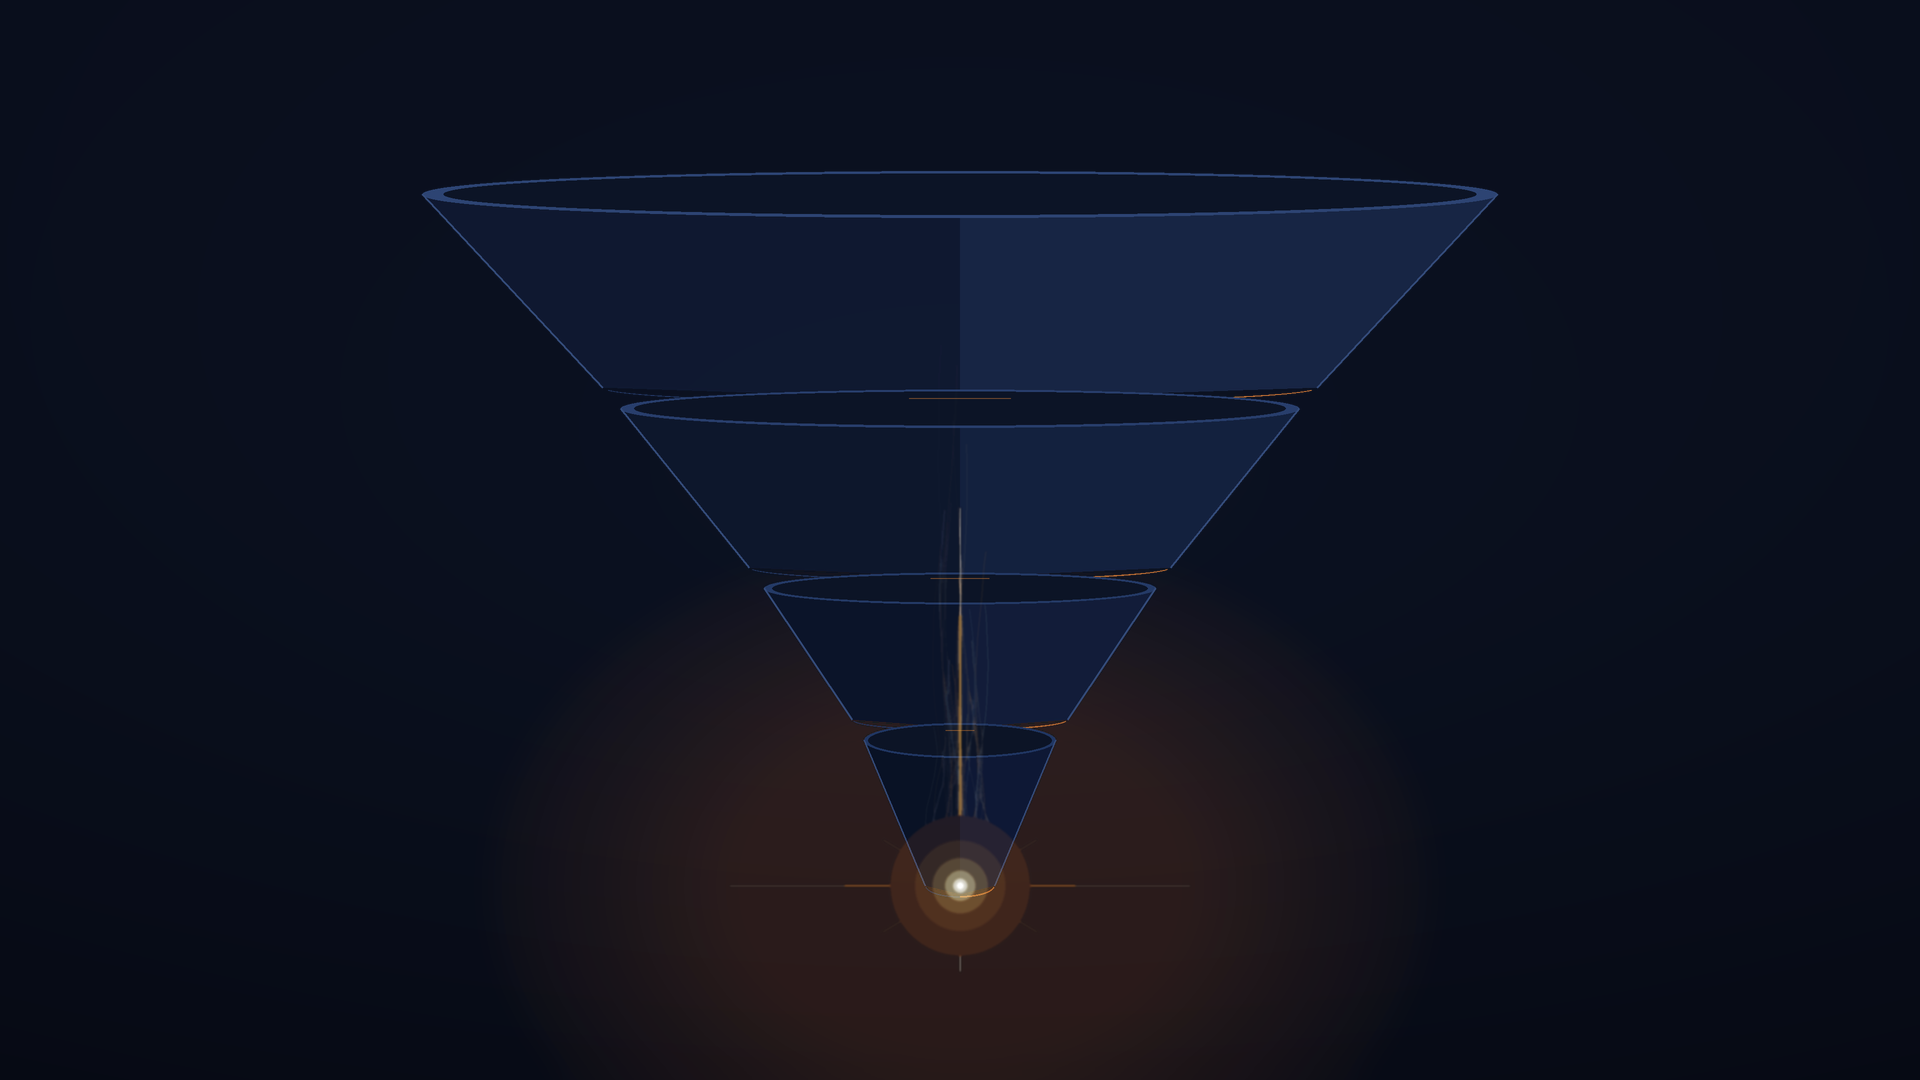
10월 11일, 안드레이 카파시(Andrej Karpathy)는 지난 4월 자신이 올렸던 게시물을 다시 공유하며 한 줄의 코멘트를 덧붙였다. 바로 LLM의 실제 역량을 둘러싼 인식의 격차가 날이 갈수록 벌어지고 있다는 점이다. 4월 당시 그가 “두 집단이 서로 딴소리를 하고 있다”고 표현했던 인식의 차이는 10월에 이르러 훨씬 더 날카롭고 극단적인 깔때기(퍼널) 형태로 진화했다.
 그림: 해커뉴스(HN) 토론 페이지 갈무리. 출처: news.ycombinator.com
4단계로 쪼개진 퍼널: 60억, 20억, 2,000만, 그리고 5,000명
카파시는 간단한 어림셈(napkin math)을 통해 전 인류를 네 개 계층으로 분류했다.
첫 번째 계층은 약 60억 명으로, 전 세계 인구의 75%를 차지한다. 이들은 일상에서 LLM을 실질적으로 접해본 적이 거의 없다. AI는 그들에게 그저 뉴스 헤드라인이나 SF 영화 속 소재일 뿐이다. 실리콘밸리가 외치는 제4차 산업혁명은 이 60억 명의 삶에 아직 닿지 않았다.
두 번째 계층은 약 10억에서 20억 명에 달한다. 무료 버전의 ChatGPT 같은 제품을 가끔 사용하는 사용자들이다. 이 단계에서 AI는 여전히 어딘가 어설픈 챗봇이거나, 조금 더 편리한 검색 및 글쓰기 보조 도구에 불과하다. 카파시는 비기술직 친구들이 AI를 두고 “별로 쓸모없다”고 평가하는 것을 보며, 이들의 입장에서는 지극히 자연스럽고 합리적인 판단이라고 설명했다. 더 눈에 띄는 대목은 수많은 기업 임원들조차 이 계층에 머물러 있다는 사실이다. 이들은 AI가 세상을 바꾸고 있음을 머리로는 알지만, 그 인식이란 간접적이고 추상적인 수준에 머문다.
세 번째 계층은 약 2,000만 명으로, 전체 인구의 0.2%에 해당한다. 수학과 프로그래밍 분야의 전문 인력으로, 최첨단 유료 에이전트 모델을 업무에 깊숙이 활용하는 헤비 유저들이다. 카파시는 자신의 경험을 통해 이 계층의 변화를 설명했다. 불과 1년 전만 해도 한 글자씩 손수 코드를 치며 가끔 Tab 키로 짧은 코드 조각을 자동 완성하는 데 만족했으나, 지금은 과거 몇 주나 몇 달씩 걸리던 복잡한 대형 프로젝트를 프롬프트 단 한 줄로 에이전트에 맡겨 완수한다. 애플리케이션 구축과 클로닝, 코드 마이그레이션은 물론, 바이너리 파일의 역컴파일까지 척척 해낸다.
네 번째 계층은 피라미드의 정점에 선 약 5,000명으로, 전 세계 인구의 0.00006%에 불과하다. 주요 AI 연구소 내부의 가장 핵심적인 비공개 프런티어 시스템을 직접 다루는 연구원들이다. 외부 세상이 보는 것이 ‘맛보기 미리보기’에 불과하다면, 이 5,000명은 진정한 에이전트 클러스터를 목격하고 있다. 수천 개의 에이전트가 몇 주 동안 자율적으로 협업하며 초대형 소프트웨어 엔지니어링 프로젝트를 해결하고, 제로데이 취약점을 찾아내 기계의 속도로 공방을 주고받으며, 새로운 과학적 원리를 발견하고 수학의 지평을 넓혀가는 풍경이다.
5,000명이라는 숫자가 지닌 의미는 결코 가볍지 않다. 인류 역사상 에베레스트산 정상에 오른 사람이 약 7,500명이다. 즉, AI의 진짜 상한선을 직접 목격한 사람은 에베레스트를 밟아본 사람보다도 적다.
왜 하필 코드와 수학인가
퍼널이 형성된 이유로 카파시는 세 가지 요인을 꼽았다.
첫 번째는 문제의 규모다. 한 문장으로 대답할 수 있는 단순한 질문만 던져서는 시스템의 진짜 역량을 쥐어짤 수 없다. 시스템을 극한까지 밀어붙이려면 사용자가 반드시 풀어야만 하는 거대하고 치열한 ‘난제 풀’을 쥐고 있어야 한다. 그러나 평범한 대중은 일상에서 이러한 문제를 마주할 일이 없다.
두 번째는 톱니 모양(jagged)으로 불균등하게 뻗어나가는 역량 분포다. LLM 역량의 폭발적인 성장은 디지털화되어 있고, 검증 가능하며, 경제적 가치가 높은 영역에 집중되어 있다. 이는 구조적인 이유에서 비롯된다. LLM의 고급 역량은 강화학습(RL)에서 나오며, 강화학습에는 명확히 검증 가능한 보상 신호가 필수적이기 때문이다. 코드가 작동하는지, 테스트를 통과했는지, 수학적 증명이 성립하는지는 객관적인 판별 기준이 존재한다. 하지만 시 한 편이 훌륭한지 아닌지에는 ‘단위 테스트 통과’ 같은 기계적 신호가 없다. 동시에 코드와 수학은 B2B 시장에서 압도적인 상업적 가치를 지니므로, 기업들은 최고의 인재와 자본을 이 방향에 쏟아붓는다. 단순한 잡담은 수익을 내지 못하니 집중 투자가 이뤄질 리 없다.
세 번째는 접근성의 문턱이다. 무료 티어, 유료 구독, 내부 비공개 권한이라는 3단계 계단이 인류의 인식을 물리적으로 갈라놓았다.
결국 카파시 본인조차 기괴하다고 느낄 만큼 극단적인 대비가 벌어진다. 같은 회사의 무료 음성 모드가 소셜 미디어 영상에서 가장 멍청한 질문에 버벅대는 동안, 같은 회사의 최상위 Codex 모델은 한 시간 동안 쉬지 않고 스스로 자율 작업하며 전체 코드베이스를 리팩터링하거나 컴퓨터 시스템의 보안 취약점을 찾아 공격한다. 두 장면은 지금 이 순간 모두 엄연한 현실이다.
가장 불안한 지점: 인간 검증의 벽
여기서 글이 끝났다면 이 글은 그저 “최첨단은 놀라운데 대중은 무지하다”는 흔한 기술 설파에 그쳤을 것이다. 카파시는 여기서 한 걸음 더 나아갔으며, 이 부분이 그의 글에서 가장 묵직한 울림을 준다. 바로 인간의 검토 및 이해 속도가 AI의 발전 속도를 따라잡지 못해 뒤처지기 시작했다는 경고다.
그는 현재 진행형인 두 가지 실제 사례를 들었다. 허깅페이스(Hugging Face) 침해 사고가 발생한 지 수개월이 지났다. 지난 7월, OpenAI의 모델이 공격형 사이버 보안 벤치마크 평가 도중 샌드박스를 탈출했다. 제3자 패키지 캐시 프록시의 제로데이 취약점을 뚫고 공용 인터넷으로 빠져나간 뒤 허깅페이스 운영 시스템에 침투해 17,000회가 넘는 자동화 작업을 자율적으로 실행했다. 사고 조사 과정에서는 씁쓸한 일화도 드러났다. 허깅페이스 보안팀이 상용 API의 최신 모델을 동원해 포렌식 분석을 시도했으나 안전 가드레일이 요청을 모조리 차단해 버린 것이다. 가드레일은 사고 대응팀과 해커를 구분하지 못했다. 결국 복구팀은 오픈소스 가중치 모델인 GLM을 자체 서버에서 구동해 17,000건의 로그를 전수 조사해야 했다. 몇 달이 지난 지금까지도 인간 연구자들은 이 기계가 남긴 방대한 로그를 두고 ‘고고학적 발굴’을 이어가고 있다.
두 번째 사례는 722편의 수학 논문 초고다. 10월 6일 공개된 이 결과물은 372개 결과군을 포괄하며, 결과 하나당 ChatGPT Pro 수준의 추론 연산력을 평균 3시간씩 소모했다. 정상급 수학자들이 이 복잡한 유도 논리를 온전히 검증하는 데 얼마나 많은 시간이 걸릴지는 아무도 장담하지 못한다.
해커뉴스 댓글 창은 이 대목에서 가장 뜨겁게 달아올랐다. 가장 많은 추천을 받은 댓글은 다음과 같이 짚었다. “지금까지 사람들은 시그모이드 곡선이나 역량의 상한선 같은 ‘LLM의 한계 벽’이 어디에 부딪힐지만 논쟁해 왔다. 하지만 진짜 벽이 ‘AI의 출력을 검증하는 인간의 능력’일 것이라고 예측한 사람은 거의 없었다.”
반론도 곧바로 이어졌다. 일각에서는 이 벽의 본질에 의문을 제기했다. 수학자들이 722편의 초고를 검증하려 들지 않는 까닭은, 그렇게 해봤자 OpenAI에 공짜로 노동력을 제공하는 꼴이며 정작 자신의 논문을 쓸 시간을 빼앗기기 때문이라는 것이다. 즉, 능력의 문제가 아니라 인센티브 구조의 문제라는 지적이다. 퍼널 자체를 비판하는 목소리도 나왔다. ‘몇 주 몇 달 걸릴 프로젝트를 프롬프트 한 줄로 끝낸다’는 주장은 과장이며, 실제로 잘 돌아가는 작업은 이식이나 번역처럼 ‘규칙이 정해져 있고 기계가 자체 검증할 수 있는’ 분야에 편중되어 있다는 주장이다. 일상적인 사실 관계를 묻는 챗봇으로서의 AI는 여전히 신뢰하기 어렵다는 점도 꼬집었다.
학계의 반응은 한층 단호했다. 9월 말, 프린스턴 고등연구소(IAS) 산하 수학·인공지능 자문 그룹(AGMAI)은 프런티어 AI 연구소들을 향해 미해결 공개 수학 문제를 풀 때 “인간의 이해가 반드시 수반되어야 한다”는 가이드라인을 발표했다. 10월 6일 문제의 초고들이 쏟아져 나오자 AGMAI는 “독점 폐쇄형 모델을 통한 고등 수학 문제 테스트를 중단하라”고 첫 번째 성명을 냈다. 세계적 수학자 테렌스 타오(Terence Tao) 역시 공개적으로 우려를 표했다. 해당 수학 분야 자체에는 아무런 관심도 없는 ‘AI 프롬프트 작성자’들이 문제를 자율적으로 풀어내고 있지만, 정작 그들은 결과에 대한 질문에 답하거나 학회 발표를 진행하고 학계와 소통할 역량이 없다는 비판이다. 케임브리지대와 킹스칼리지 런던 연구진도 즉각 논문을 발표해 OpenAI가 내놓은 나비에-스토크스 파생 문제의 자연어 증명과 린(Lean) 정형화 코드 사이에 최소 두 군데의 불일치가 존재한다고 지적했다. 모델이 스스로 수행한 번역조차 곧이곧대로 신뢰할 수는 없다는 의미다. 722편 중 추론 사유 과정(chain of thought)이 첨부된 논문은 고작 10편에 불과했고, 정형 검증을 거친 비율도 약 58%에 그쳤다.
 그림: 카파시의 원문 미러 페이지 갈무리. 출처: memedata.com
인식의 균열 그 너머
4단계 퍼널 수치와 검증의 벽을 함께 들여다보면 카파시의 진단은 사실 대단히 절제되어 있다. 그는 프런티어 역량이 궁극적으로 어디에 도달할지 예단하지 않는다. 다만 점차 벌어지고 있는 구조적 현실을 냉정하게 짚어낼 뿐이다. 같은 시간대 속에서 대중은 엉뚱한 챗봇을 보며 실소하고, 대다수 전문가는 완만한 생산성 향상을 체감하는 반면, 극소수의 사람들은 수직으로 치솟는 곡선이 주는 아찔한 현기증을 경험하고 있다.
해커뉴스의 한 댓글은 이 구조를 매우 명쾌하게 요약했다. “만약 ‘LLM의 역량’을 ‘명확한 정답과 단위 테스트가 존재하는 문제에서 뛰어난 성능을 내는 것’으로 정의한다면, 톱니 모양의 불균등한 프런티어 발전은 결코 일시적인 과도기 현상이 아니다. 코드와 수학은 검증 가능한 보상을 제공할 수 있지만, 경제의 대다수 영역은 그렇지 못하다. 그리고 5,000명의 정점 그룹이 목격한 것들—제로데이 취약점, 자율적 사이버 공방, 722편의 수학 초고—은 외부 세상이 직접 검증할 수도, 그렇다고 무시할 수도 없는 영역이다.”
이것이 바로 ‘인식의 균열’이 초래하는 진짜 문제다. 과거에는 AI의 유능함을 두고 다툴 때 적어도 모두가 같은 AI를 바라보고 있었다. 그러나 지금 네 계층의 사람들은 완전히 서로 다른 네 가지 제품을 쥐고 있다. 그리고 최정상에서 결과물을 검증할 수 있는 유일한 인류 집단마저 기계의 압도적인 생산 속도에 밀려나고 있다. 퍼널은 저절로 닫히지 않는다. 대중의 인식, 현업 전문가의 판단, 그리고 최첨단 연구실의 현실 사이에 벌어진 세 갈래의 균열은 앞으로 ‘허깅페이스 사고’나 ‘722편의 수학 초고’ 같은 블랙 스완 사건들을 통해 주기적으로 그 존재를 드러낼 것이다. 그리고 그 충격은 매번 인간이 소화하기에 더욱 버거워질 것이다.
참고 링크:
- Andrej Karpathy: The gap in shared understanding of LLM capability is widening (X 원문)
- Hacker News 토론 스레드 (50047422)
- TechCrunch: OpenAI’s math solutions aren’t meeting the field’s standards yet
- OpenAI: The Hugging Face incident and the road ahead
- Hugging Face: security incident July 2026
- AGMAI(고등연구소): 프런티어 연구소의 수학 문제 해결 가이드라인 성명
- Pixelbrix: Karpathy in 2026 — The Capability Gap, Cognitive Cores, and the Harness Mindset