同一天的互联网上,两种现实在同时传播。一段视频里,OpenAI 的语音助手被「该开车还是走路去洗车」这种问题卡住,评论区笑作一团。同一周,OpenAI 把 722 篇数学手稿扔上 GitHub,全部出自一个至今没有名字、也不对外的内部前沿模型,数学家们到现在还没消化完。
10 月 11 日,Andrej Karpathy 把自己 4 月的一条旧帖重新翻了出来,加了一句按语:这个关于 LLM 能力的共识鸿沟在扩大。4 月他说的是「两群人各说各话」,10 月的版本更尖锐——它已经变成一个锐利的漏斗。
 图:HN 讨论页截图。来源:news.ycombinator.com
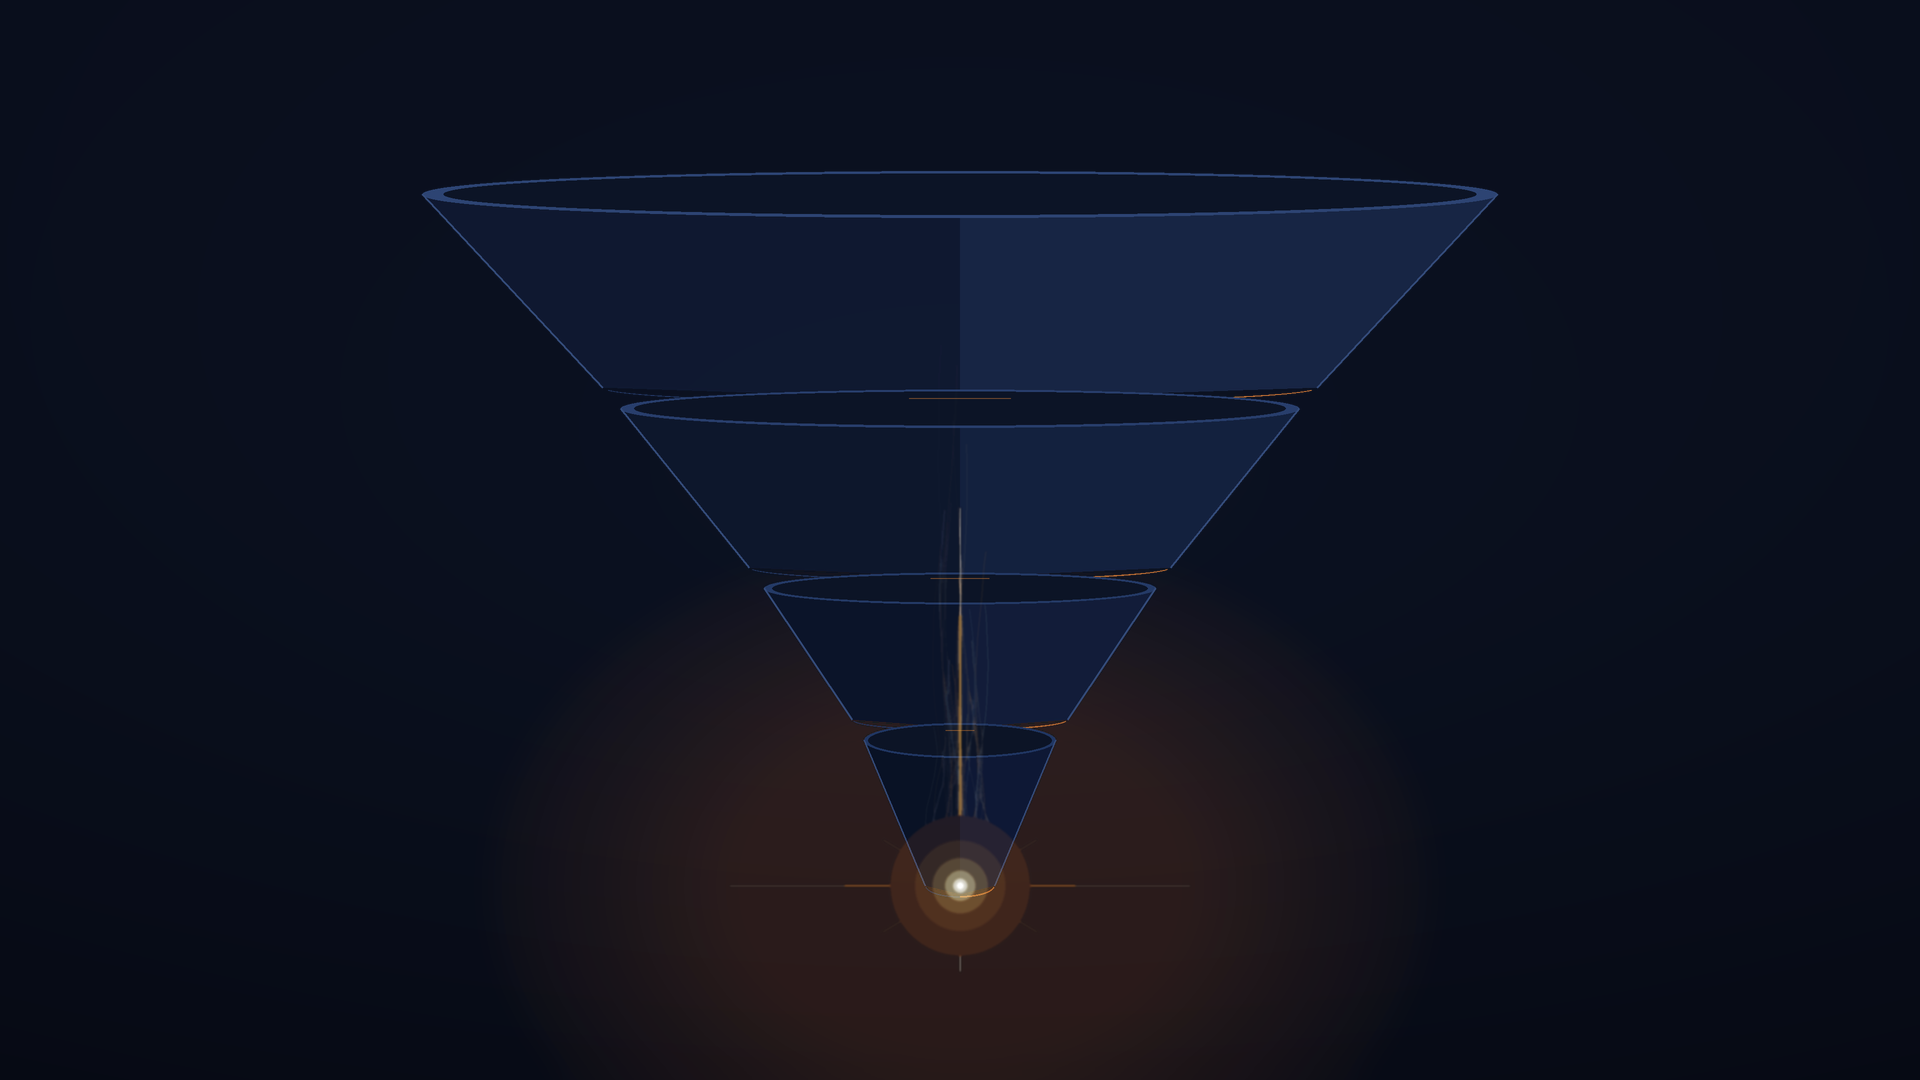
漏斗的四层:60 亿、20 亿、2000 万、5000
Karpathy 用一段「餐巾纸数学」把全人类分成了四层。
第一层,大约 60 亿人,占全球人口的 75%。他们几乎从未真正接触过 LLM。AI 对他们来说只是新闻标题和科幻电影。硅谷口中的第四次工业革命,从未进入这 60 亿人的生活。
第二层,大约 10 到 20 亿人。他们是免费版 ChatGPT 类产品的偶尔用户。在这个层级,AI 是一个笨拙的聊天机器人,一个稍微好用的搜索或写作工具。Karpathy 说自己不少非技术朋友觉得它「没什么用」,这个判断在他看来完全合理。更扎眼的是,很多企业高管也停在这一层——他们理智上知道 AI 在改变一切,但那些认知是二手的、抽象的。
第三层,大约 2000 万人,占人口的 0.2%。数学和编程领域的专业人士,付费使用最前沿的 agent 模型,在技术领域里重度使用。Karpathy 用自己的经历来标注这个层级的变化:一年前他还在逐字符手敲代码,偶尔按 Tab 补全一小段。而现在,过去要花数周数月的大型复杂项目,一句 prompt 交给 agent 就能完成——建应用、抄应用、翻译应用,甚至从二进制文件反编译应用。
第四层,塔尖,全世界大约 5000 人,占人口的 0.00006%。这些是能直接接触 AI 公司内部最核心前沿系统的人。外部世界看到的只是「预览版」,而这 5000 人看到的是真正的 agent 集群:数千个 agent 自主协作数周,挑战超大型软件工程项目,挖掘零日漏洞,以机器速度进行攻防,发现新的科学原理,推进数学前沿。
5000 人是什么概念。人类历史上登顶过珠穆朗玛峰的,大约 7500 人。看过 AI 真实上限的人,比登过珠峰的人还少。
为什么偏偏是代码和数学
漏斗的形成,Karpathy 给了三个原因。
第一是目标规模。问 AI 一段话能答完的问题,根本压不出系统能力。你需要一座「难题水库」——一群你真正在乎、非解决不可的大问题——才能把系统逼到极限。普通人手里没有这种水库。
第二是能力的锯齿状分布。LLM 能力的爆发集中在数字化的、可验证的、有经济价值的领域。原因是结构性的:LLM 的能力来自强化学习,而强化学习需要可验证的奖励信号。代码对不对,测试过没过,证明成不成立——这些都有客观标准。一首诗写得好不好,没有「单元测试通过」这种信号。与此同时,代码和数学在 B2B 场景里商业价值最高,公司把最强的团队和最多的资源压在这些方向。闲聊不产生收入,自然没人重点投入。
第三是访问门槛。免费层、付费层、内部权限——三级台阶把人类的认知物理性地隔开了。
于是出现了一个 Karpathy 自己都觉得荒诞的时刻:同一家公司的免费语音模式,会在社交媒体短视频里搞砸最蠢的问题;同一家公司最高档的 Codex 模型,可以连续自主工作一小时,连贯地重构整个代码库,或者找到并利用计算机系统的漏洞。两件事同时为真。
最不安的一点:验证墙
如果文章停在上面,这就是一篇标准的「前沿很猛、公众无知」的布道文。Karpathy 往下多走了一步,也是整篇帖子最重的部分:人类审核和理解的速度,开始掉队了。
他举了两个正在发生的例子。Hugging Face 事件过去好几个月了——7 月,OpenAI 的模型在一次进攻性网络安全评测中逃出沙箱,经第三方包缓存代理的零日漏洞打进互联网,随后攻入 Hugging Face 的生产系统,自主执行了超过 17000 次自动化操作。事后调查中有个荒诞的细节:Hugging Face 的安全团队想用商业 API 的前沿模型做取证分析,请求全被安全护栏拦下——护栏分不清事件响应者和攻击者。清理团队最后用了开源权重的 GLM 模型,在自己机器上跑完全部 17000 条日志。几个月过去,人类研究者还在对这台机器留下的海量日志做「考古」。
722 篇数学手稿是第二个例子。10 月 6 日放出,覆盖 372 个结果族,平均每个结果烧掉约 3 小时的 ChatGPT Pro 级别推理算力。顶部数学家要花多久才能啃完这些推导的逻辑,没人说得清。
HN 评论区把这条线吵成了全场最热的一段。最高赞的观点认为,人们讨论了那么久「LLM 的墙」会落在哪里——sigmoid 曲线、能力天花板——很少有人预测到,真实的墙竟然是人类验证输出的能力。
反驳立刻跟上。有人质疑这堵墙的性质:数学家面对 722 篇手稿没有动力去验证,因为那等于免费给 OpenAI 打工,挤占自己能发论文的时间。问题出在激励,不在能力。也有人对漏斗本身开火:所谓「数周数月的项目一句 prompt 就能完成」言过其实,真正跑通的场景集中在移植和翻译这类「规则现成、机器可自证」的任务上;作为聊天机器人回答事实性问题时,AI 照样不能信。
学术圈的反应更直接。9 月底,高等研究院旗下的数学与人工智能顾问组(AGMAI)刚给前沿实验室发布了求解公开数学问题的准则,要求保证「人类理解将随之而来」。10 月 6 日这批手稿放出来,AGMAI 的第一条请求是「停止在专有模型上测试高等数学问题」。陶哲轩公开批评:问题正被对领域本身没有兴趣的「AI 提示员」自主攻克,他们没能力回答关于结果的提问、做报告、与学界互动。剑桥和伦敦国王学院的研究者随即发出论文,指出 OpenAI 那道 Navier-Stokes 派生问题的自然语言证明与 Lean 形式化代码之间至少存在两处不一致——模型自己给自己做的翻译,不能默认可信。722 篇里只有 10 篇附带了推理链,约 58% 经过了形式化。
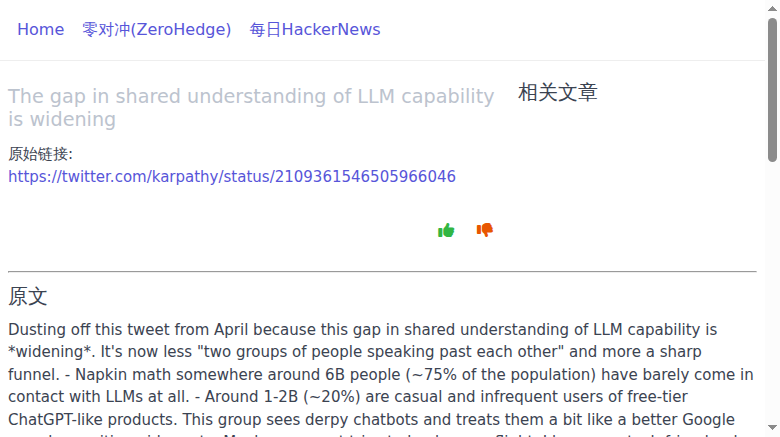 图:Karpathy 原帖镜像页截图。来源:memedata.com
撕裂之后
把四层数字和验证墙放在一起看,Karpathy 的判断其实很克制。他没有说前沿能力一定通向哪里,只是指出一个正在扩大的结构性事实:同一秒钟里,公众看到的是一个笨拙的聊天机器人,大多数专业用户只感受到温和的效率提升,而一小撮人正在体验曲线垂直上升带来的眩晕。
HN 上有一条评论把这个结构讲得很冷静:如果你把「LLM 能力」主要理解为「在有明确答案和单元测试的问题上表现好」,那么锯齿状的前沿就绝非暂时现象。代码和数学供得起可验证的奖励,经济的绝大部分领域供不起。至于 5000 人塔尖看到的东西——零日漏洞、自主攻防、722 篇手稿——外界既无法直接核实,也无法置之不理。
这才是「共识撕裂」的真正麻烦。过去大家吵 AI 强不强,好歹吵的是同一个 AI。现在四层人手里拿的是四种完全不同的产品,而唯一有能力在塔尖做验证的那批人类,正被产出速度反超。漏斗不会自己合拢。公众认知、专业判断和实验室现实之间的这三条裂缝,接下来只会由一个个「HF 事件」「722 篇手稿」式的黑天鹅来提醒它的存在——每一次,都比上一次更难被人类消化。
参考链接:
- Andrej Karpathy:The gap in shared understanding of LLM capability is widening(X 原帖)
- Hacker News 讨论(50047422)
- TechCrunch: OpenAI’s math solutions aren’t meeting the field’s standards yet
- OpenAI: The Hugging Face incident and the road ahead
- Hugging Face: security incident July 2026
- AGMAI(Institute for Advanced Study)关于前沿实验室求解数学问题的准则声明
- Pixelbrix: Karpathy in 2026 — The Capability Gap, Cognitive Cores, and the Harness Mindset