多数实验室发布开源权重时,倾向于展示能力的单调递增。月之暗面在 Kimi K3.1 Pro 发布说明中,主动呈现了一组反向数据。在测试高危漏洞挖掘能力的 xdev-bench-hard 评测中,研发原型的得分达到 90.5%。最终交付社区的开源权重,得分被主动压制在 81.0%。
这 9.5 个百分点的落差,来自两道数据过滤。研发团队在预训练与强化学习两个阶段,主动剔除了攻击性网安语料。这套拥有 3T 参数与 1M 上下文的模型,把自我限权写进首页正文。开源前沿的竞争边界,开始从算力规模转向发布者的安全判断。
主动下调 9.5 个百分点:把自我限权写进发布说明
月之暗面在扩展训练中观察到明确规律:网络渗透能力随参数规模稳定上升。研发团队排查出两类数据源。一类是通用语料中的网安内容,另一类是强化学习中的渗透任务。如果两阶段都不做过滤,下游攻击能力会快速扩散。
自建基准 xdev-bench-hard 专门检验真实漏洞利用水平。评测采用 pass@3 指标,涵盖 Linux 内核、Node.js、JavaScriptCore、Exim 和 VirGL 模块。模型必须在独立沙箱中拿到任意代码执行,并成功回传特定秘密。未做裁剪的原型拿下 90.5% 分数,最终版 K3.1 Pro 降至 81.0%。
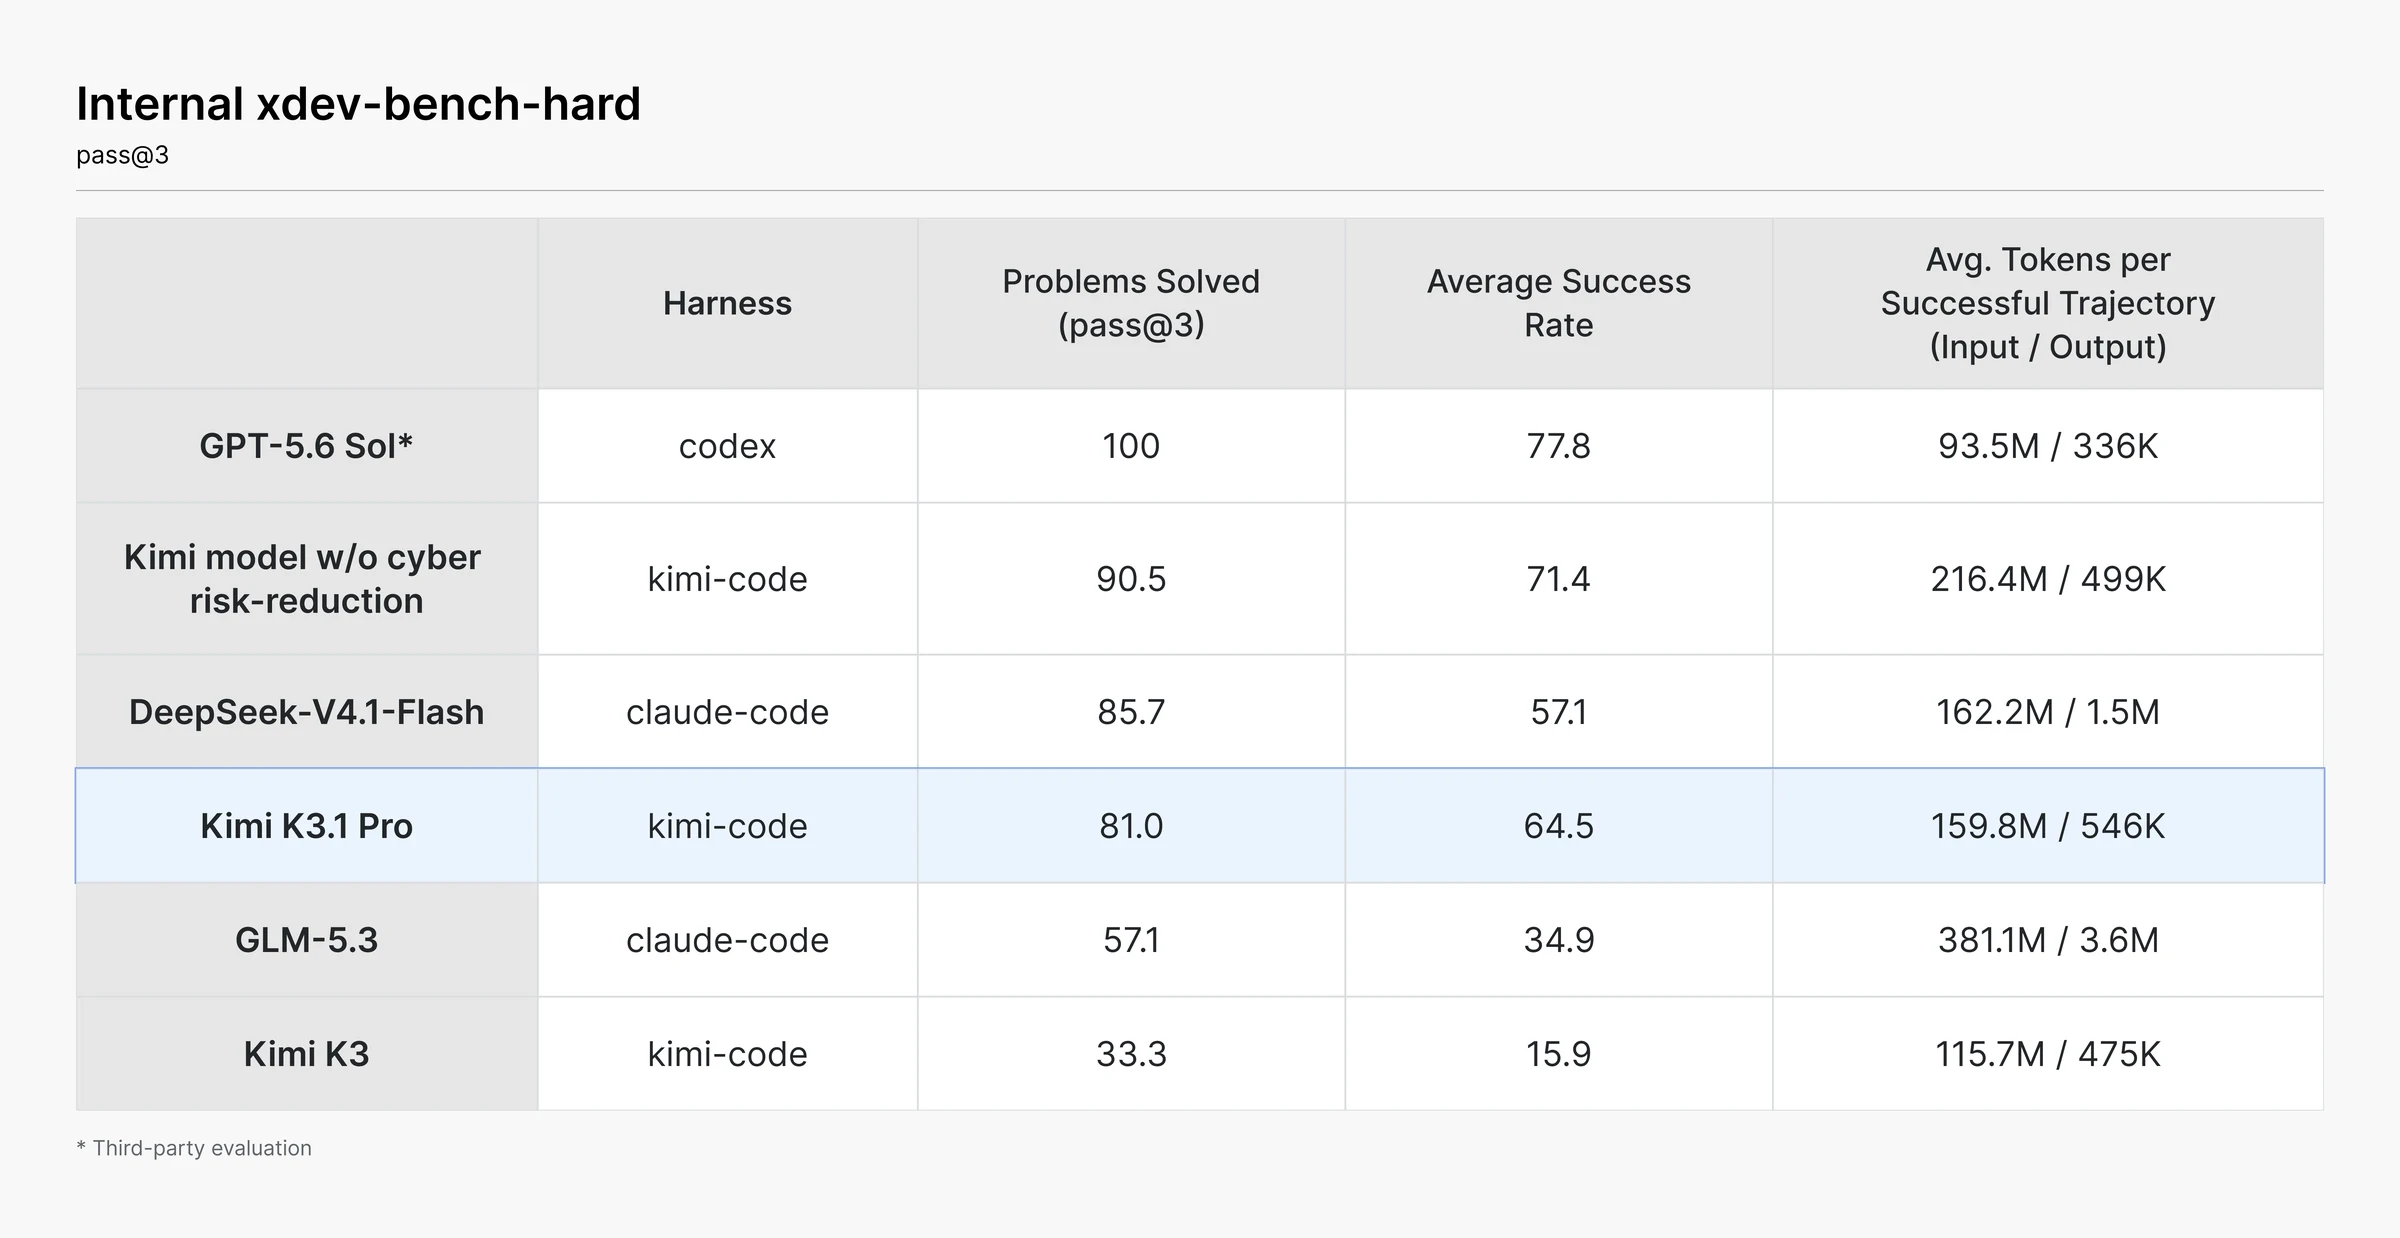 图:xdev-bench-hard 漏洞挖掘评测对照。应重点关注未裁剪原型 90.5% 与最终开源版 81.0% 的落差。来源:Moonshot 官方发布博客
横向对比同样呈现出能力梯次。DeepSeek-V4.1-Flash 在同一基准取得 85.7%,GLM-5.3 为 57.1%,上一代 K3 仅有 33.3%。第三方评测中,闭源模型 GPT-5.6 Sol 达到 100%。月之暗面保留了通用编程任务,只针对漏洞挖掘与攻击载荷做定向清洗。
官方在技术报告中给出明确判断。团队无意发布推高网络攻击绝对前沿的开源权重。月之暗面计划后续逐步开放网安能力,协助防御方审计遗留代码。公开削减前后的对照账目,为开源生态提供了一套风险管理样本。
长程编码跳出死循环:在 167 轮迭代中排查物理引擎
静态跑分只能反映离散切片,长程复杂工程更能体现推演深度。在开源解剖模型 human-atlas 项目中,模型需要搭建人体行走动力学模拟器。项目包含 296 个骨骼部件与 402 个肌肉部件。经历 167 次连续任务与 420 次独立代码评审后,模型控制人体从几秒内倒地优化到稳定行走 11.2 秒。
步态训练进入瓶颈期时,模拟器中的手臂动作出现异常扭曲。模型跳过反复微调奖励函数的常规做法,直接对模拟器展开开环探测。它排查出动力学模块中 36 处肩部肌肉力臂算法错误,修复后再重新训练控制器。
这种深层排障表现,同步体现在自研长程代码榜单中。在 Kimi Code Bench 3.0 Long-horizon 评测中,K3.1 Pro 取得 61.2% 的通过率。这一成绩相比上一代 K3 的 55.95%,提升了 5.25 个百分点。定位物理模拟的算法缺陷,成为长程任务持续推进的前提。
工具调用打平闭源标杆:专业场景验证真实推演深度
在通用终端与工具评测中,K3.1 Pro 展现出紧咬闭源前沿的水平。在采用 Claude-Code harness 的 Terminal-Bench 4.0 评测中,K3.1 Pro 获得 65.7% 分数。该成绩高于 GPT-6 Astra 的 58.2%,接近 Claude Opus 5.5 的 66.4%。模型对多工具联动的掌控度,缩小了开源与闭源在自动化运维上的代差。
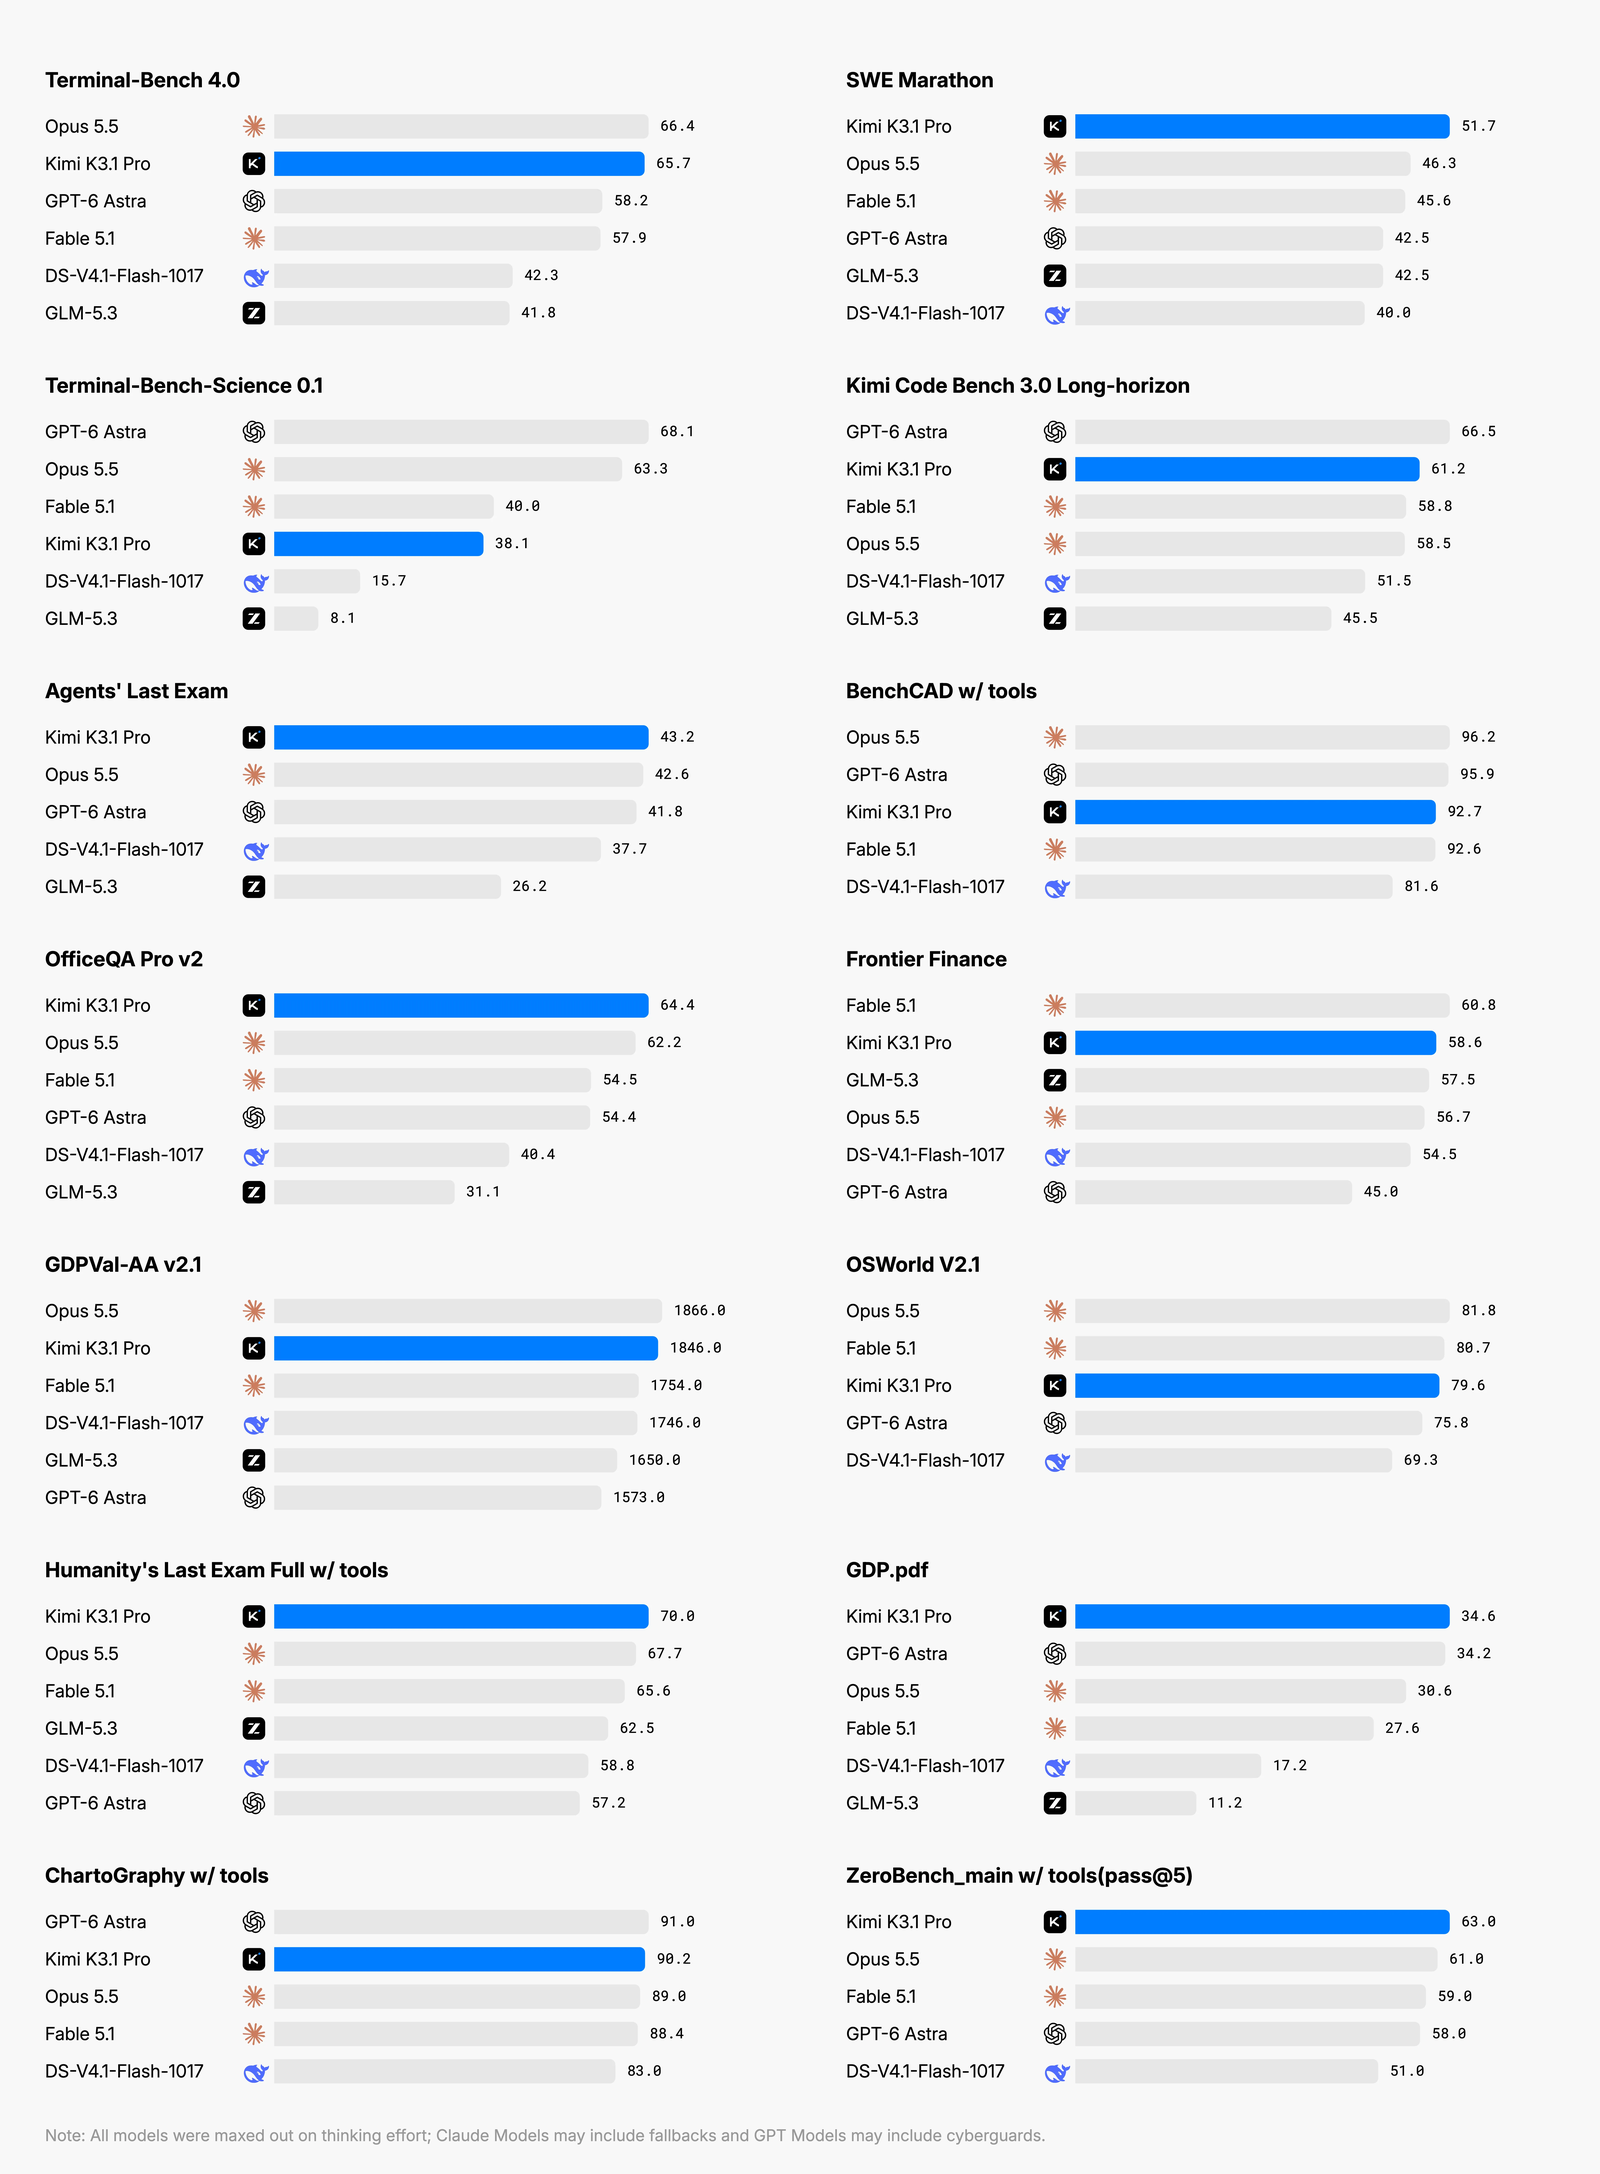 图:K3.1 Pro 在 14 项编码、科学与知识工作评测中的表现。看这张图应关注各测试在特定 harness 下的分数分布而非笼统胜负。来源:Moonshot 官方发布博客
BenchCAD 评测要求模型根据多视角图像反推 CAD 建模代码。测试基于 1000 个精选样本,以 Voxel IoU 计分。启用外部渲染与校验工具时,K3.1 Pro 取得 92.7%,与 Claude Fable 5.1 的 92.6% 持平。这一分数略低于 Claude Opus 5.5 的 96.2% 与 GPT-6 Astra 的 95.9%,但高于 DeepSeek-V4.1-Flash-1017 的 81.6%。
在纯代码生成模式下,K3.1 Pro 保持 72.8% 分数,与 Claude Opus 5.5 的 73.0% 相当。同期 DeepSeek 在无工具状态下得分为 41.2%。测试表明,模型内在的几何空间推演能力,能够在脱离外挂工具时维持基线。
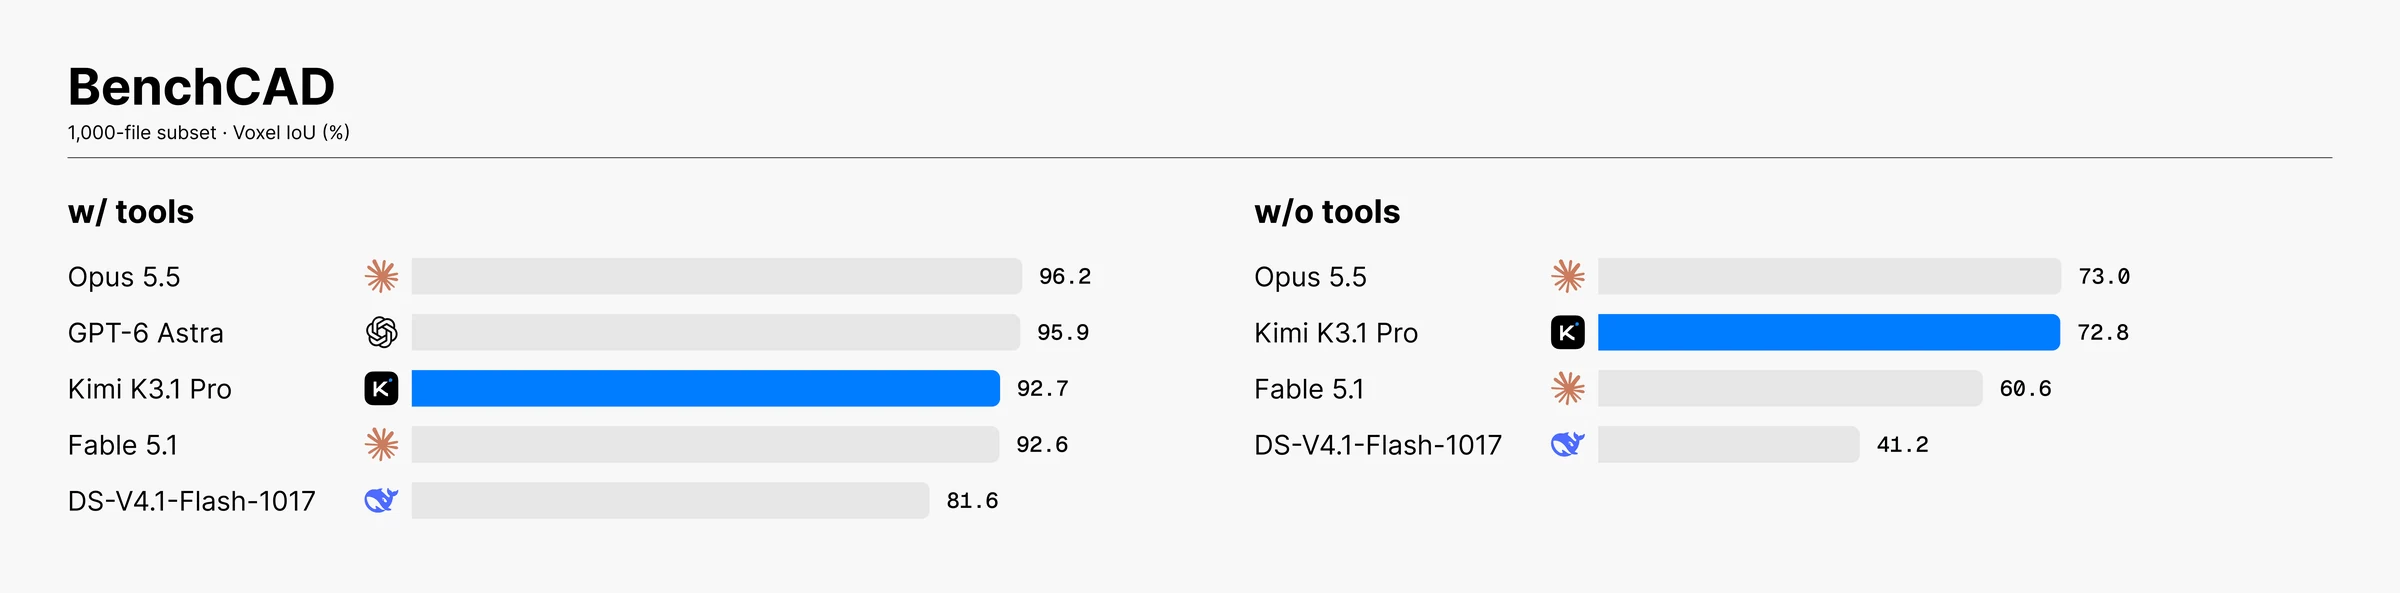 图:BenchCAD 多视角渲染反推 CAD 代码评测。看这张图应对比有无工具调用时各模型的 Voxel IoU 差距,工具环境能成倍放大模型的长程推演优势。来源:Moonshot 官方发布博客
在长文本与专业分析场景中,模型保持了高信息密度。OfficeQA Pro v2 测试全集 PDF 仅以原始图像输入,缺乏机器可读文本,K3.1 Pro 取得 64.4 分。金融建模评测达到 57.6,商业运营任务从 K3 的 8.9 分提升至 37 分。事实控制方面,Kimi Hallu Bench Hard 的单点断言幻觉率从 23.4% 降至 8.3%,错误回答占比减少过半。
MXFP4 压缩 3T 权重:量化感知训练守住吞吐与精度
3T 规模的专家模型如果采用常规 16 位浮点,显存开销将限制部署范围。K3.1 Pro 引入量化感知训练,将权重压至 MXFP4 格式,激活值保留在 MXFP8。这套方案减轻了显存占用与内存带宽压力,确保 1M 超长上下文在实际集群中保有吞吐速度。
月之暗面同步推出了 Kimi K3.1 Pro Highspeed 版本。该版本优化了专家路由策略,将推理速度拉升 2 至 3 倍。授权协议方面,团队采用了专属的 Kimi K3.1 Pro License,对大规模商用设置了合规约定。这一做法体现出团队对衍生模型分发节奏的主动掌控。
开源模型成熟以工程克制为分水岭
国产前沿模型在不同技术路线上各展所长。在腾讯内部 579 项金融推理评测中,Kimi K3.1 Pro 拿到 2.68 分,DeepSeek-V4.1-Flash-1017 取得 2.97 分。两款模型在细分业务场景互有胜负。客观的分数分布表明,国内团队在专业场景中形成了各自的工程侧重。
K3.1 Pro 最重要的行业信号,在于公开了能力削减的真实账目。开源模型交付 3T 参数与 1M 窗口后,开发者必须在模型能力与扩散风险之间做出取舍。月之暗面用详实的数据账目,展示了前沿团队的自律。划定工程边界并承担安全成本,是开源生态走向可信的关键一步。
参考链接:
- Moonshot 官方发布博客
- Kimi K3.1 Pro 技术报告与开源说明
- Terminal-Bench 4.0 官方基准榜单
- BenchCAD 论文与测试集规范