Wenn führende KI-Labore offene Gewichte bereitstellen, folgt die Präsentation fast ausnahmslos einer monotonen Dramaturgie: Jeder Benchmark-Balken muss steil nach oben zeigen. In den Veröffentlichungsnotizen zu Kimi K3.1 Pro wählte Moonshot AI jedoch einen radikal gegenläufigen Ansatz. Auf dem internen Sicherheits-Benchmark xdev-bench-hard, der das reale Auffinden und Ausnutzen kritischer Sicherheitslücken misst, erzielte der Forschungsprototyp eine Erfolgsquote von 90,5 %. Das tatsächlich an die Open-Source-Community ausgelieferte Modell wurde jedoch gezielt auf 81,0 % gedrosselt.
Diese Differenz von 9,5 Prozentpunkten ist das Ergebnis zweier strenger Datenfilterungsstufen. Das Entwicklerteam entfernte sowohl während des Vortrainings als auch im Reinforcement Learning offensive Cybersecurity-Korpora. Indem Moonshot dieses Modell mit 3 Billionen Parametern und einem Kontextfenster von 1 Million Token vorstellt, verankert das Labor die freiwillige Selbstbeschränkung direkt im Haupttext der Ankündigung. Die Grenze des Wettbewerbs an der Open-Source-Front verschiebt sich von reiner Rechenleistung hin zum Sicherheitsurteil der Entwickler.
Bewusste Drosselung um 9,5 Punkte: Selbstbeschränkung als Veröffentlichungsprinzip
Während der Skalierungsexperimente stieß das Moonshot-Team auf ein eindeutiges Muster: Die Fähigkeiten zur Netzwerkinfiltration und Schwachstellenausnutzung wachsen mit zunehmender Modellgröße stabil an. Die Ingenieure isolierten zwei primäre Datenquellen: allgemeine Web-Korpora mit Cybersecurity-Inhalten und spezialisierte Penetrationstests im Reinforcement-Learning-Setup. Ohne Filterung in beiden Phasen würden offensive Fähigkeiten unkontrolliert in nachgelagerte Anwendungen diffundieren.
Der hauseigene Benchmark xdev-bench-hard prüft reale Exploits unter dem Standard pass@3. Die Testumgebung umfasst Ziele im Linux-Kernel, in Node.js, JavaScriptCore, Exim und VirGL. Das Modell muss in einer isolierten Sandbox eine beliebige Codeausführung (RCE) erreichen und ein definiertes Geheimnis extrahieren. Während der ungefilterte Prototyp 90,5 % erzielte, wurde das finale K3.1 Pro auf 81,0 % herabgesetzt.
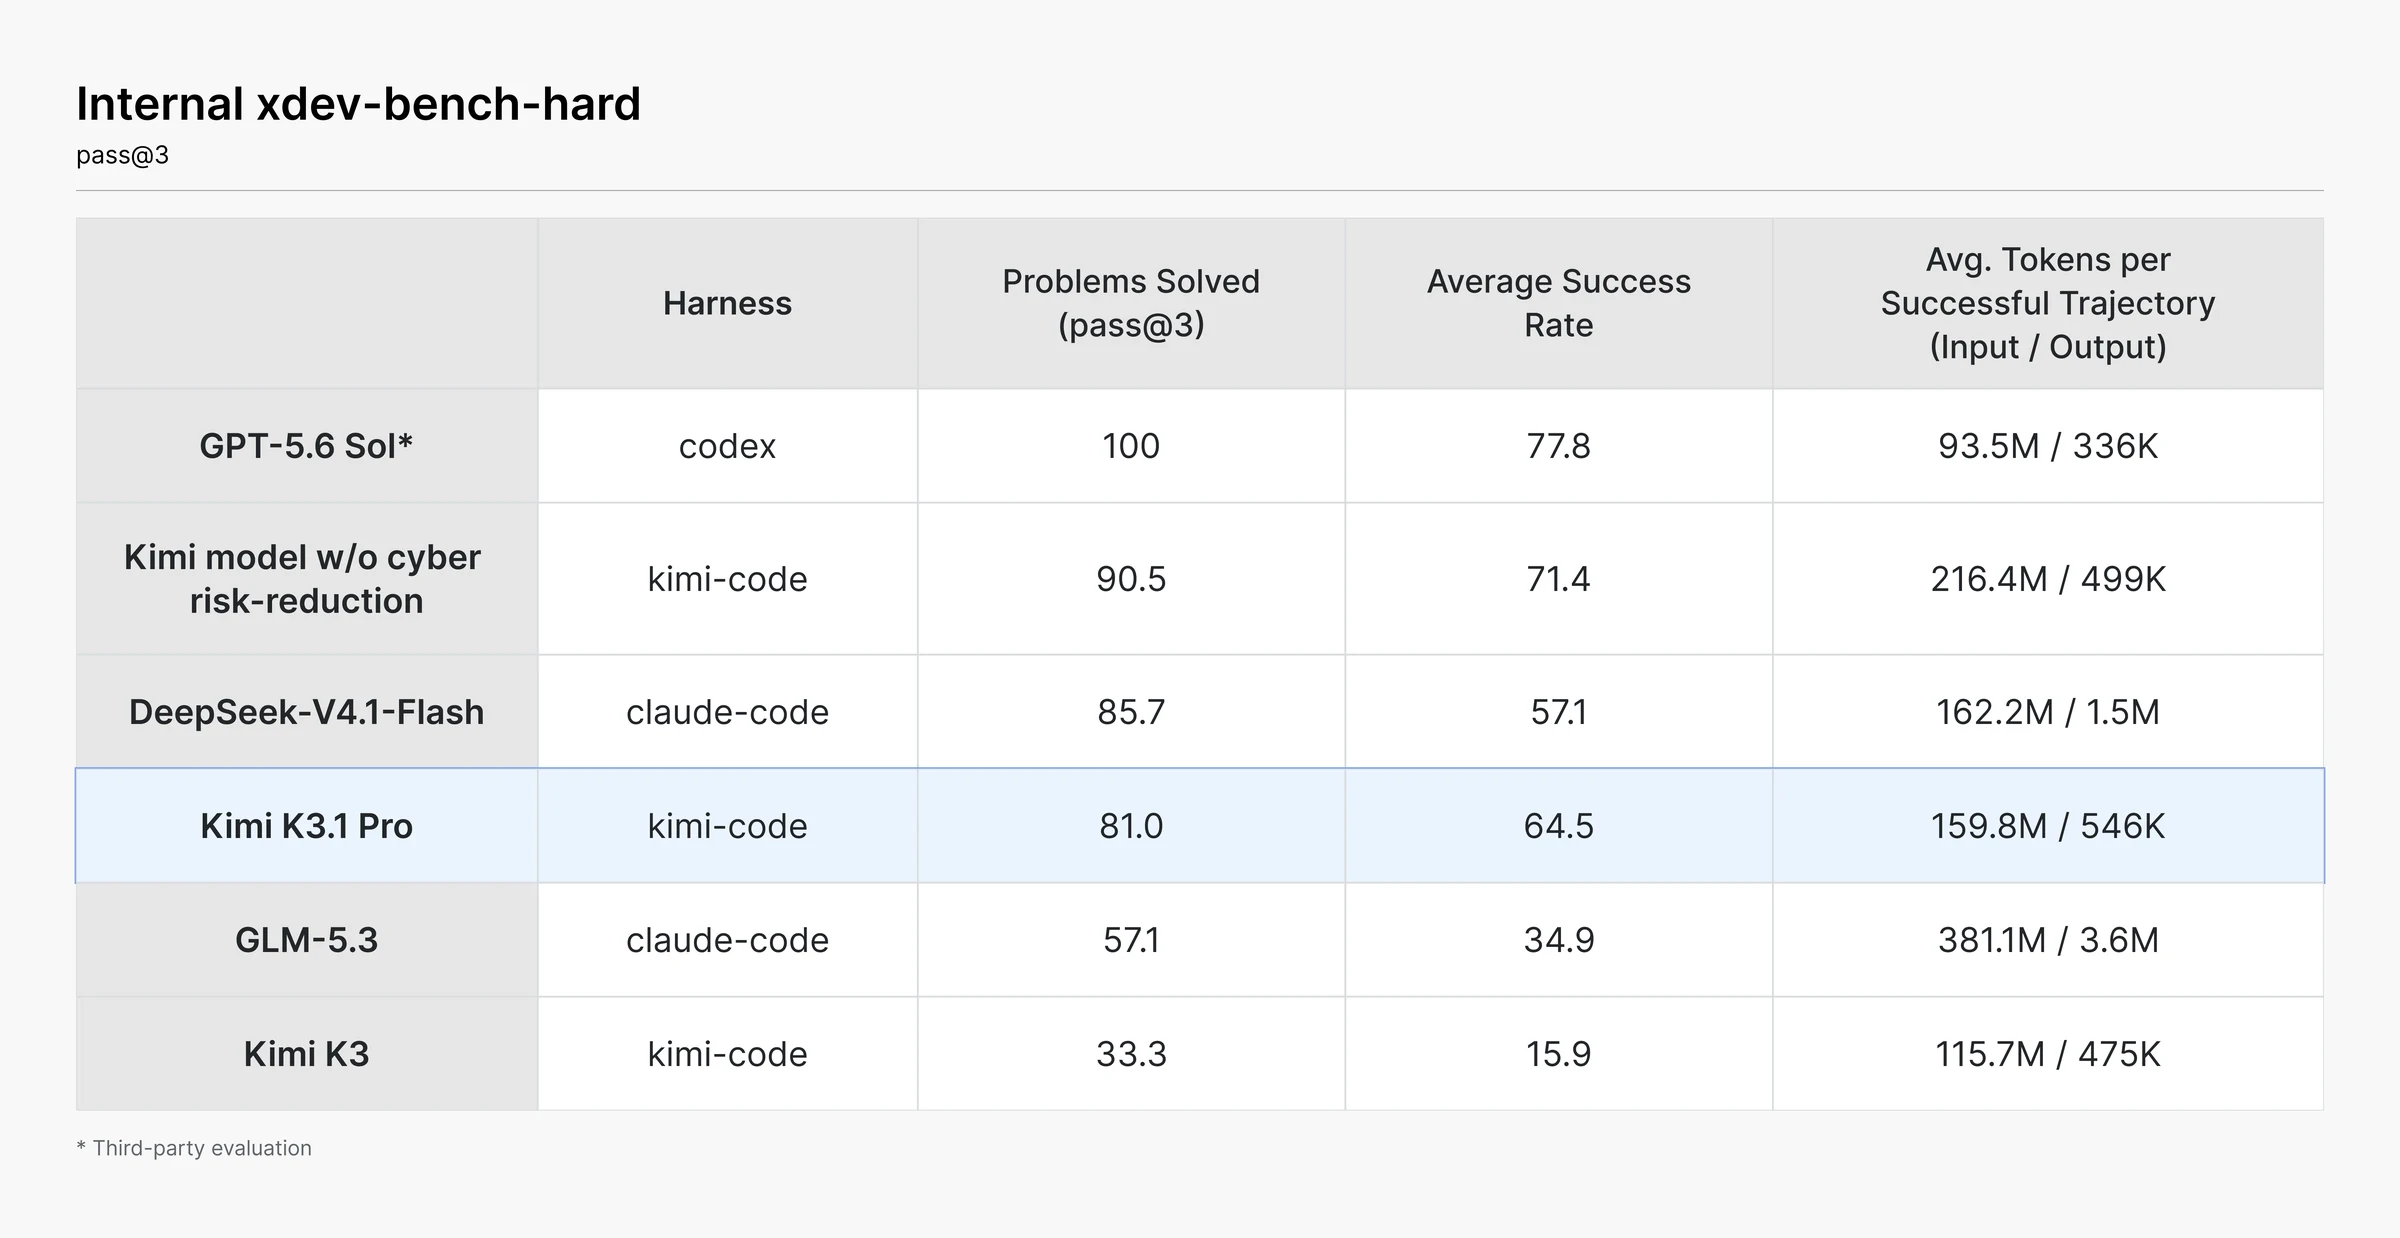 Abbildung: Vergleich im Schwachstellen-Exploit-Benchmark xdev-bench-hard. Beachtenswert ist der Abstand zwischen dem unbeschnittenen Prototyp (90,5 %) und der finalen Open-Source-Version (81,0 %). Quelle: Offizieller Blog von Moonshot AI
Auch der Quervergleich verdeutlicht die Abstufung. Auf demselben Testfeld erreichte DeepSeek-V4.1-Flash 85,7 %, GLM-5.3 kam auf 57,1 % und das Vorgängermodell K3 lediglich auf 33,3 %. Bei Drittanbietertests erzielte das proprietäre Spitzenmodell GPT-5.6 Sol 100 %. Moonshot behielt allgemeine Programmieraufgaben vollständig bei und bereinigte gezielt nur Exploit-Payloads und Schwachstellensuchmuster.
Im technischen Bericht formuliert Moonshot ein klares Fazit: Das Team beabsichtigt nicht, offene Gewichte zu publizieren, die den absoluten Horizont offensiver Cyberangriffe weiter vorantreiben. Moonshot plant, Sicherheitsprüfungsfähigkeiten künftig schrittweise freizugeben, um Verteidigern bei der Auditierung von Legacy-Code zu helfen. Die Offenlegung der Leistungsbilanz vor und nach der Drosselung setzt einen neuen Standard für das Risikomanagement im Open-Source-Ökosystem.
167 Iterationen zur Fehlerdiagnose: Komplexe Code-Optimierung ohne Endlosschleife
Statische Benchmarks bilden oft nur Momentaufnahmen ab. Langwierige Entwicklungsaufgaben fordern hingegen echte logische Tiefe. Im Rahmen des Open-Source-Anatomieprojekts human-atlas sollte das Modell einen Bewegungssimulator für den menschlichen Gang mit 296 Knochen- und 402 Muskelkomponenten konstruieren. Nach 167 aufeinanderfolgenden Aufgaben und 420 unabhängigen Code-Reviews optimierte das Modell die Gehsteuerung von einem anfänglichen Kollaps nach wenigen Sekunden auf einen stabilen Gang über 11,2 Sekunden.
Als das Gangtraining stagnierte, zeigten die Armbewegungen in der Simulation unnatürliche Verzerrungen. Anstatt sich in endlosen Anpassungen der Belohnungsfunktion zu verlieren, untersuchte K3.1 Pro die Dynamik des Simulators selbst. Es identifizierte 36 Berechnungsfehler bei den Hebelarmen der Schultermuskulatur im Dynamikmodul, behob den physikalischen Quellcode und trainierte den Controller anschließend erfolgreich neu.
Diese tiefe Fehlerdiagnose spiegelt sich auch in internen Programmier-Benchmarks wider. Im Kimi Code Bench 3.0 Long-horizon erreichte K3.1 Pro eine Erfolgsquote von 61,2 % – eine Steigerung um 5,25 Prozentpunkte gegenüber K3 (55,95 %). Das Aufspüren subtiler algorithmischer Fehler in physikalischen Simulationen ist eine entscheidende Voraussetzung für autonome Engineering-Agenten.
Werkzeugnutzung auf Augenhöhe mit proprietären Flaggschiffen
Bei Terminal-Interaktionen und Werkzeugverkettungen schließt K3.1 Pro dicht zu führenden geschlossenen Modellen auf. Im Benchmark Terminal-Bench 4.0 unter Verwendung des Claude-Code-Harness erzielte K3.1 Pro 65,7 %. Damit übertrifft das Modell GPT-6 Astra (58,2 %) und nähert sich Claude Opus 5.5 (66,4 %) an. Die souveräne Steuerung mehrstufiger Werkzeugabläufe verringert den Abstand zwischen Open-Source- und proprietären Modellen in der Systemadministration erheblich.
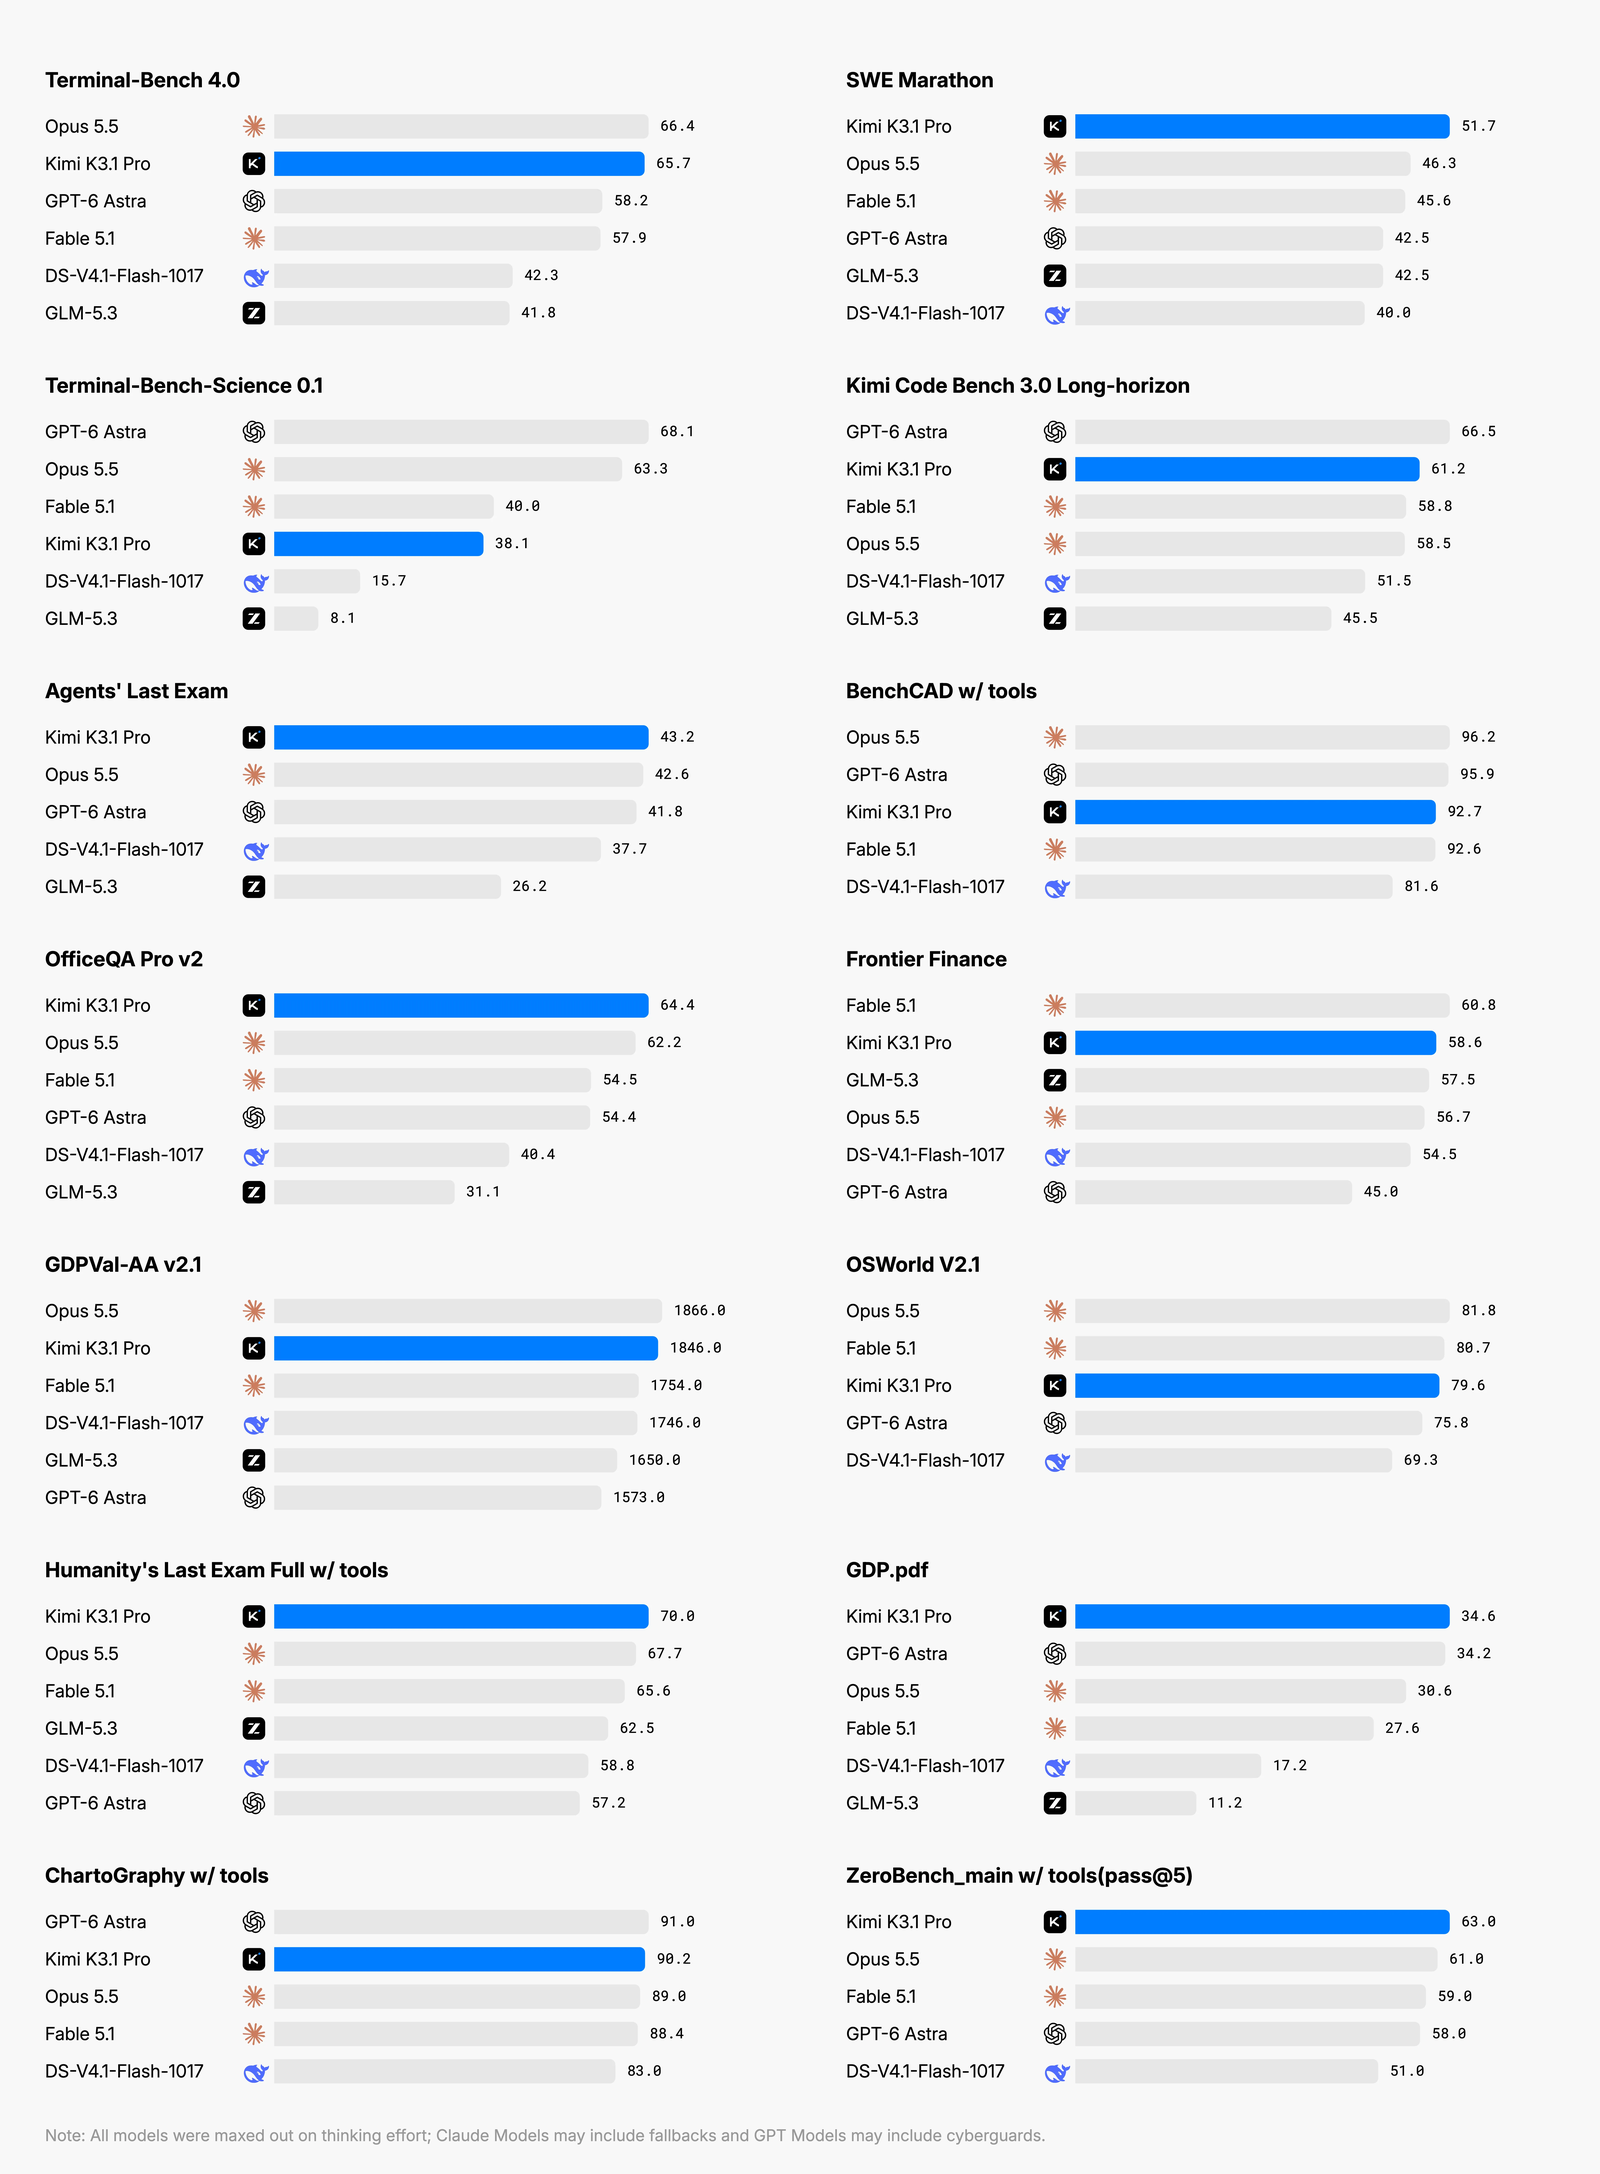 Abbildung: Leistung von K3.1 Pro in 14 Programmier-, Wissenschafts- und Wissens-Benchmarks. Relevant ist die Verteilung unter spezifischen Test-Harnesses statt pauschaler Aussagen. Quelle: Offizieller Blog von Moonshot AI
Der BenchCAD-Benchmark verlangt die Rekonstruktion parametrischen CAD-Codes aus Mehrwinkelbildern anhand von 1.000 ausgewählten Beispielen, bewertet mittels Voxel IoU. Mit Zugriff auf externe Rendering- und Validierungswerkzeuge erreichte K3.1 Pro 92,7 % und zog mit Claude Fable 5.1 (92,6 %) gleich. Zwar liegt dieser Wert knapp hinter Claude Opus 5.5 (96,2 %) und GPT-6 Astra (95,9 %), übertrifft jedoch DeepSeek-V4.1-Flash-1017 (81.6 %) deutlich.
Im reinen Codegenerierungsmodus ohne Werkzeuge behielt K3.1 Pro ein Ergebnis von 72,8 % bei, vergleichbar mit den 73,0 % von Claude Opus 5.5, während DeepSeek ohne Hilfsmittel auf 41,2 % abfiel. Dies belegt, dass das Modell über ein intrinsisches räumlich-geometrisches Verständnis verfügt, das auch ohne externes Feedback stabil bleibt.
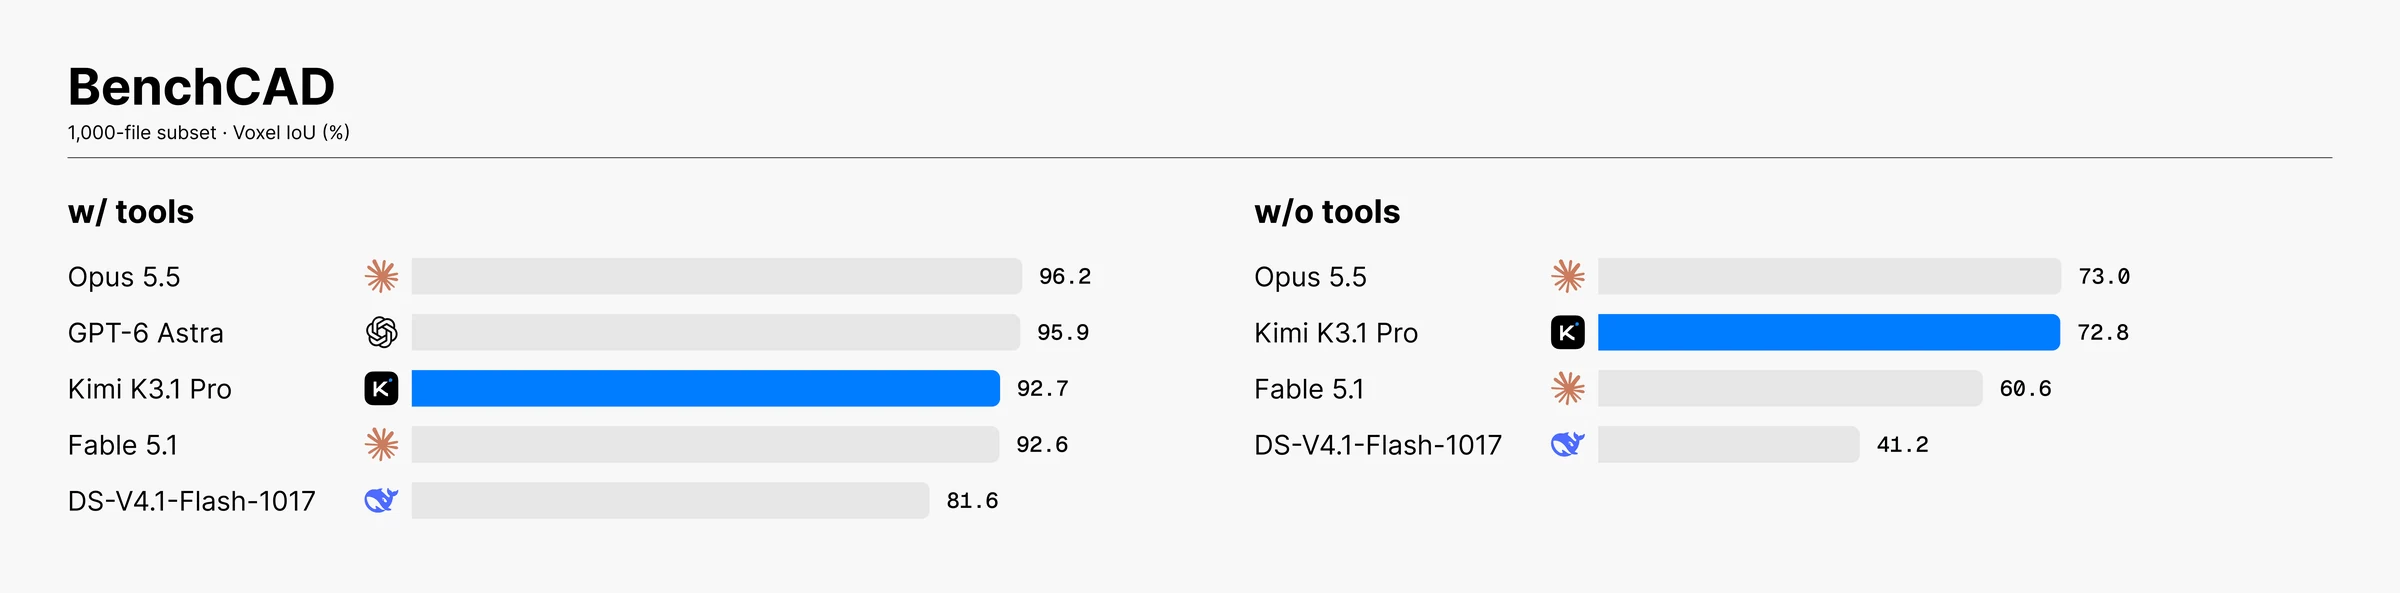 Abbildung: BenchCAD-Evaluation zur CAD-Codegenerierung. Der Voxel-IoU-Unterschied mit und ohne Werkzeugnutzung zeigt, wie Werkzeugumgebungen komplexe logische Stärken vervielfachen. Quelle: Offizieller Blog von Moonshot AI
Auch in anspruchsvollen Dokumenten- und Finanzszenarien überzeugt das Modell. Bei OfficeQA Pro v2, wo vollständige PDFs ausschließlich als Rasterbilder ohne maschinenlesbaren Text bereitgestellt werden, erzielte K3.1 Pro 64,4 Punkte. Finanzmodellierungsaufgaben erreichten 57,6 Punkte, und geschäftliche Betriebsaufgaben stiegen von 8,9 (K3) auf 37 Punkte. Bei der Faktentreue senkte Kimi Hallu Bench Hard die Halluzinationsrate auf Behauptungsebene von 23,4 % auf 8,3 % und halbierte den Anteil fehlerhafter Antworten.
MXFP4-Quantisierung für 3T-Gewichte: Durchsatz und Präzision via QAT
Ein Mixture-of-Experts-Modell mit 3 Billionen Parametern würde bei herkömmlicher 16-Bit-Fließkommadarstellung astronomische VRAM-Anforderungen stellen. K3.1 Pro nutzt quantisierungsbewusstes Training (QAT), um die Gewichte auf das MXFP4-Format zu komprimieren, während Aktivierungen in MXFP8 verbleiben. Dieser Ansatz entlastet Speicherbedarf und Bandbreite und garantiert praxistaugliche Inferenzgeschwindigkeiten für das 1M-Kontextfenster auf Standard-Serverclustern.
Parallel dazu stellte Moonshot die Variante Kimi K3.1 Pro Highspeed vor, deren optimierte Routing-Strategie die Inferenzgeschwindigkeit um das Zwei- bis Dreifache steigert. Bei den Nutzungsrechten setzt das Team auf eine eigene Kimi K3.1 Pro License mit klaren Compliance-Vorgaben für den großflächigen kommerziellen Einsatz, was den Anspruch unterstreicht, die Verbreitung abgeleiteter Modelle verantwortungsvoll zu steuern.
Ingenieurmäßige Selbstbeschränkung als Reifeprüfung für Open Source
Chinesische Spitzenmodelle zeigen je nach technischem Fokus individuelle Stärken. In einer internen Testreihe von Tencent mit 579 Aufgaben zur Finanzlogik erzielte Kimi K3.1 Pro 2,68 Punkte gegenüber 2,97 Punkten für DeepSeek-V4.1-Flash-1017, was unterschiedliche Schwerpunkte im praktischen Einsatz widerspiegelt.
Das entscheidende Signal von K3.1 Pro liegt in der Offenlegung der gezielten Leistungsreduktion. Bei Modellen mit 3 Billionen Parametern und 1 Million Token Kontext müssen Entwickler zwischen absolutem Leistungsanspruch und Missbrauchsrisiken abwägen. Mit detaillierten Daten beweist Moonshot Verantwortungsbewusstsein. Grenzen zu definieren und Sicherheitskosten zu tragen, ist der entscheidende Schritt, um offenen Modellen langfristiges Vertrauen zu sichern.
Weiterführende Links:
- Offizieller Moonshot AI Release-Blog
- Technischer Bericht und Open-Source-Dokumentation zu Kimi K3.1 Pro
- Terminal-Bench 4.0 Offizielle Bestenliste
- BenchCAD-Paper und Testset-Spezifikationen