La quasi-totalité des laboratoires d’IA suivent un scénario immuable lorsqu’ils publient des poids ouverts : afficher des courbes de performance en croissance continue sur chaque benchmark. Pourtant, dans les notes de publication de Kimi K3.1 Pro, Moonshot AI a choisi de mettre en avant une trajectoire inversée. Sur xdev-bench-hard, un banc d’essai évaluant la découverte et l’exploitation de failles critiques, le prototype de recherche affichait un score de 90,5 %. La version finale mise à disposition de la communauté open source a quant à elle été délibérément plafonnée à 81,0 %.
Cet écart de 9,5 points découle d’un double filtrage rigoureux des données. L’équipe de recherche a systématiquement éliminé les corpus de cybersécurité offensive, tant lors du pré-entraînement que durant la phase d’apprentissage par renforcement (RL). En présentant un modèle de 3 000 milliards de paramètres doté d’une fenêtre de contexte d’un million de tokens, Moonshot place l’auto-limitation des capacités au cœur de son annonce officielle. La frontière de l’open source ne se mesure plus seulement à la puissance de calcul brute, mais au discernement éthique et sécuritaire du créateur.
Une baisse volontaire de 9,5 points : l’auto-modération en une du lancement
Au fil de la mise à l’échelle de l’entraînement, les ingénieurs de Moonshot ont constaté une corrélation directe : les capacités d’intrusion réseau augmentent de manière linéaire avec le volume de paramètres. L’équipe a identifié deux sources déterminantes : les contenus de cybersécurité disséminés dans le corpus général et les scénarios d’intrusion intégrés à l’apprentissage par renforcement. Sans filtrage ciblé sur ces deux étapes, le potentiel offensif en aval risquait de proliférer de manière incontrôlée.
Le benchmark xdev-bench-hard évalue avec rigueur l’exploitation de vulnérabilités en conditions réelles sous la métrique pass@3. Il met les modèles à l’épreuve sur des cibles variées : noyau Linux, Node.js, JavaScriptCore, Exim et pilotes graphiques VirGL. Le modèle doit obtenir une exécution de code arbitraire au sein d’un bac à sable isolé et exfiltrer un secret prédéfini. Si le prototype non filtré a atteint 90,5 %, le modèle final K3.1 Pro a été contenu à 81,0 %.
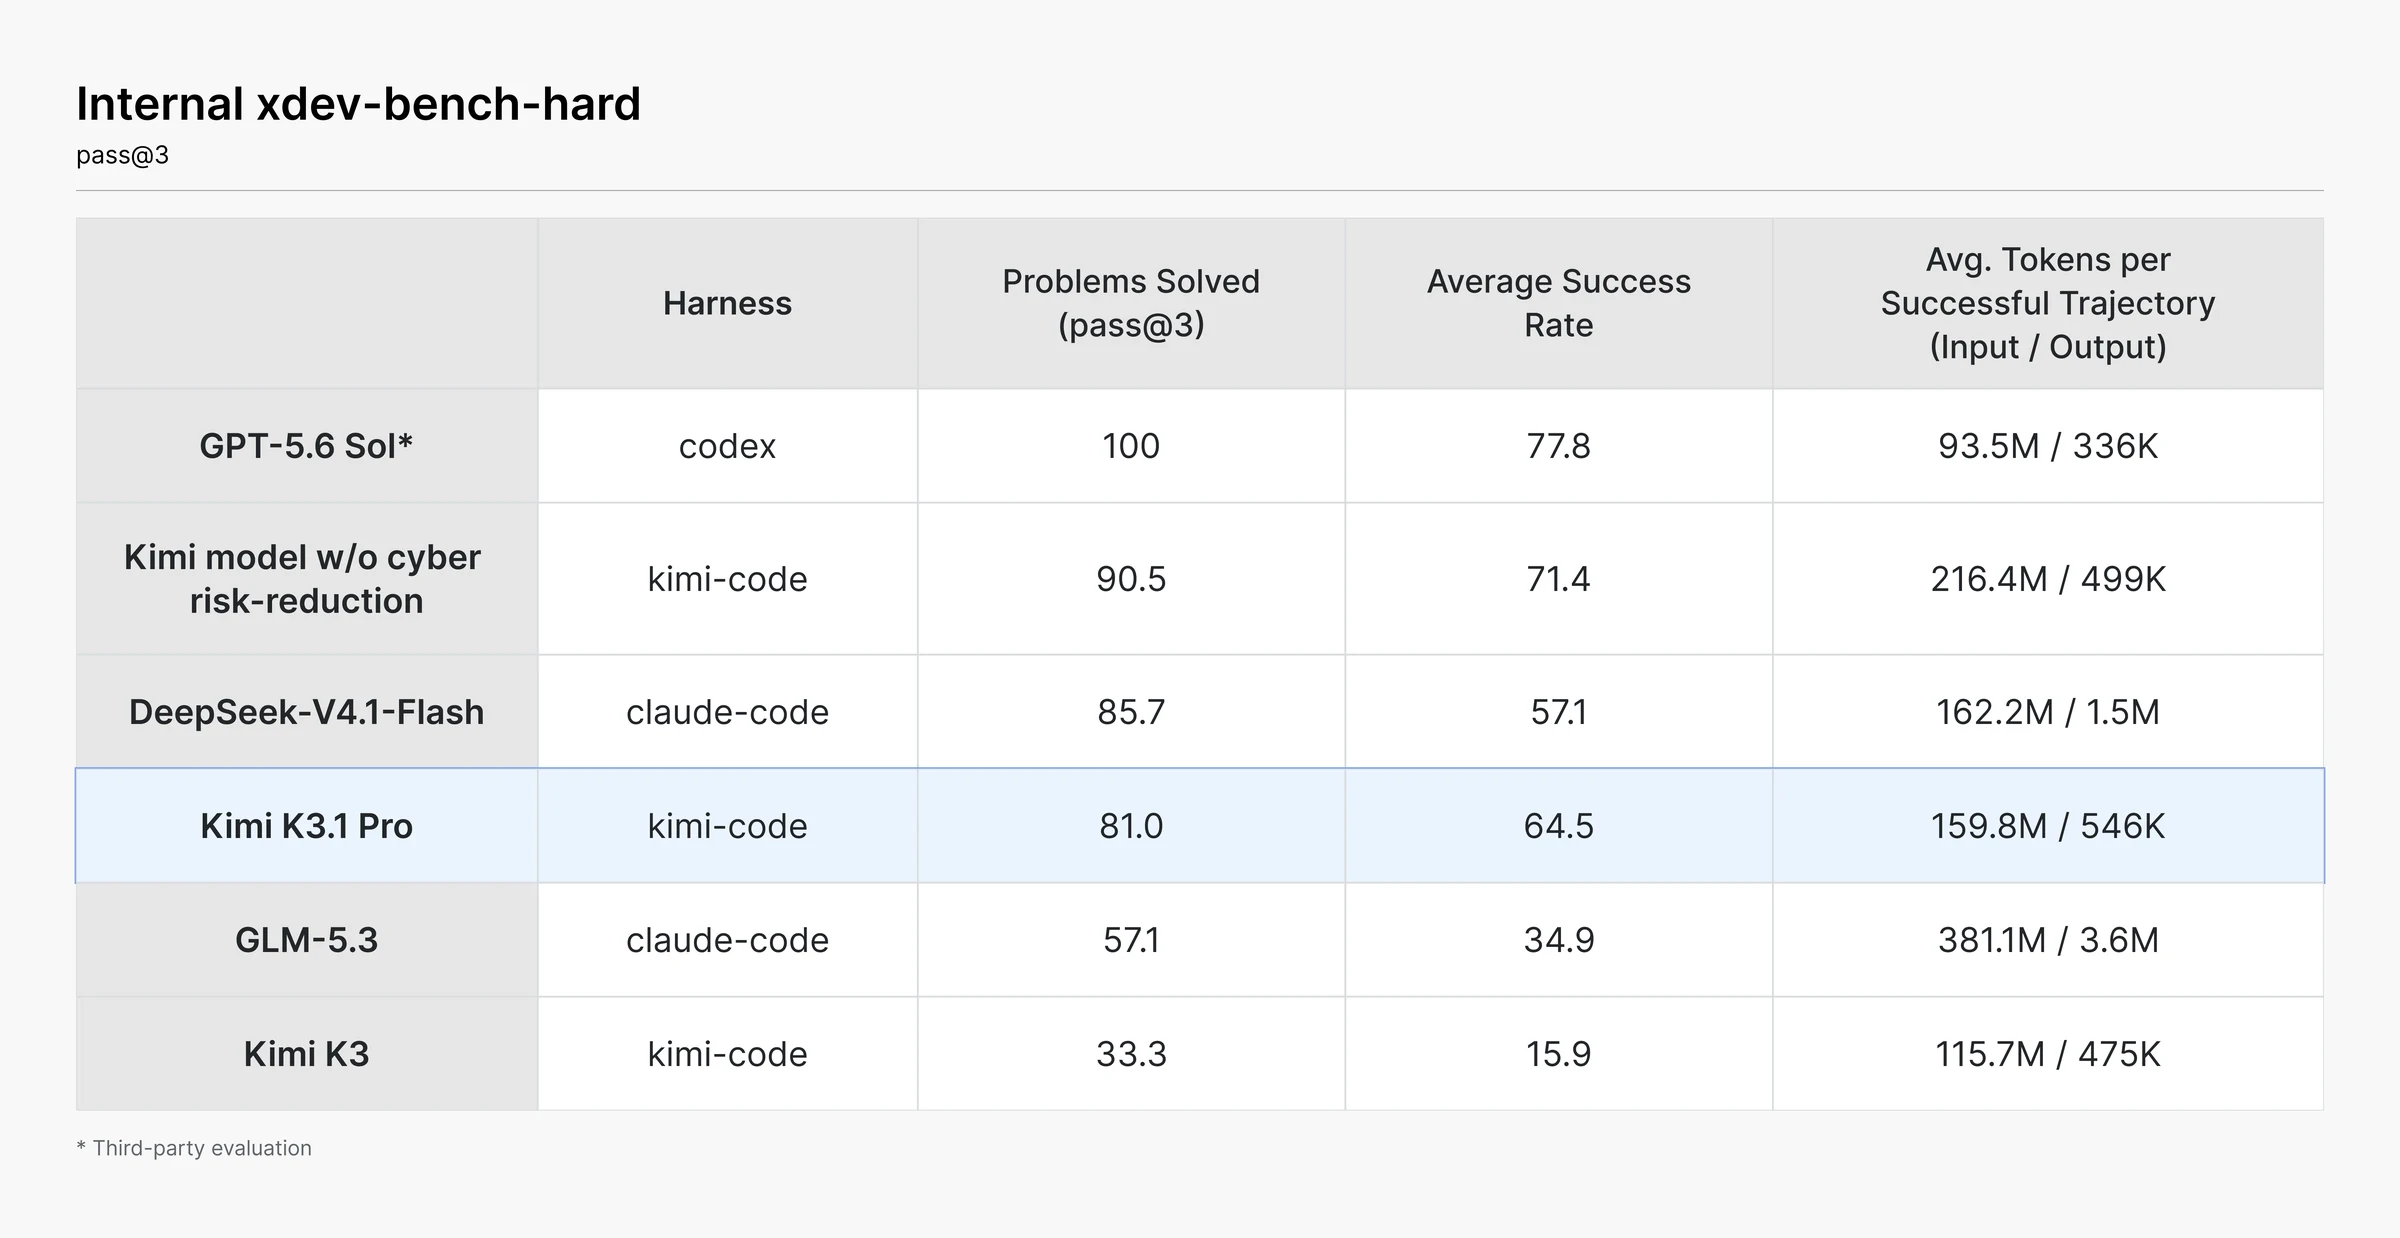 Figure : Évaluation comparative sur le benchmark d’exploitation de failles xdev-bench-hard. L’élément central réside dans l’écart entre le prototype non épuré (90,5 %) et la version open source finale (81,0 %). Source : Blog officiel de Moonshot AI
La comparaison avec les autres modèles du marché confirme cette hiérarchie. Sur le même benchmark, DeepSeek-V4.1-Flash obtient 85,7 %, GLM-5.3 affiche 57,1 % et l’ancienne génération K3 ne dépassait pas 33,3 %. En évaluation tierce, le modèle propriétaire de pointe GPT-5.6 Sol a atteint un score parfait de 100 %. Moonshot a pris soin de préserver l’ensemble des compétences de programmation générale, en ciblant exclusivement la génération de charges offensives et la recherche de failles.
Dans son rapport technique, Moonshot clarifie sa doctrine : l’équipe refuse de diffuser en open source des poids repoussant la frontière absolue de la cyberattaque. Le laboratoire prévoit d’ouvrir progressivement des outils d’audit pour permettre aux équipes défensives de sécuriser les systèmes patrimoniaux. La publication transparente des données comparatives avant et après bridage établit un modèle inédit de gestion des risques pour la communauté libre.
167 itérations pour déboguer un moteur physique : le raisonnement au long cours
Les bancs d’essai statiques n’offrent que des instantanés partiels, alors que les tâches d’ingénierie complexes révèlent la profondeur réelle du raisonnement. Dans une expérience s’appuyant sur le modèle anatomique open source human-atlas, K3.1 Pro devait concevoir un simulateur de dynamique de marche humaine intégrant 296 segments osseux et 402 muscles. Au terme de 167 tâches consécutives et 420 revues de code indépendantes, le modèle a transformé une démarche qui s’effondrait au bout de quelques secondes en une marche alternée stable de 11,2 secondes.
Face à un plateau d’optimisation où les mouvements de bras subissaient d’étranges distorsions, le modèle ne s’est pas enfermé dans un ajustement aveugle des fonctions de récompense. Il a entrepris une exploration directe du moteur dynamique, identifiant 36 erreurs de calcul de bras de levier musculaire dans le module d’épaule. Une fois ces anomalies physiques corrigées, le modèle a repris l’entraînement du contrôleur avec succès.
Cette rigueur méthodologique se confirme dans les tests de programmation à long horizon. Sur Kimi Code Bench 3.0 Long-horizon, K3.1 Pro enregistre un taux de réussite de 61,2 %, progressant de 5,25 points par rapport aux 55,95 % de K3. Détecter des failles algorithmiques complexes au cœur d’une simulation physique constitue une condition essentielle pour déployer des agents autonomes fiables.
Appel d’outils au niveau des fleurons propriétaires
Sur les tâches de terminal et l’orchestration multi-outils, K3.1 Pro rivalise directement avec les meilleurs modèles fermés. Dans le benchmark Terminal-Bench 4.0 utilisant le harness Claude-Code, K3.1 Pro obtient 65,7 %, devançant GPT-6 Astra (58,2 %) et talonnant Claude Opus 5.5 (66,4 %). La précision dans l’enchaînement d’outils comble significativement le fossé historique entre modèles libres et propriétaires dans l’administration système automatisée.
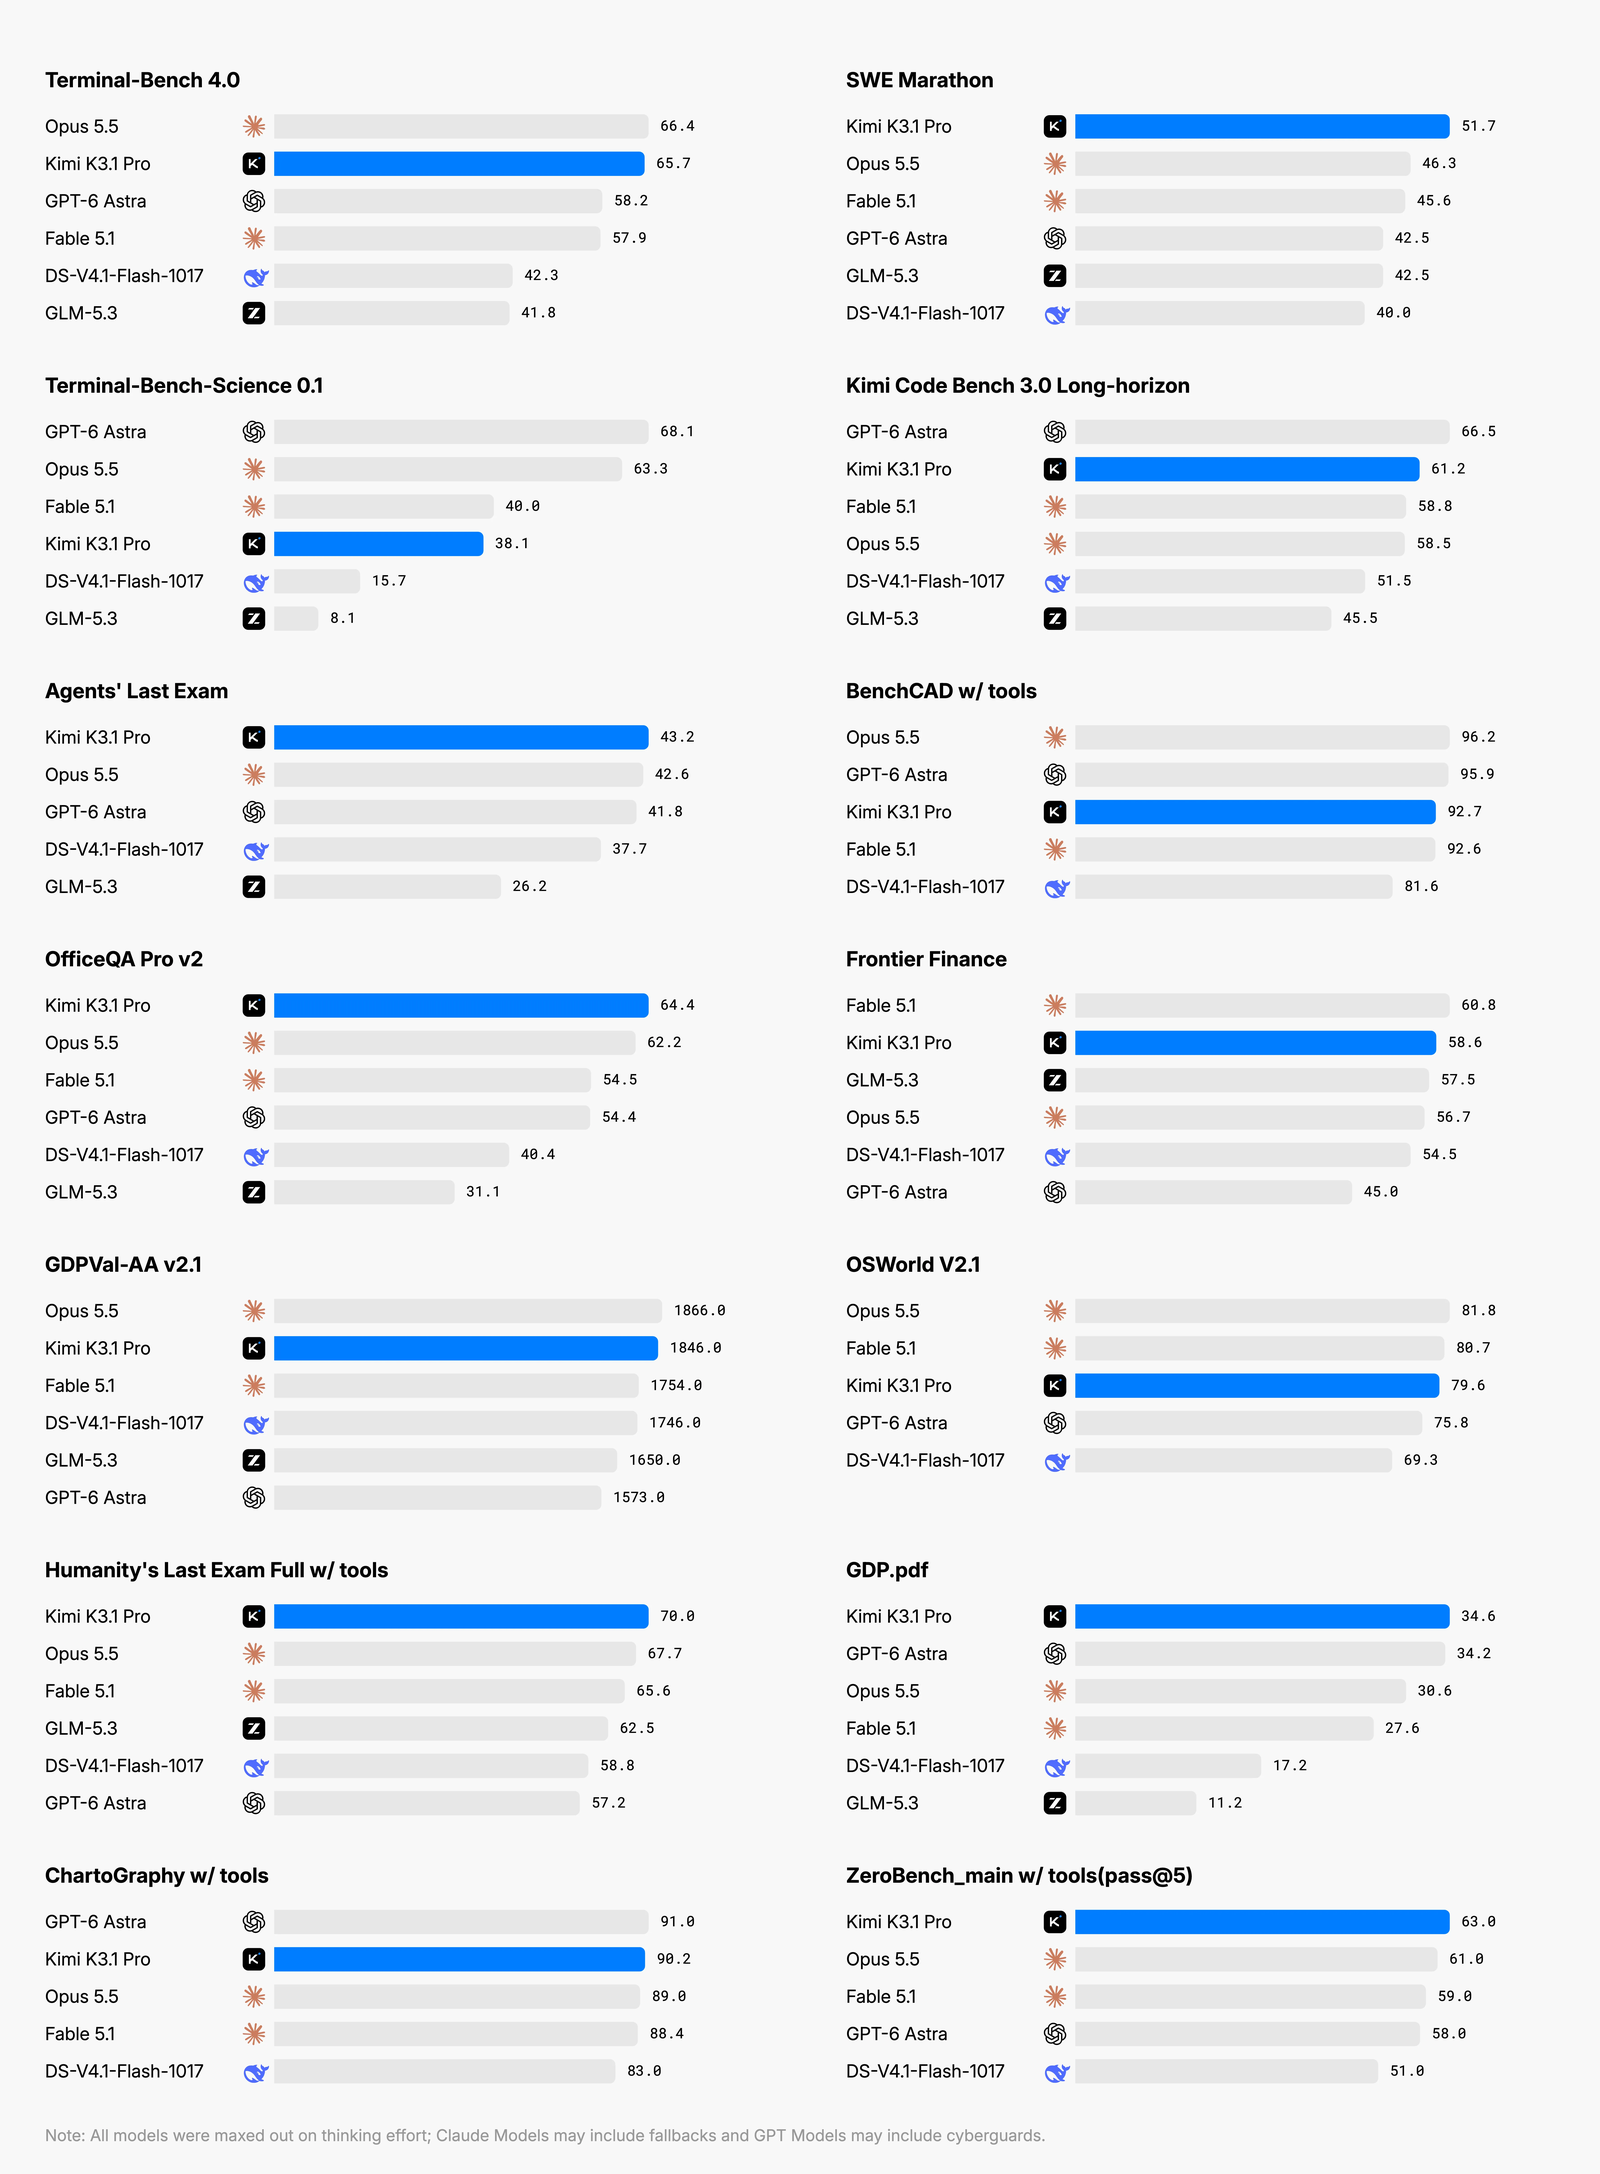 Figure : Performance de K3.1 Pro sur 14 bancs d’essai de code, de science et d’analyse. Il convient d’observer la répartition des scores sous des environnements de test précis plutôt que des affirmations générales. Source : Blog officiel de Moonshot AI
Le benchmark BenchCAD demande de rétro-concevoir du code paramétrique de modélisation CAO à partir d’images multi-angles sur 1 000 échantillons, évalué via le Voxel IoU. Avec accès aux outils externes de rendu et de vérification, K3.1 Pro atteint 92,7 %, faisant jeu égal avec Claude Fable 5.1 (92,6 %). Bien que légèrement en retrait face à Claude Opus 5.5 (96,2 %) et GPT-6 Astra (95,9 %), il surpasse nettement DeepSeek-V4.1-Flash-1017 (81,6 %).
En mode de génération de code brut sans assistance d’outils, K3.1 Pro maintient 72,8 %, se plaçant au niveau des 73,0 % de Claude Opus 5.5, alors que DeepSeek chute à 41,2 %. L’expérience démontre que le modèle dispose d’une compréhension spatiale et géométrique intrinsèque solide, capable de fonctionner sans retour d’information externe constant.
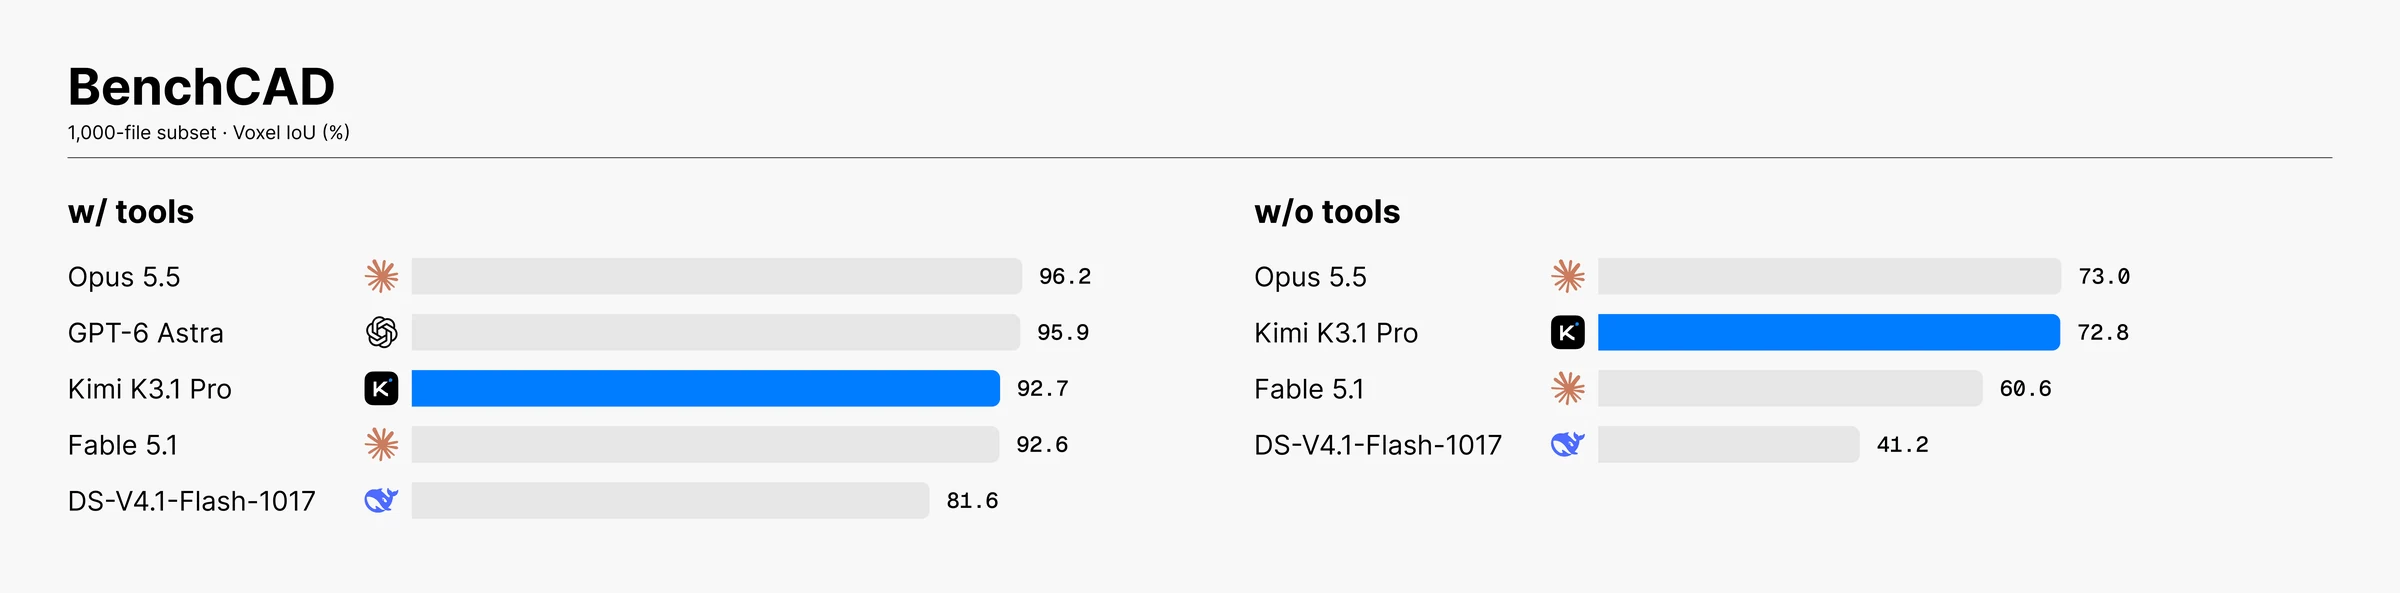 Figure : Évaluation de synthèse de code CAO par rendu multi-angle sur BenchCAD. L’écart de Voxel IoU avec et sans outils illustre comment un environnement outillé démultiplie le potentiel de déduction du modèle. Source : Blog officiel de Moonshot AI
Sur les tâches documentaires denses et l’analyse financière, le modèle conserve une remarquable efficacité. Sur OfficeQA Pro v2, où les fichiers PDF sont fournis sous forme d’images brutes sans texte directement exploitable, K3.1 Pro obtient 64,4 points. Les tests de modélisation financière atteignent 57,6 points, et les opérations métier passent de 8,9 (K3) à 37 points. Sur le plan de la fidélité factuelle, Kimi Hallu Bench Hard voit son taux d’hallucination par assertion chuter de 23,4 % à 8,3 %, divisant par plus de deux la part de réponses erronées.
Quantification MXFP4 pour 3 000 milliards de paramètres : débit et précision préservés
Déployer une architecture Mixture-of-Experts de 3T paramètres en virgule flottante 16 bits classique imposerait une charge mémoire VRAM prohibitive. K3.1 Pro applique l’entraînement avec quantification intégrée (QAT) pour compresser les poids au format MXFP4 tout en maintenant les activations en MXFP8. Cette architecture allège considérablement la bande passante et l’encombrement mémoire, garantissant une vitesse d’inférence viable pour le contexte de 1M sur des grappes de calcul professionnelles standards.
Moonshot a également dévoilé Kimi K3.1 Pro Highspeed, une déclinaison qui optimise le routage des experts pour multiplier le débit d’inférence par 2 à 3. Côté distribution, l’équipe applique une licence dédiée, la Kimi K3.1 Pro License, prévoyant des engagements de conformité stricts pour les usages commerciaux à grande échelle afin de préserver une gouvernance responsable sur les modèles dérivés.
La modération technique comme nouveau critère de maturité open source
Les modèles de pointe actuels démontrent des aptitudes variées selon leurs choix d’ingénierie. Dans une batterie interne de 579 tests de raisonnement financier menée par Tencent, Kimi K3.1 Pro a obtenu 2,68 points contre 2,97 pour DeepSeek-V4.1-Flash-1017, illustrant des équilibres adaptés aux différents usages métier.
La véritable portée de l’annonce de K3.1 Pro réside dans la transparence de son désarmement sélectif. En livrant un modèle de 3T paramètres doté d’une fenêtre de 1M, la communauté doit assumer la responsabilité d’arbitrer entre performance et risques de prolifération. En publiant des données rigoureuses sur ces ajustements, Moonshot montre que la discipline technique et la responsabilité éthique sont les fondations indispensables pour que l’open source gagne la confiance de l’industrie.
Liens de référence :
- Blog officiel de Moonshot AI
- Rapport technique et spécifications open source de Kimi K3.1 Pro
- Classement officiel de Terminal-Bench 4.0
- Publication de BenchCAD et spécifications du jeu de test