フロンティアAIラボがオープンウェイトモデルを公開する際、スコアが単調増加するグラフを誇示するのが通例だ。しかし、Moonshot AI(月之暗面)が「Kimi K3.1 Pro」のリリースノートで前面に押し出したのは、真逆のデータだった。高危険度な脆弱性発掘・悪用能力を評価するベンチマーク「xdev-bench-hard」において、研究開発プロトタイプのスコアは90.5%に達していた。しかし、コミュニティに最終提供されたオープンウェイトのスコアは、意図的に81.0%へと抑え込まれている。
この9.5ポイントの落差は、意図的な2重のデータフィルタリングによるものだ。開発チームは事前学習と強化学習(RL)の双方から、攻撃的サイバーセキュリティ関連コーパスを徹底的に排除した。3兆パラメータ(3T)と100万トークン(1M)のコンテキスト窓を誇る超大型モデルのトップページに、自ら課した機能制限を明記したのである。オープンフロンティアの競争境界は、計算リソースの規模から、開発元の安全判断力へとシフトし始めている。
あえて9.5ポイント引き下げ:リリースノート冒頭に掲げた自制
スケーリング実験の中で、開発陣は明確な法則を確認した。サイバー侵入能力はパラメータ規模に比例して確実に増大するということだ。チームは二つのデータ源を特定した。汎用コーパスに含まれるセキュリティ解説・エクスプロイト情報と、強化学習環境に組み込まれた侵入タスクである。双方でデータ排除を行わなければ、下流での攻撃能力が爆発的に拡散してしまう。
独自ベンチマーク「xdev-bench-hard」は、現実世界の脆弱性悪用レベルをpass@3で厳密に測定する。対象はLinuxカーネル、Node.js、JavaScriptCore、Exim、VirGLグラフィックスドライバ多岐にわたる。隔離されたサンドボックス環境内で任意のコード実行(RCE)を成立させ、指定されたシークレットを外部へ送信できるかが問われる。未調整のプロトタイプは90.5%を叩き出したが、最終的なK3.1 Proでは81.0%へと安全マージンが確保された。
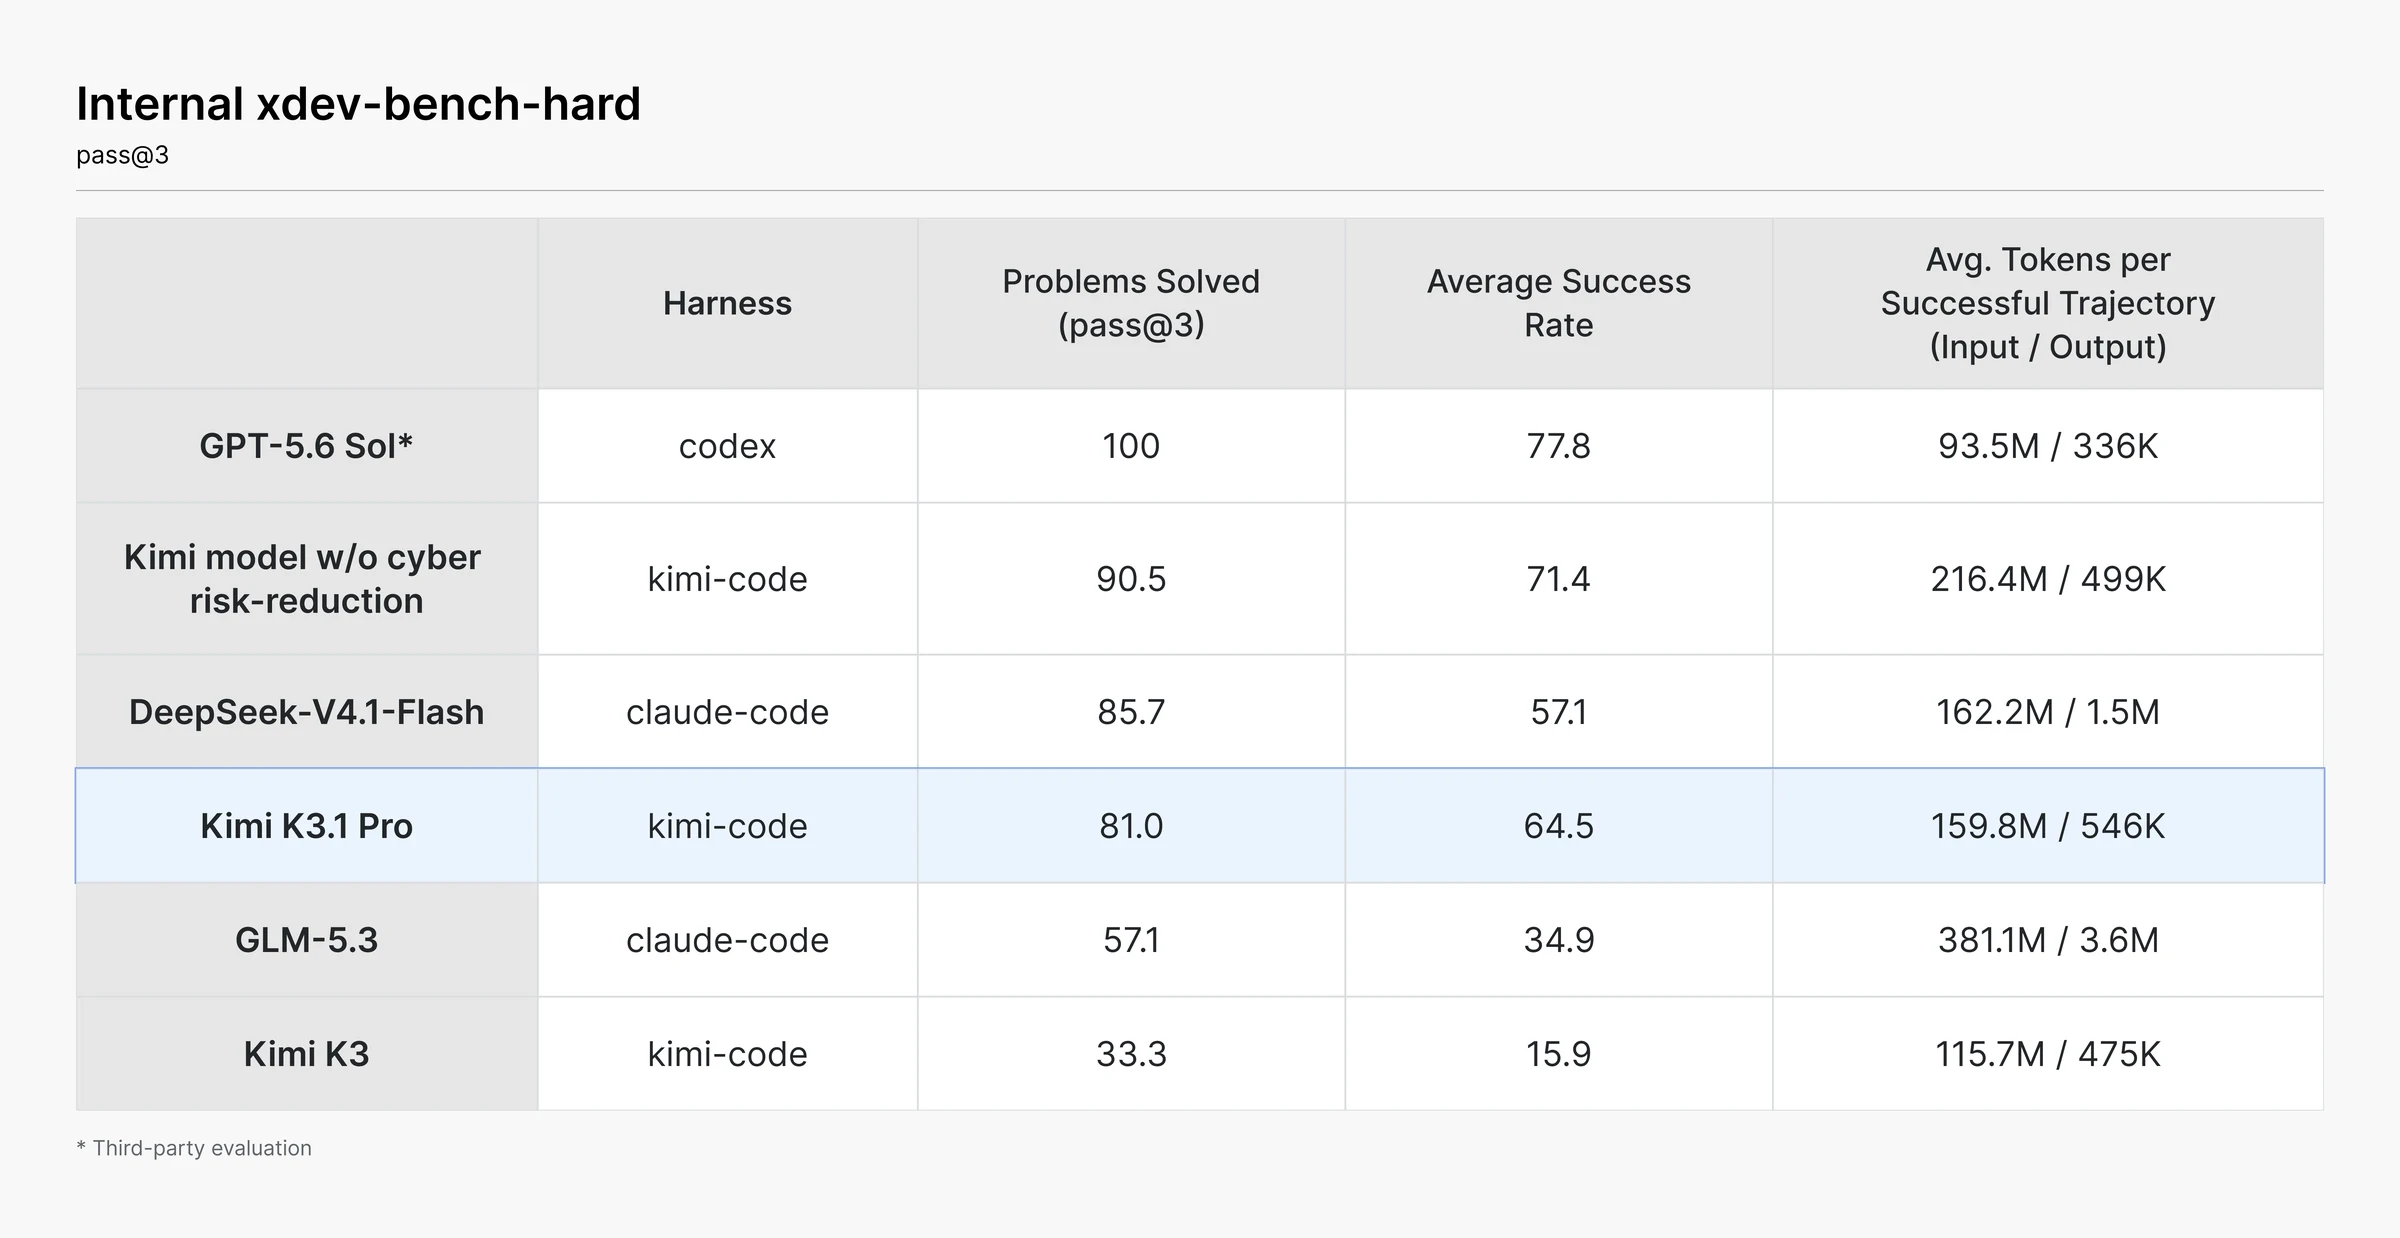 図:xdev-bench-hardにおける脆弱性悪用評価の対比。未調整プロトタイプの90.5%と最終オープン版81.0%のギャップに注目すべきである。出典:Moonshot公式ブログ
横並びの比較でも能力の階段が浮かび上がる。同ベンチマークでDeepSeek-V4.1-Flashは85.7%、GLM-5.3は57.1%、前世代K3は33.3%にとどまる。サードパーティ評価では、商用プロプライエタリモデルのGPT-5.6 Solが100%を記録した。Moonshotは汎用プログラミング能力を完全に維持しつつ、脆弱性悪用と攻撃ペイロードの生成に特化して選別・除去を実行した。
テクニカルレポートにおいて、チームは明確な方針を宣言している。「サイバー攻撃能力の絶対的フロンティアを押し広げるオープンウェイトを公開する意志はない」。今後は防御側がレガシーシステムの監査を行えるよう段階的に監査能力を開放していく予定だという。制限前後のデータを包み隠さず対比開示した姿勢は、オープンソースエコシステムに新たなリスク管理の基準を示している。
167回のイテレーションで物理エンジンを調査:無限ループを脱出する長文コード推論
静的なベンチマークは断片的な能力しか捉えられないが、長周期の複雑なエンジニアリングタスクこそが推論の深度を浮き彫りにする。人体解剖オープンソースモデル「human-atlas」を用いた実験では、296の骨格パーツと402の筋肉パーツからなる人体歩行シミュレータの構築に挑んだ。167回の連続タスクと420回の独立コードレビューを経て、モデルは数秒で崩れ落ちていた歩行制御を、11.2秒間の安定した交互歩行へと進化させた。
歩行学習が頭打ちになった際、シミュレータ内の腕の動きに不自然な歪みが生じた。モデルは報酬関数の微調整を延々と繰り返す定石を捨て、シミュレータ自体の物理演算機構に対するオープンループな探索へ切り替えた。そして動力学モジュール内の肩部筋肉力モーメント計算に潜んでいた36箇所のバグを自ら特定・修正し、その上でコントローラの再学習を完遂したのである。
この深いデバッグ能力は、独自の長文コーディング評価にも表れている。「Kimi Code Bench 3.0 Long-horizon」において、K3.1 Proは61.2%の通過率を記録。前世代K3の55.95%から5.25ポイントの向上を達成した。物理シミュレータのアルゴリズム的欠陥を自力で診断できる力こそ、自律エンジニアリングを完遂するための前提条件となる。
プロプライエタリの基準に並ぶツール実行力:実環境が証明する推論深度
ターミナル操作と複数ツールの連携評価において、K3.1 Proは商用トップモデルに肉薄する性能を見せた。Claude-Codeハーネスを用いた「Terminal-Bench 4.0」において、K3.1 Proは65.7%を記録。GPT-6 Astra(58.2%)を凌駕し、Claude Opus 5.5(66.4%)に迫る水準だ。マルチツール連動の精密な制御は、オープンモデルとクローズドモデルの自動運用領域における世代格差を確実に縮めている。
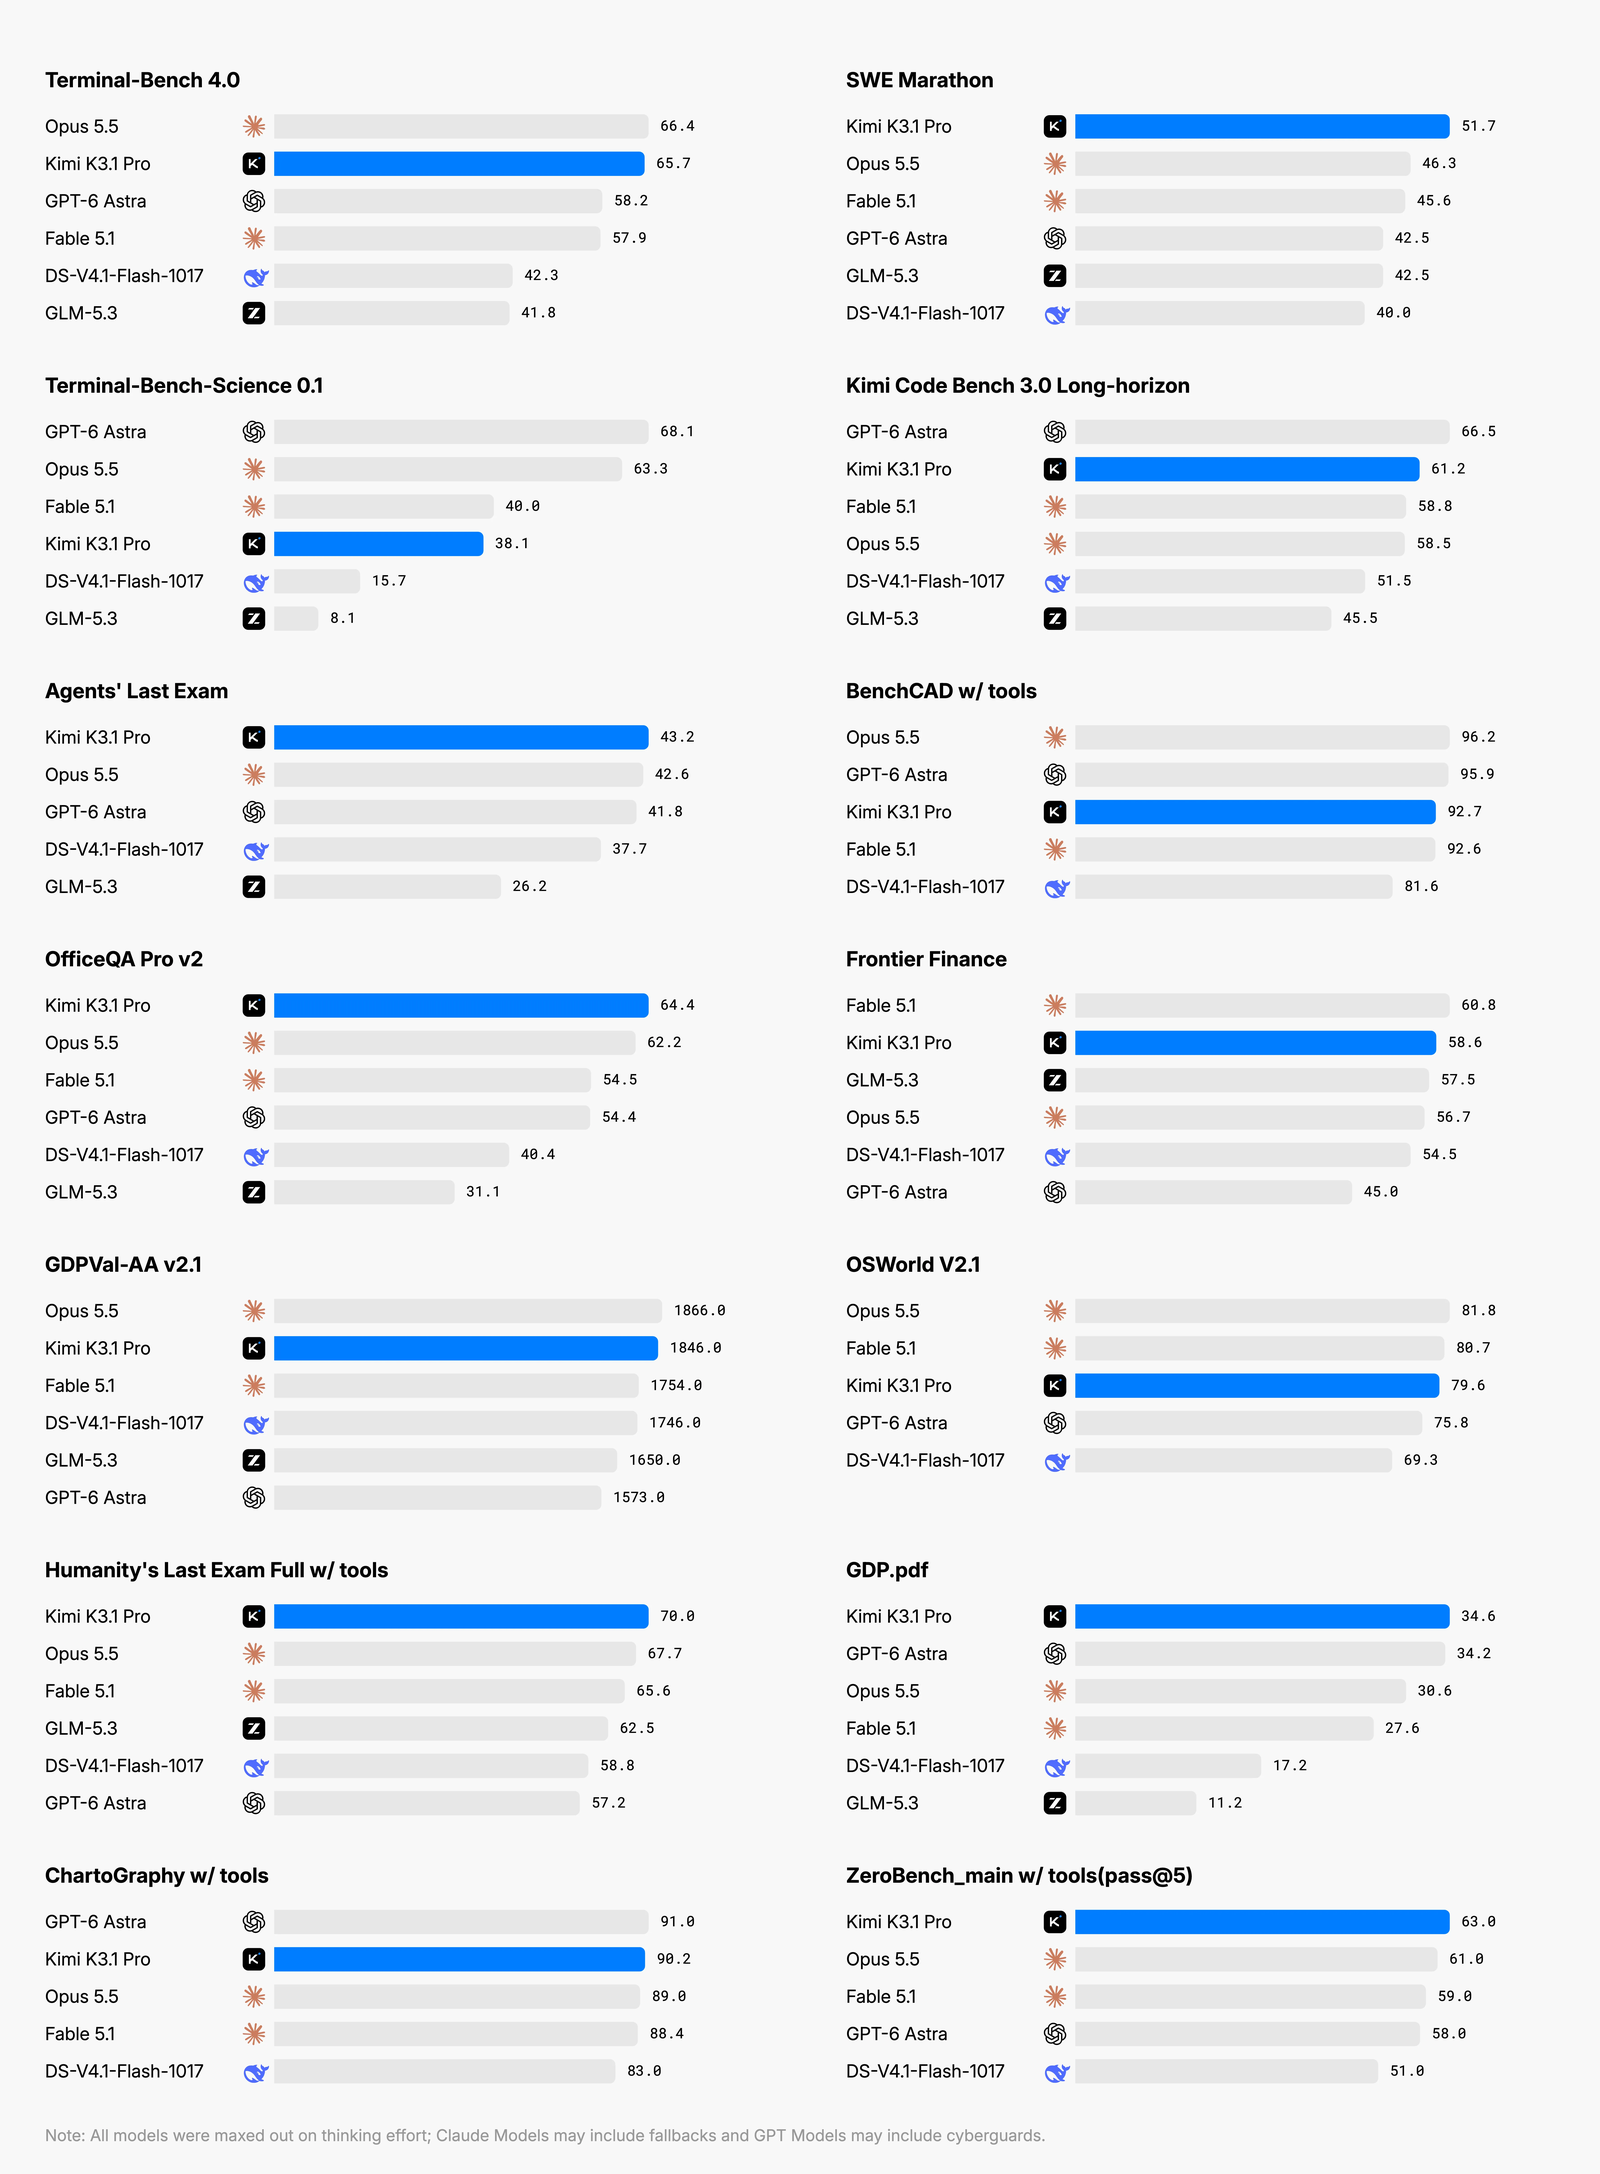 図:K3.1 Proにおける14項目のコーディング・科学・ナレッジワーク評価スコア。単なる勝敗ではなく特定ハーネス下での分布傾向を読み解くことが肝要である。出典:Moonshot公式ブログ
「BenchCAD」は、マルチアングル画像からCADモデリングコードを逆推論するテストで、1,000件の精選サンプルを用いVoxel IoUで採点される。外部レンダリングおよび検証ツールを連携させた場合、K3.1 Proは92.7%を達成し、Claude Fable 5.1(92.6%)と肩を並べた。Claude Opus 5.5(96.2%)やGPT-6 Astra(95.9%)には及ばないものの、DeepSeek-V4.1-Flash-1017(81.6%)を大きく引き離している。
さらに外部ツール無しのコード生成モードでも72.8%を維持し、Claude Opus 5.5の73.0%と同等だった(同条件下でのDeepSeekは41.2%)。外部ツールの支援がなくとも、モデル自身の幾何学的空間推論能力が堅牢に保持されていることが実証された。
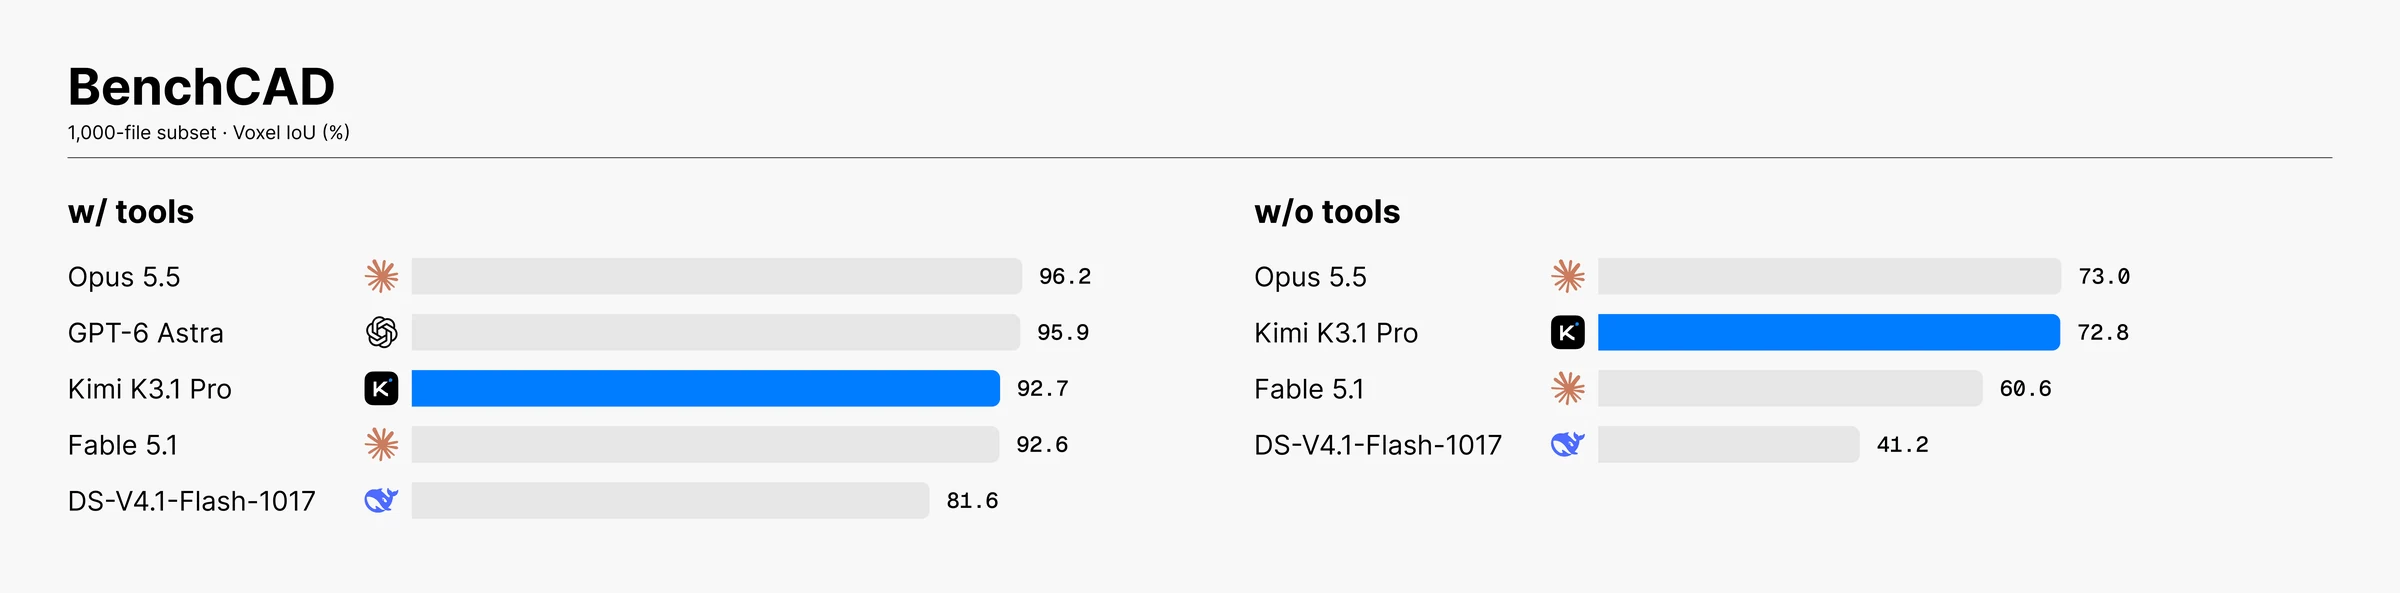 図:BenchCADマルチビュー推論テストにおけるツール活用の有無とVoxel IoUの格差。ツール環境がモデルの推論深度を何倍にも引き出す様子が示されている。出典:Moonshot公式ブログ
テキスト読解と専門分析においても極めて高い情報密度を保つ。検索可能なテキストが存在しない画像化PDFのみを入力とする「OfficeQA Pro v2」で64.4点を獲得。金融モデリング評価は57.6点に達し、業務オペレーションタスクでは旧世代K3の8.9点から37点へと跳ね上がった。事実性の制御では、「Kimi Hallu Bench Hard」におけるクレーム単位のハルシネーション率が23.4%から8.3%へと急減し、事実誤認を含む回答が半減した。
MXFP4量子化で3Tウェイトを圧縮:スループットと精度を両立するQAT
3T規模のMoE(Mixture of Experts)モデルを標準的な16ビット浮動小数点数で運用すれば、VRAM消費は実運用を阻む壁となる。K3.1 Proは量子化を意識した学習(QAT)を適用し、ウェイトをMXFP4形式へと圧縮、アクティベーションはMXFP8に保った。これによりメモリ占有量と帯域幅の負荷を劇的に低減し、1Mトークンの超長文脈でも実稼働クラスタ上で十分な推論スループットを確保している。
またMoonshotは、エキスパートのルーティング方針を最適化し推論速度を2〜3倍に高めた「Kimi K3.1 Pro Highspeed」も同時提供。ライセンス面では専用の「Kimi K3.1 Pro License」を採用し、大規模な商用利用に対するコンプライアンス要件を設けることで、派生モデルの無秩序な拡散に対して責任あるコントロールを講じている。
オープンモデルの成熟:エンジニアリングの自制が分岐点に
中国製フロンティアモデル群は、アプローチの違いに応じた強みを発揮している。Tencent内部の579項目の金融推論評価では、Kimi K3.1 Proが2.68点、DeepSeek-V4.1-Flash-1017が2.97点を記録し、業務領域ごとに一進一退の分布を見せている。
K3.1 Proが業界にもたらした最大のメッセージは、能力削減の内訳を透明性高く公表した点にある。3Tパラメータと1Mウィンドウを手にした今、モデルの絶対的破壊力と拡散リスクの間で責任ある選択が求められている。具体的なデータで削減前後の差異を示したMoonshotの姿勢は、オープンソースエコシステムが社会的信頼を獲得するための試金石となるだろう。
参考リンク:
- Moonshot 公式ブログ
- Kimi K3.1 Pro 技術レポート及びオープンソース仕様
- Terminal-Bench 4.0 公式ベンチマーク
- BenchCAD 論文および評価セット仕様