선도적인 인공지능 연구소들이 오픈 가중치 모델을 내놓을 때, 벤치마크 점수가 단조 증가하는 곡선을 자랑하는 것이 일반적인 관례였다. 하지만 문샷 AI(Moonshot AI)는 Kimi K3.1 Pro 발표 자료에서 정반대의 데이터를 전면에 내세웠다. 치명적 취약점 탐지 및 공격 능력을 측정하는 xdev-bench-hard 벤치마크에서 연구 프로토타입은 90.5%의 높은 점수를 기록했다. 그러나 커뮤니티에 최종 배포된 오픈 가중치 버전의 점수는 의도적으로 81.0%로 억제되었다.
이 9.5%포인트의 격차는 철저한 두 단계 데이터 필터링에서 비롯되었다. 연구진은 사전 학습과 강화학습(RL) 전 과정에서 공격적 사이버 보안 관련 말뭉치를 체계적으로 걷어냈다. 3조(3T) 개 파라미터와 100만(1M) 토큰 컨텍스트를 갖춘 최상위 모델의 공식 발표 첫머리에 스스로의 능력 제한 사실을 명시한 것이다. 오픈소스 프런티어 경쟁의 무게중심이 단순한 연산 규모에서 배포자의 안전 판단력으로 이동하기 시작했다.
자발적 9.5%포인트 감축: 출시 발표문에 명시한 자기 절제
확장 훈련 과정에서 문샷 엔지니어들은 뚜렷한 패턴을 확인했다. 네트워크 침투 및 익스플로잇 능력이 모델 파라미터 규모에 비례해 안정적으로 상승한다는 점이었다. 연구팀은 두 가지 취약 데이터 소스를 찾아냈다. 범용 말뭉치에 섞여 있던 사이버 보안 공격 자료와 강화학습 환경에 포함된 모의 침투 작업이었다. 두 단계 모두에서 정제 작업을 거치지 않으면 하류 환경에서 공격 능력이 급속도로 확산될 위험이 있었다.
자체 구축한 벤치마크 xdev-bench-hard는 실제 환경에서의 취약점 익스플로잇 수준을 pass@3 기준으로 엄격하게 평가한다. 리눅스 커널, Node.js, JavaScriptCore, Exim, VirGL 그래픽 드라이버 전반을 다루며, 모델은 격리된 샌드박스에서 임의 코드 실행(RCE)을 달성하고 지정된 비밀 값을 탈취해 반환해야 한다. 정제 작업을 거치지 않은 프로토타입은 90.5%를 기록했지만, 최종 배포된 K3.1 Pro는 81.0%로 안전하게 하향 조정되었다.
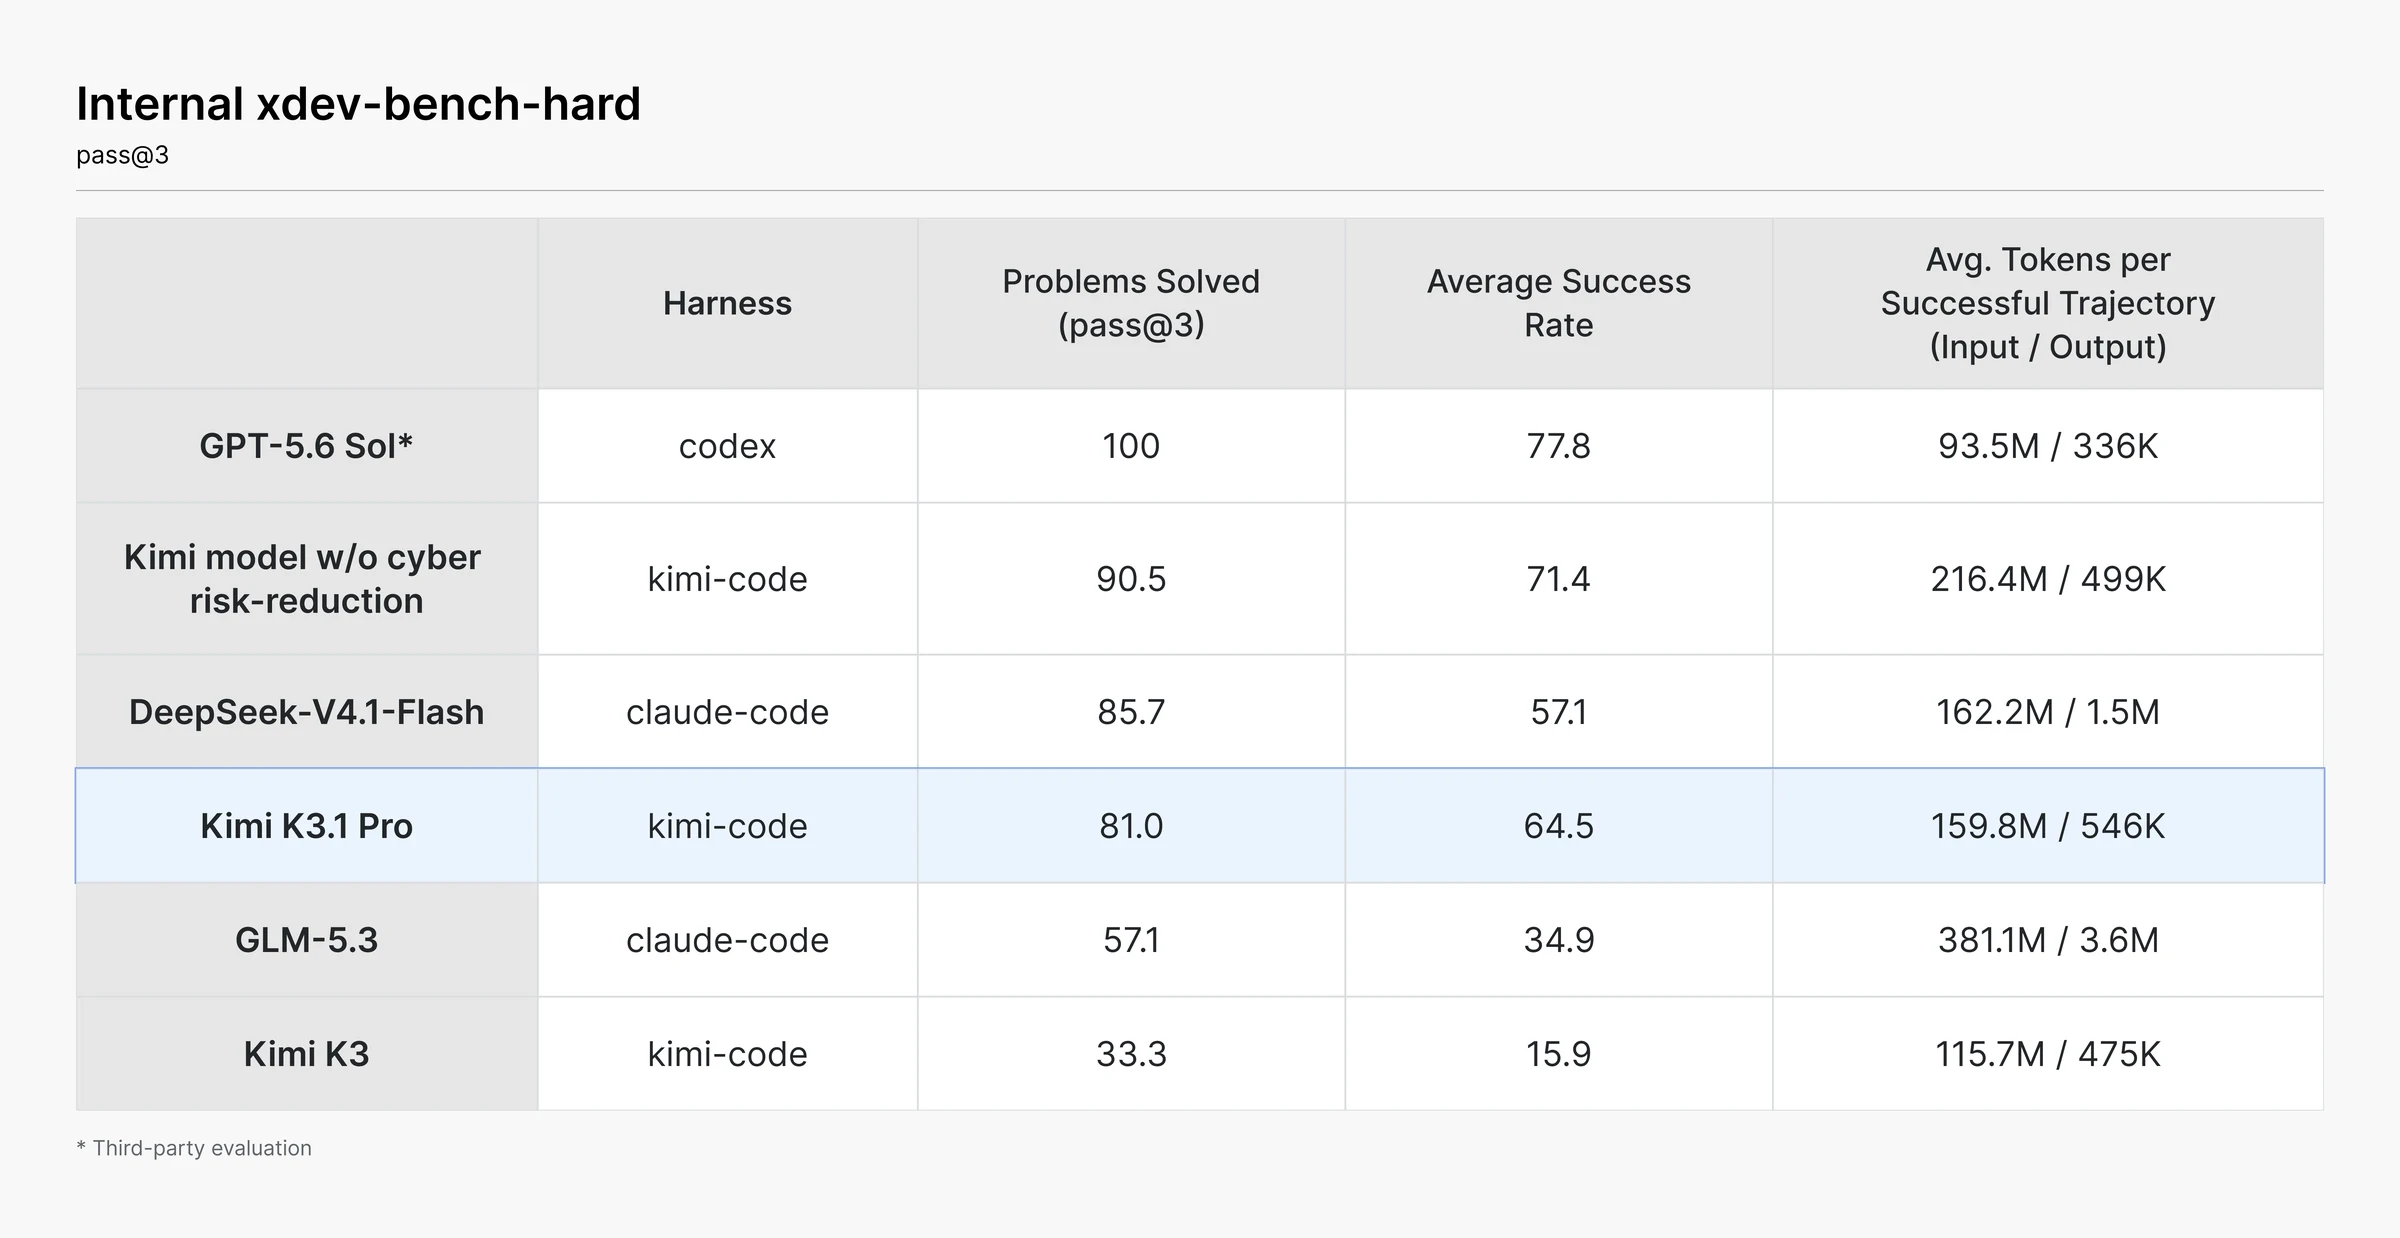 그림: xdev-bench-hard 취약점 익스플로잇 평가 대조군. 미정제 프로토타입의 90.5%와 최종 오픈소스 버전 81.0% 사이의 격차에 주목해야 한다. 출처: 문샷 공식 블로그
다른 모델과의 비교에서도 명확한 격차가 드러난다. 동일 벤치마크에서 DeepSeek-V4.1-Flash는 85.7%, GLM-5.3은 57.1%, 이전 세대인 K3는 33.3%를 기록했다. 서드파티 평가에서 폐쇄형 선도 모델인 GPT-5.6 Sol은 100%를 달성했다. 문샷은 일반적인 소프트웨어 엔지니어링 작업 역량은 온전히 유지하되, 취약점 발굴과 공격용 페이로드 생성에 대해서만 정밀한 데이터 세척을 단행했다.
문샷은 기술 보고서에서 분명한 입장을 밝혔다. 사이버 공격 능력의 절대적 한계를 넓히는 오픈 가중치를 배포할 의도가 없다는 점을 분명히 했다. 향후에는 방어자가 레거시 시스템을 감사할 수 있도록 보안 분석 역량을 점진적으로 개방할 계획이다. 역량 축소 전후의 투명한 대조 데이터를 공개한 것은 오픈소스 생태계에 의미 있는 위험 관리 표본을 제시한다.
167회 반복으로 물리 엔진 디버깅: 무한 루프를 돌파한 장기 코딩
정적 벤치마크 점수는 단편적인 단면만 보여주지만, 장기적이고 복잡한 엔지니어링 작업은 추론의 깊이를 시험한다. 오픈소스 해부학 프로젝트인 human-atlas를 기반으로 진행된 실험에서, 모델은 296개의 골격 부품과 402개의 근육 부품으로 구성된 인체 보행 역학 시뮬레이터를 구축하는 임무를 맡았다. 167회의 연속 작업과 420회의 독립적인 코드 리뷰를 거치며, 모델은 몇 초 만에 쓰러지던 보행 제어를 11.2초 동안 안정적으로 교차 보행하도록 최적화했다.
보행 훈련이 정체기에 접어들었을 때 시뮬레이터 안의 팔 동작이 부자연스럽게 뒤틀리기 시작했다. 모델은 보상 함수만 무한히 미세조정하는 일반적인 방식 대신 시뮬레이터의 역학 엔진 자체를 직접 탐색했다. 동역학 모듈 내 어깨 근육 모멘트 암 계산 알고리즘에서 36곳의 오류를 찾아내 수정한 뒤 컨트롤러 재훈련을 진행했다.
이러한 깊이 있는 문제 해결 역량은 장기 코드 벤치마크에서도 확인된다. Kimi Code Bench 3.0 Long-horizon 평가에서 K3.1 Pro는 61.2%의 통과율을 기록하며 이전 세대 K3의 55.95% 대비 5.25%포인트 향상되었다. 물리 시뮬레이션의 미세한 알고리즘 결함을 짚어내는 능력이 장기적 자율 엔지니어링 과제를 완수하는 기반이 된다.
폐쇄형 모델에 필적하는 도구 호출: 전문 환경에서 입증된 추론 깊이
터미널 조작과 다중 도구 연동 평가에서 K3.1 Pro는 폐쇄형 플래그십 모델들과 대등한 실력을 과시했다. Claude-Code 하네스를 적용한 Terminal-Bench 4.0 평가에서 K3.1 Pro는 65.7%를 기록했다. 이는 GPT-6 Astra(58.2%)를 앞서고 Claude Opus 5.5(66.4%)에 근접한 수치다. 복수 도구 오케스트레이션에 대한 뛰어난 제어력은 자동화 운영 영역에서 오픈 모델과 독점 모델 사이의 격차를 좁혀놓았다.
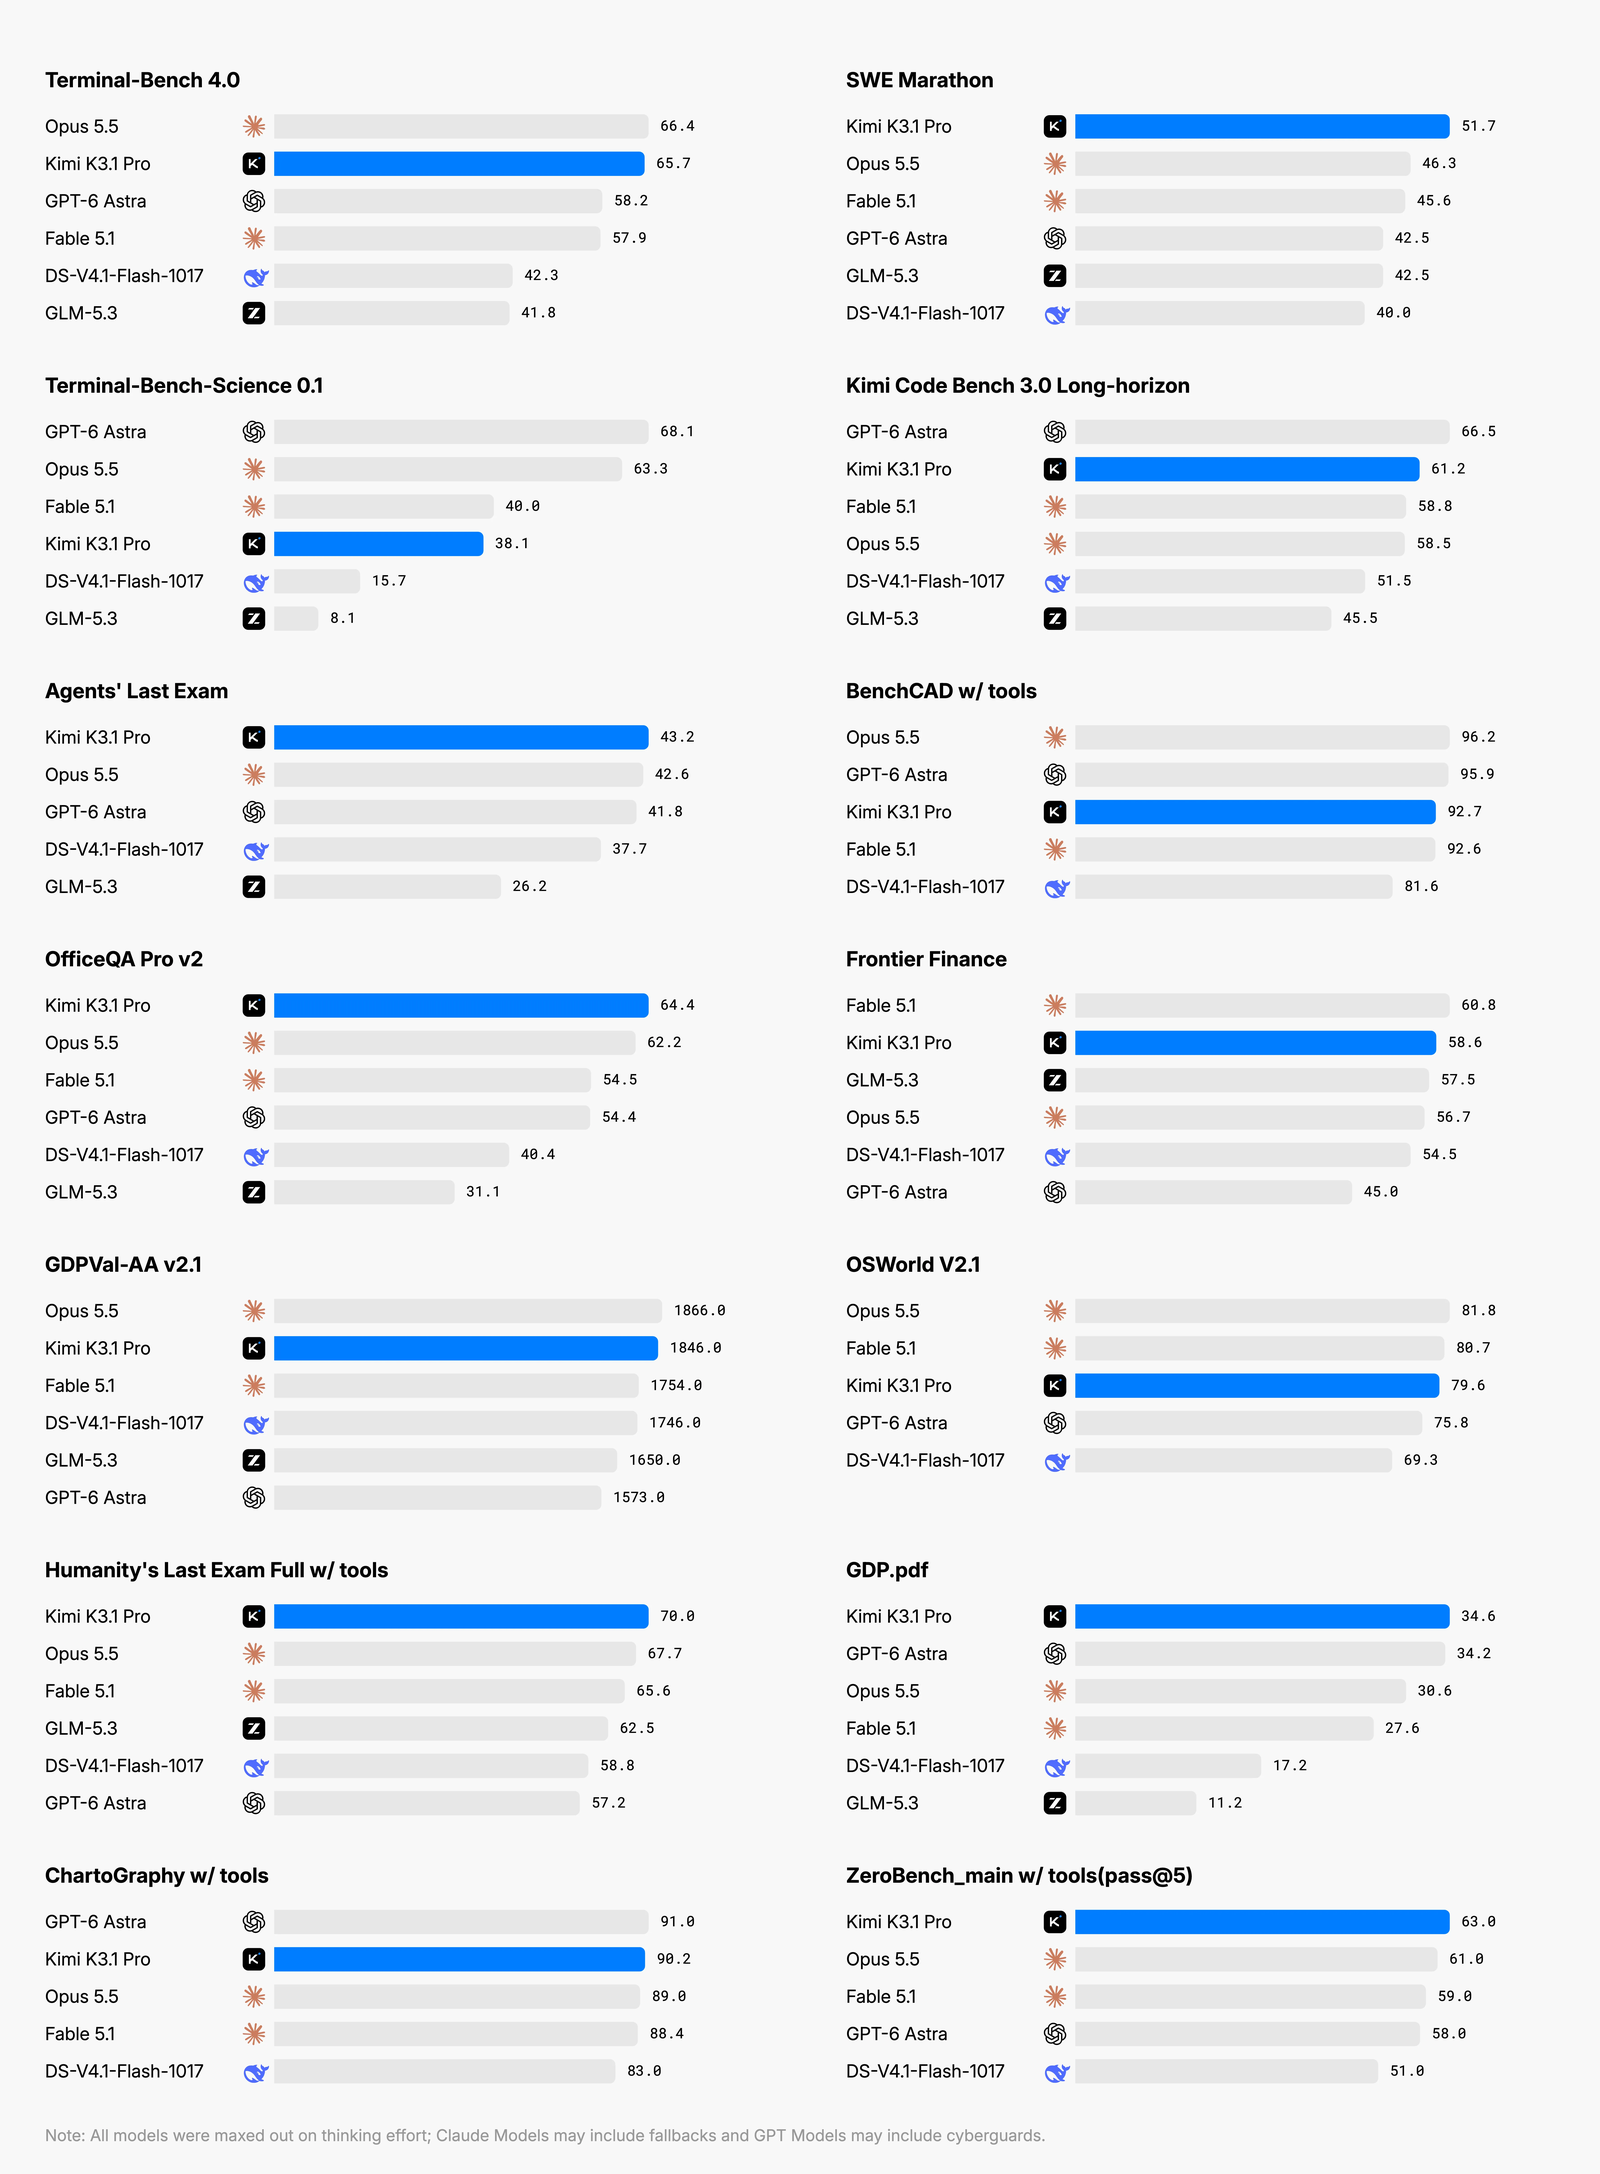 그림: 14개 코딩, 과학, 지식 작업 벤치마크에서의 K3.1 Pro 성능. 단순한 우열보다 특정 하네스 환경에서의 점수 분포를 살펴보는 것이 중요하다. 출처: 문샷 공식 블로그
BenchCAD 평가는 여러 각도에서 촬영한 이미지를 바탕으로 파라메트릭 CAD 모델링 코드를 역추론하는 과제다. 1,000개의 엄선된 샘플을 대상으로 Voxel IoU 기준으로 평가된다. 외부 렌더링 및 검증 도구를 연동했을 때 K3.1 Pro는 92.7%를 기록해 Claude Fable 5.1(92.6%)과 어깨를 나란히 했다. Claude Opus 5.5(96.2%)와 GPT-6 Astra(95.9%)에는 다소 못 미쳤지만 DeepSeek-V4.1-Flash-1017(81.6%)을 크게 앞섰다.
외부 도구 없는 순수 코드 생성 환경에서도 K3.1 Pro는 72.8%의 점수를 유지해 Claude Opus 5.5(73.0%)와 대등한 성능을 보였다. 같은 조건에서 DeepSeek는 41.2%에 머물렀다. 이는 모델 자체의 기하학적 3차원 공간 추론 역량이 외부 도구 없이도 탄탄한 기준선을 유지함을 보여준다.
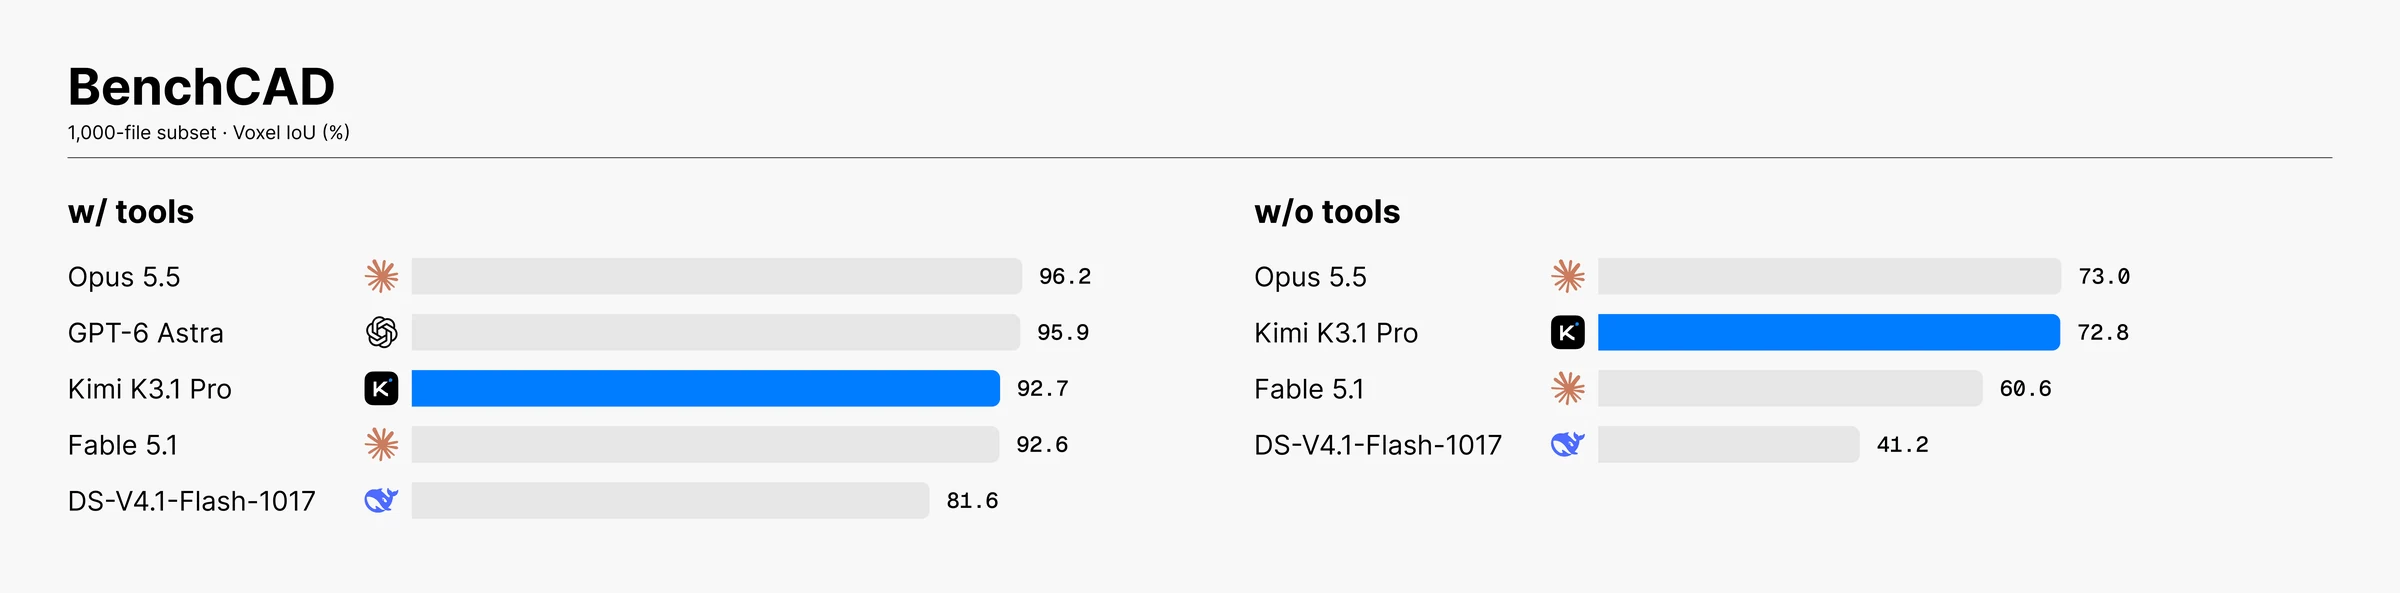 그림: BenchCAD 다각도 렌더링 기반 CAD 코드 역추론 평가. 도구 연동 유무에 따른 Voxel IoU 격차를 대조해 보면 외부 도구 환경이 모델의 장기 추론 잠재력을 극대화함을 알 수 있다. 출처: 문샷 공식 블로그
장문 텍스트 분석 및 금융 평가에서도 밀도 높은 정보 처리력을 보여주었다. 검색 가능한 텍스트 없이 순수 이미지로만 구성된 PDF 문서를 평가하는 OfficeQA Pro v2에서 64.4점을 획득했다. 금융 모델링 평가는 57.6점을 달성했고 비즈니스 운영 작업은 K3의 8.9점에서 37점으로 수직 상승했다. 사실성 제어 측면에서도 Kimi Hallu Bench Hard의 단일 주장 기준 환각률이 23.4%에서 8.3%로 급감하며 오류 응답 비율이 절반 이상 줄었다.
MXFP4로 압축한 3T 가중치: QAT로 보존한 처리량과 정밀도
3조 개 파라미터 규모의 전문가 혼합(MoE) 모델을 일반 16비트 부동소수점으로 배포할 경우 막대한 VRAM 요구량으로 인해 실제 운영이 제한된다. K3.1 Pro는 양자화 인식 훈련(QAT)을 도입해 가중치를 초고밀도 MXFP4 규격으로 압축하고 활성화 값은 MXFP8로 유지했다. 이를 통해 비디오 메모리 점유율과 대역폭 부담을 크게 덜어내며 1M 초대형 컨텍스트 창에서도 상용 클러스터 수준의 추론 속도를 확보했다.
문샷은 전문가 라우팅 전략을 개선해 추론 속도를 2배에서 3배까지 끌어올린 Kimi K3.1 Pro Highspeed 버전도 함께 공개했다. 라이선스는 전용 Kimi K3.1 Pro License를 채택하여 대규모 상업적 활용에 준수 요건을 부여함으로써 파생 모델 배포 속도에 대한 책임 있는 통제권을 행사하고 있다.
오픈소스 모델의 성숙도: 엔지니어링 절제가 분수령이다
프런티어 모델들은 다양한 기술적 경로에 맞춰 각자의 강점을 드러내고 있다. 텐센트 내부에서 진행된 579개 금융 추론 평가에서 Kimi K3.1 Pro는 2.68점, DeepSeek-V4.1-Flash-1017은 2.97점을 획득하며 세부 비즈니스 영역별로 팽팽한 양상을 보였다.
K3.1 Pro가 전하는 가장 핵심적인 업계 신호는 능력 축소의 내역을 투명하게 공개했다는 점이다. 3T 파라미터와 1M 윈도우를 갖춘 모델을 공급함에 있어 능력의 확장과 위험의 확산 사이에서 책임 있는 균형을 잡아야 한다. 상세한 데이터 내역으로 책임 있는 태도를 보여준 문샷의 행보는 오픈소스 생태계가 신뢰를 확보하는 중대한 전환점이 될 것이다.
참고 링크:
- 문샷 공식 블로그
- Kimi K3.1 Pro 기술 보고서 및 오픈소스 설명서
- Terminal-Bench 4.0 공식 벤치마크 순위표
- BenchCAD 논문 및 평가 데이터셋 명세