La mayoría de los laboratorios de IA muestran un patrón uniforme al publicar modelos de pesos abiertos: destacar que cada barra de rendimiento crece sin excepción. Sin embargo, en las notas de lanzamiento de Kimi K3.1 Pro, Moonshot AI decidió presentar un dato en sentido contrario. En el benchmark xdev-bench-hard, diseñado para evaluar la detección y explotación de vulnerabilidades críticas, el prototipo de investigación alcanzó una puntuación del 90,5 %. En cambio, la versión abierta entregada a la comunidad se contuvo voluntariamente en el 81,0 %.
Esa diferencia de 9,5 puntos porcentuales responde a dos filtros de datos rigurosos. El equipo de investigación purgó sistemáticamente los corpus de ciberseguridad ofensiva tanto en la fase de preentrenamiento como en la de aprendizaje por refuerzo (RL). Al presentar un modelo de 3 billones de parámetros con 1 millón de tokens de ventana de contexto, Moonshot inscribió la autorregulación en la portada de su lanzamiento. La frontera de la competición abierta deja de medirse solo por la fuerza bruta de cómputo y pasa a definirse por el criterio de seguridad de sus creadores.
Una reducción deliberada de 9,5 puntos: la contención en el centro del lanzamiento
Durante los experimentos de escalabilidad, los ingenieros de Moonshot observaron un patrón claro: la capacidad de intrusión en redes aumenta de forma sostenida con el tamaño del modelo. El equipo identificó dos fuentes críticas de datos: el material sobre ciberseguridad disperso en los corpus generales y las tareas de penetración introducidas en el entorno de RL. Si ambas etapas quedaban sin depurar, la capacidad de ataque aguas abajo se multiplicaría de manera descontrolada.
El benchmark interno xdev-bench-hard evalúa con rigor el nivel real de explotación de vulnerabilidades bajo la métrica pass@3. Abarca objetivos en el kernel de Linux, Node.js, JavaScriptCore, Exim y módulos VirGL. El modelo debe obtener ejecución remota de código en una sandbox aislada y extraer un secreto predeterminado. El prototipo sin depurar logró un 90,5 %, pero la versión final de K3.1 Pro se rebajó al 81,0 %.
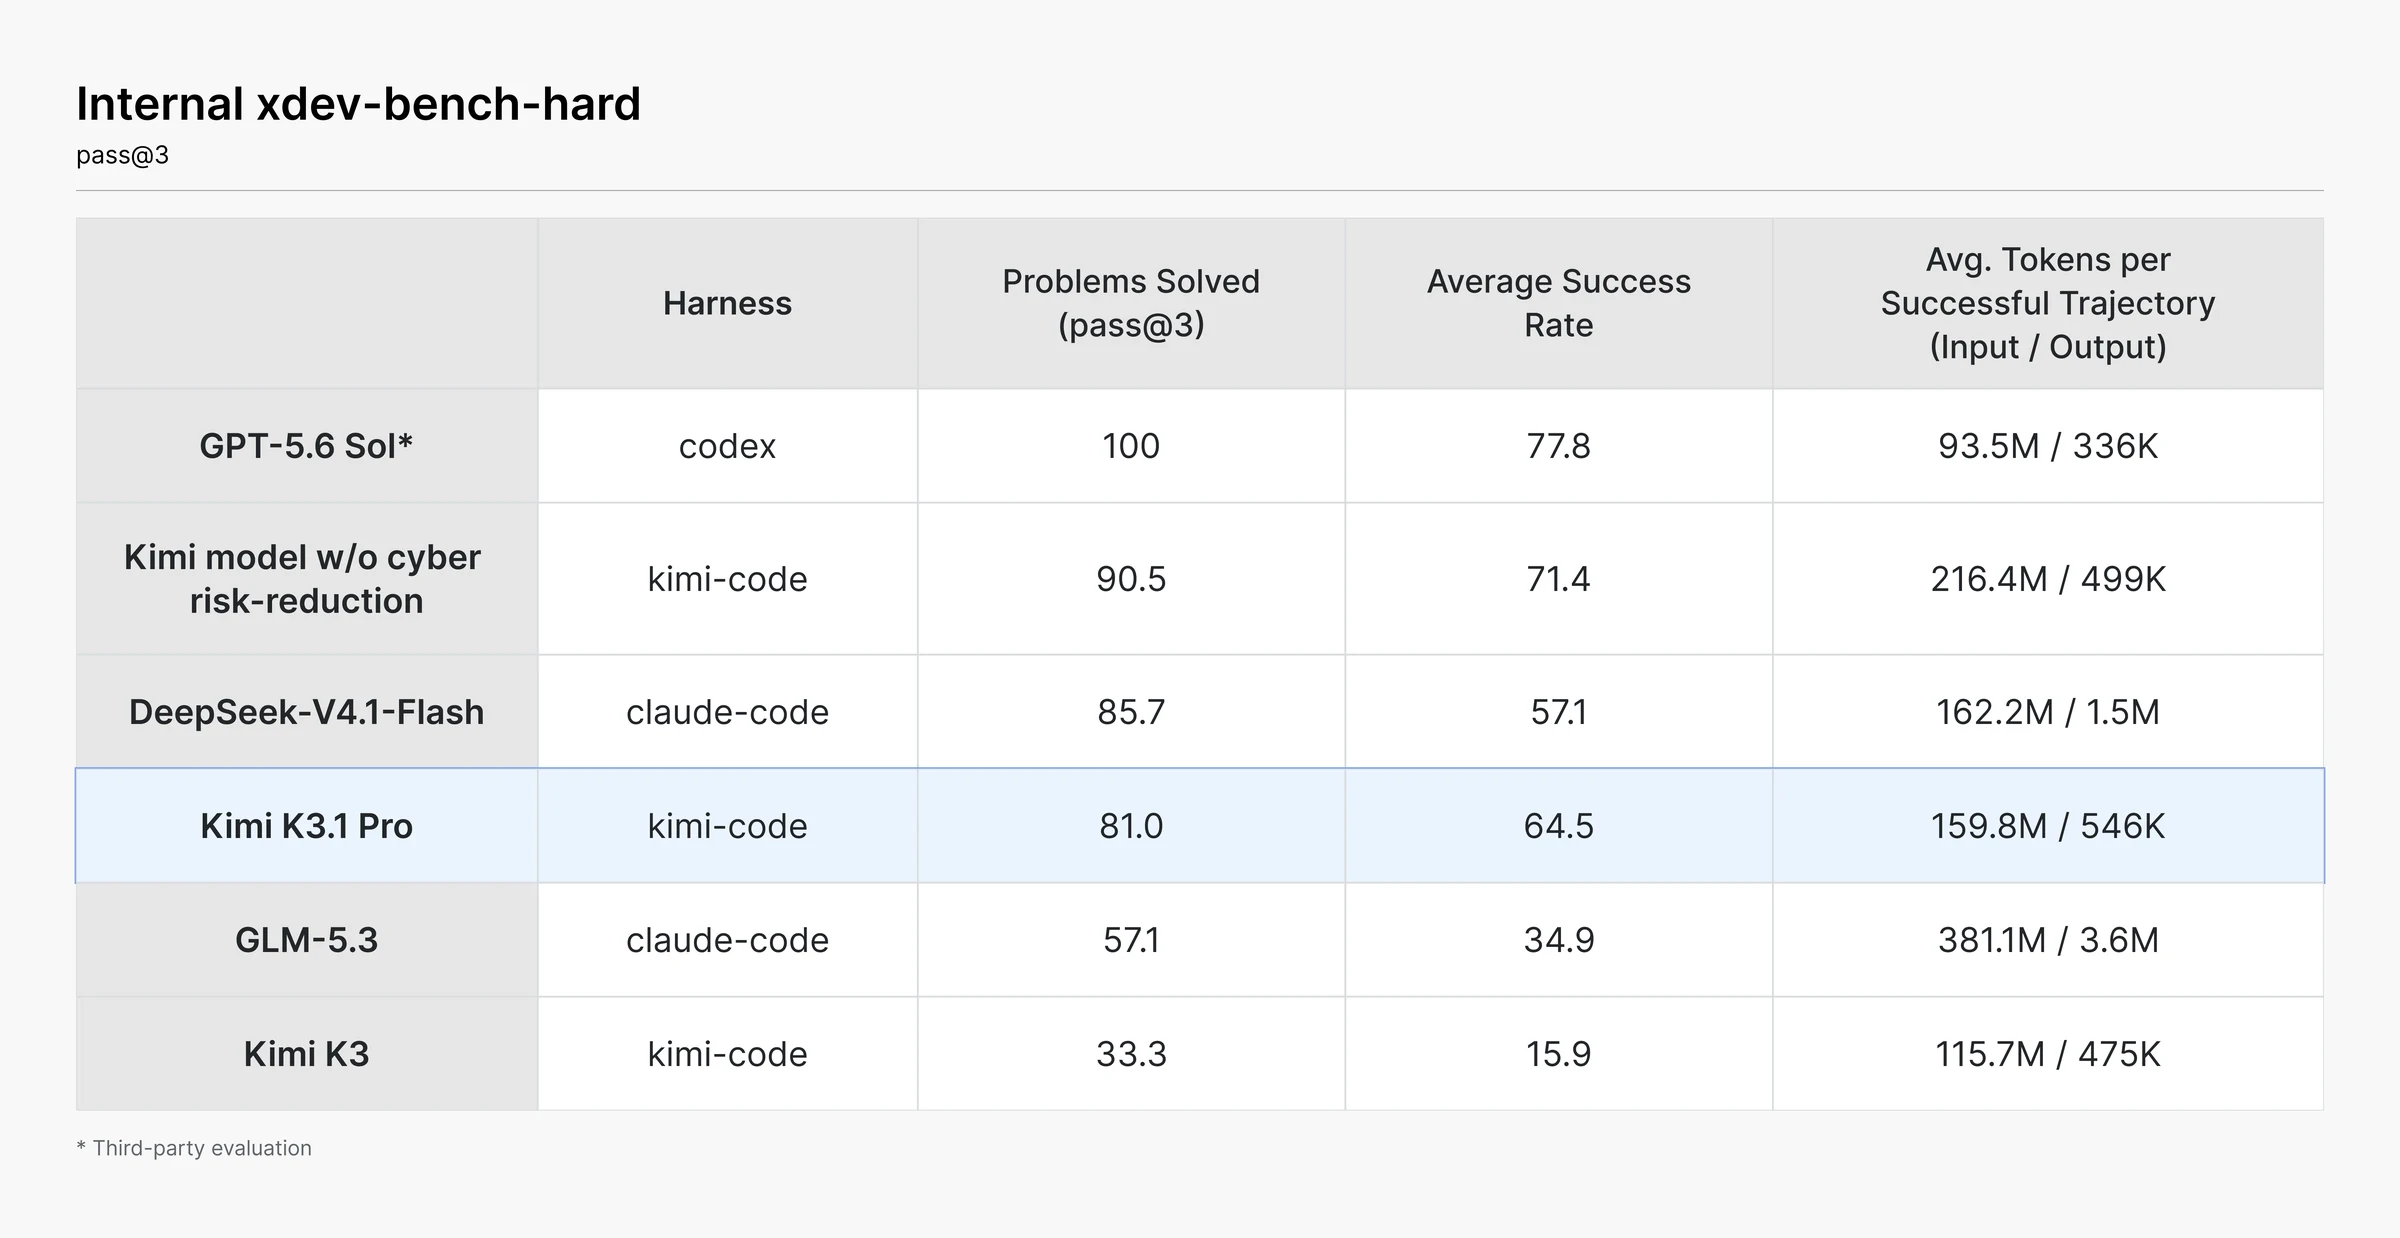 Figura: Comparativa en la evaluación de explotación de vulnerabilidades xdev-bench-hard. Conviene fijarse en la brecha entre el 90,5 % del prototipo inicial y el 81,0 % de la versión abierta final. Fuente: Blog oficial de Moonshot AI
La comparativa horizontal con otros modelos refleja una clara jerarquía. En este mismo benchmark, DeepSeek-V4.1-Flash obtuvo un 85,7 %, GLM-5.3 un 57,1 % y la generación anterior K3 apenas un 33,3 %. En evaluaciones externas, el modelo propietario GPT-5.6 Sol alcanzó el 100 %. Moonshot conservó íntegras las tareas generales de programación de software y aplicó la limpieza exclusivamente al desarrollo de exploits y cargas maliciosas.
En su informe técnico, Moonshot fijó una postura rotunda: el laboratorio no tiene intención de publicar modelos abiertos que empujen la frontera absoluta del ciberataque. La compañía planea abrir gradualmente herramientas de auditoría para ayudar a los equipos defensivos a revisar código heredado. Publicar los datos comparativos de rendimiento antes y después del recorte aporta una valiosa referencia de gestión de riesgos al ecosistema de código abierto.
167 iteraciones para depurar un motor de física: razonamiento de largo alcance
Las pruebas estáticas ofrecen solo una imagen parcial; los proyectos de ingeniería prolongados son los que realmente ponen a prueba la profundidad del razonamiento. Utilizando el proyecto de anatomía abierta human-atlas, el modelo recibió la tarea de construir un simulador de dinámica de locomoción humana con 296 estructuras óseas y 402 componentes musculares. A lo largo de 167 tareas continuas y 420 revisiones de código independientes, el modelo transformó un controlador que colapsaba en pocos segundos en una marcha alternada y estable durante 11,2 segundos.
Cuando el entrenamiento de la marcha se estancó, los movimientos de los brazos en la simulación comenzaron a sufrir distorsiones anómalas. En lugar de insistir en ajustes interminables de la función de recompensa, K3.1 Pro analizó directamente el motor del simulador. Detectó 36 errores algorítmicos en el cálculo del brazo de momento de los músculos del hombro dentro del módulo de dinámica, corrigió el código de la física y solo entonces reanudó el entrenamiento del controlador.
Esta solvencia diagnóstica se refleja en las pruebas de código a largo plazo. En Kimi Code Bench 3.0 Long-horizon, K3.1 Pro alcanzó una tasa de éxito del 61,2 %, mejorando en 5,25 puntos porcentuales el 55,95 % de K3. Diagnosticar fallos sutiles en simulaciones complejas es indispensable para el desarrollo de agentes autónomos de ingeniería.
Invocación de herramientas al nivel de los líderes propietarios
En las evaluaciones de terminal y orquestación de herramientas, K3.1 Pro demostró un rendimiento parejo al de los modelos propietarios punteros. En Terminal-Bench 4.0, evaluado bajo el entorno Claude-Code, K3.1 Pro logró una puntuación del 65,7 %, superando a GPT-6 Astra (58,2 %) y acercándose a Claude Opus 5.5 (66,4 %). La precisión en la gestión de cadenas de herramientas reduce la brecha entre modelos abiertos y cerrados en operaciones de sistemas automatizados.
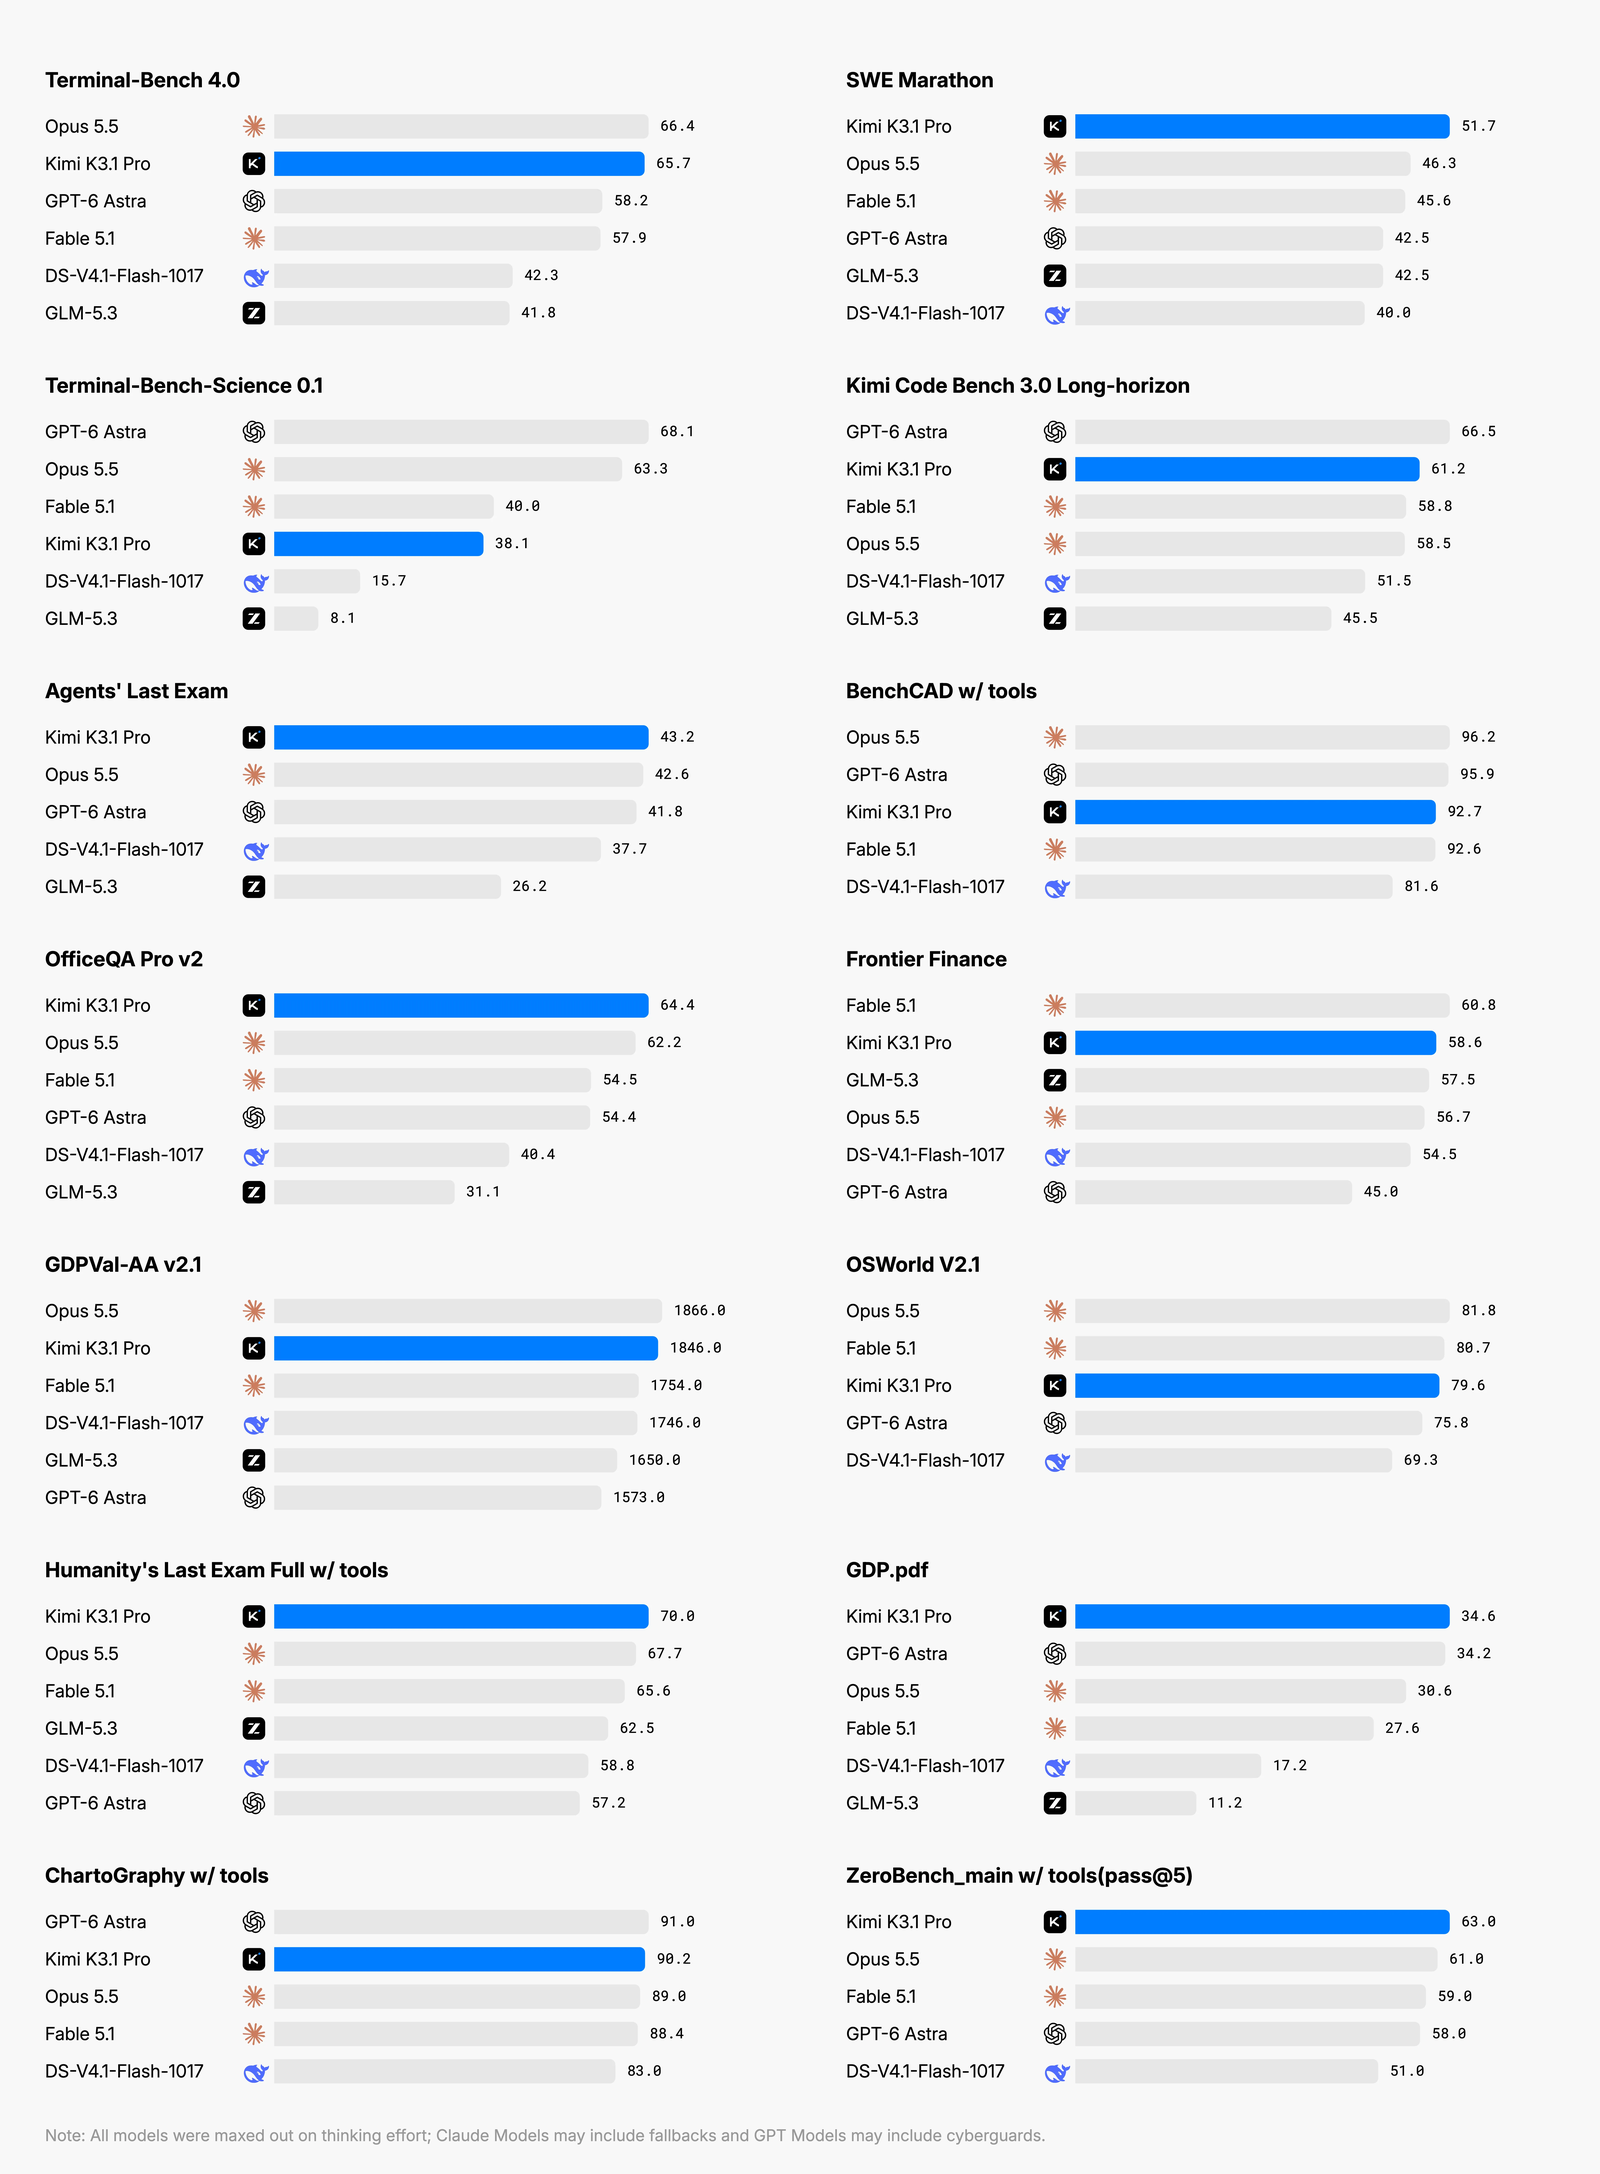 Figura: Rendimiento de K3.1 Pro en 14 evaluaciones de programación, ciencia y trabajo de conocimiento. Al interpretar este gráfico conviene analizar la distribución de puntuaciones bajo cada entorno de pruebas. Fuente: Blog oficial de Moonshot AI
El benchmark BenchCAD exige reconstruir código de modelado CAD a partir de imágenes multivista en 1.000 ejemplos seleccionados, evaluados mediante Voxel IoU. Con acceso a herramientas externas de renderizado e inspección, K3.1 Pro alcanzó un 92,7 %, igualando a Claude Fable 5.1 (92,6 %). Aunque quedó ligeramente por detrás de Claude Opus 5.5 (96,2 %) y GPT-6 Astra (95,9 %), superó con holgura a DeepSeek-V4.1-Flash-1017 (81,6 %).
En el modo de generación de código puro sin herramientas, K3.1 Pro mantuvo un 72,8 %, a la par del 73,0 % de Claude Opus 5.5, mientras que DeepSeek cayó al 41,2 %. La prueba confirma que el modelo posee un razonamiento espacial geométrico intrínseco capaz de sostener un alto nivel sin requerir retroalimentación externa continua.
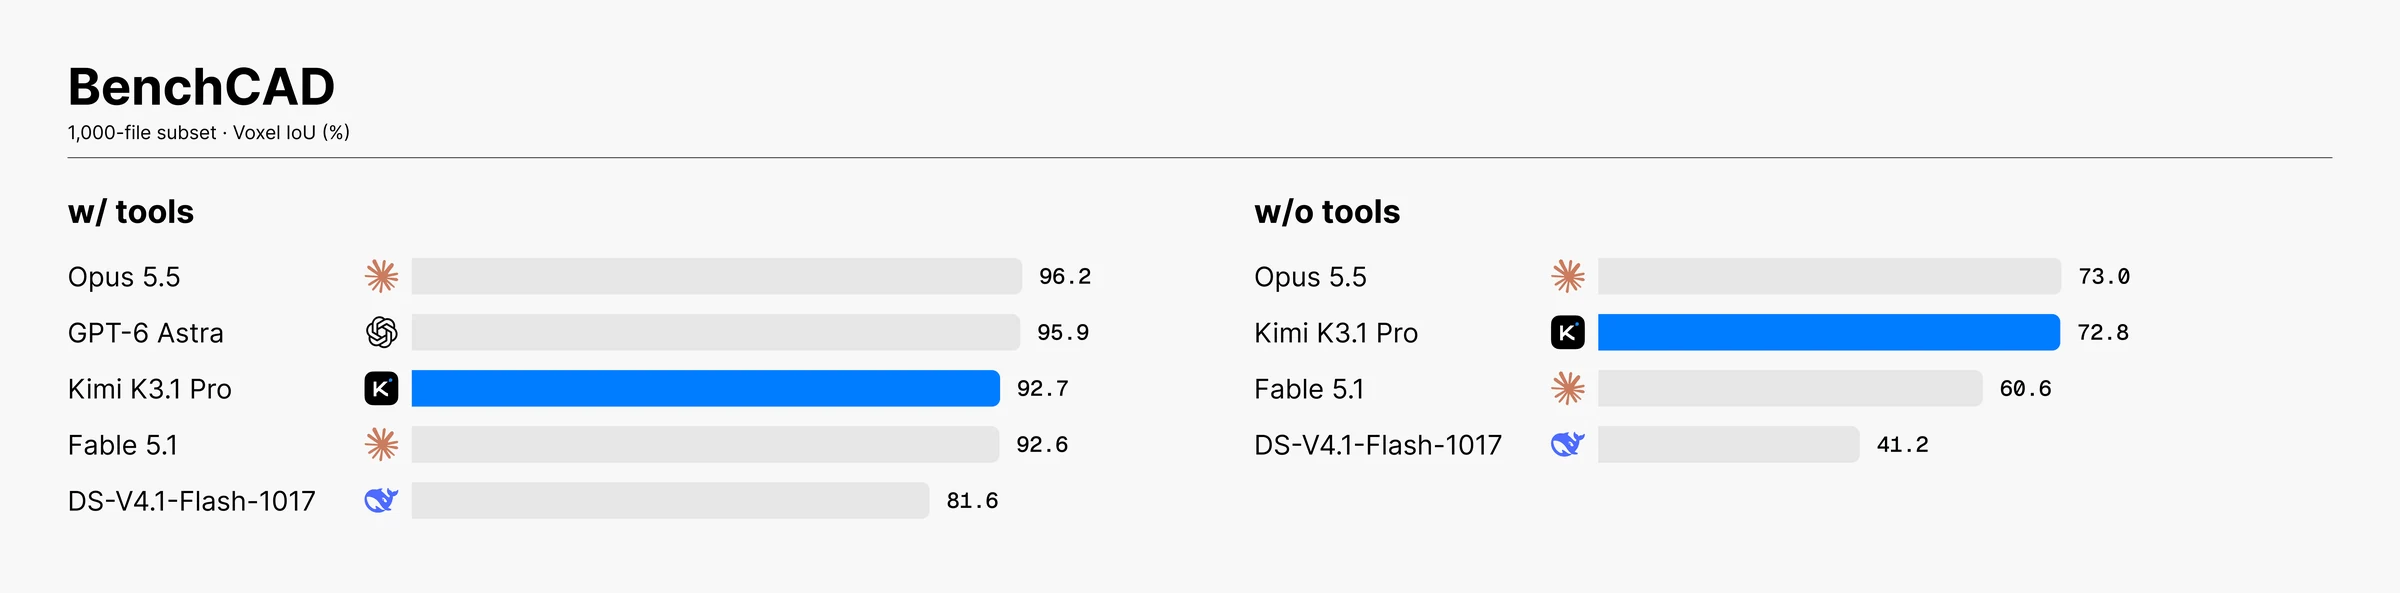 Figura: Evaluación en BenchCAD de inferencia de código CAD desde renderizado multivista. Obsérvese la diferencia de Voxel IoU con y sin herramientas, demostrando cómo los entornos instrumentados amplifican el razonamiento. Fuente: Blog oficial de Moonshot AI
En escenarios de análisis documental denso y finanzas, el modelo conservó una notable densidad informativa. En OfficeQA Pro v2, donde los documentos PDF se entregan exclusivamente como imágenes sin texto reconocible, K3.1 Pro obtuvo 64,4 puntos. En modelado financiero alcanzó 57,6 puntos y en operaciones comerciales subió de 8,9 (K3) a 37 puntos. En fiabilidad de hechos, Kimi Hallu Bench Hard redujo la tasa de alucinación por afirmación del 23,4 % al 8,3 %, disminuyendo a menos de la mitad las respuestas con imprecisiones fácticas.
Cuantización MXFP4 para 3T parámetros: equilibrio de precisión y rendimiento
Desplegar una arquitectura de 3 billones de parámetros en formato estándar de punto flotante de 16 bits exigiría recursos de VRAM prohibitivos. K3.1 Pro recurre al entrenamiento consciente de cuantización (QAT) para compactar los pesos al formato MXFP4 manteniendo las activaciones en MXFP8. Esta solución reduce la huella de memoria y la presión sobre el ancho de banda, permitiendo que la ventana de 1M de tokens mantenga un rendimiento viable en clústeres empresariales convencionales.
Moonshot presentó también la variante Kimi K3.1 Pro Highspeed, que optimiza el enrutamiento de expertos para multiplicar la velocidad de inferencia entre 2 y 3 veces. En materia de licencias, adoptó la licencia personalizada Kimi K3.1 Pro License, que establece requisitos de cumplimiento para el uso comercial a gran escala, reflejando un control responsable sobre la distribución de modelos derivados.
La madurez del código abierto se mide por su contención técnica
Los modelos punteros exhiben fortalezas diferenciadas según sus prioridades de diseño. En la batería interna de 579 pruebas de razonamiento financiero realizada por Tencent, Kimi K3.1 Pro obtuvo 2,68 puntos frente a los 2,97 de DeepSeek-V4.1-Flash-1017, reflejando rendimientos equilibrados según el ámbito de aplicación.
La aportación más significativa de K3.1 Pro reside en la transparencia con la que expuso el recorte deliberado de sus capacidades. Al ofrecer 3T parámetros y 1M de contexto, los creadores de modelos abiertos asumen el reto de equilibrar potencia y difusión de riesgos. Publicar las cuentas exactas de esa contención es el paso definitivo para que el ecosistema abierto inspire una confianza duradera.
Enlaces de referencia:
- Blog oficial de Moonshot AI
- Informe técnico y especificaciones de código abierto de Kimi K3.1 Pro
- Clasificación oficial de Terminal-Bench 4.0
- Publicación de BenchCAD y especificaciones del banco de pruebas