70년간 이어진 전체 배치 관성을 깨뜨린 미니배치 이동평균
딥러닝 분야는 오래전에 미니배치 최적화로 전환되었지만, 고전적인 군집화(Clustering)는 70년 동안 전체 데이터 스캔 방식에 머물러 있었습니다. 전통적인 Lloyd 알고리즘은 매 라운드마다 전체 표본의 평균을 다시 계산하기 때문에 수천만 개의 벡터를 처리할 때 엄청난 시간을 소모합니다. 2026년 11월, Matthijs Douze와 Hervé Jégou를 비롯한 Faiss 메인테이너 연구진은 e-means를 발표했습니다. Meta FAIR의 미니배치 k-means 초기 연구에서 출발한 이 새로운 알고리즘은 현대적인 딥러닝 최적화 도구를 군집화 작업에 체계적으로 도입했습니다.
1957년 처음 제안된 이래 Lloyd 알고리즘은 벡터 양자화와 군집화 분야를 지배해 왔습니다. 각 클러스터는 표본 벡터의 합 $S_j$와 개수 $N_j$를 관리하며, 두 값의 나눗셈으로 중심점 좌표를 결정합니다. 알고리즘은 매 갱신 주기마다 누적기를 초기화하고 전체 데이터를 다시 읽어야 합니다. 군집 중심이 수만 개로 늘어나고 표본이 수천만 개에 이르면, 반복적인 전체 스캔으로 인해 메모리 대역폭이 고갈됩니다.
학계에서는 1967년 MacQueen 규칙을 제안하며 미니배치 방식의 갱신을 시도한 바 있습니다. 그러나 MacQueen 방식은 스트리밍 처리 과정에서 통계량을 지속적으로 누적할 뿐 과거의 가중치를 감쇠시키지 않습니다. 그 결과 초기에 잘못 할당된 데이터 표본이 중심점 좌표를 영구적으로 오염시킵니다. 초기 잡음을 걸러내지 못해 군집 중심이 후반부로 갈수록 실제 데이터 분포에서 벗어나는 한계가 있었습니다.
e-means는 단순 누적 대신 지수이동평균(EMA) 방식을 선택했습니다. 갱신 공식은 $S_j \leftarrow (1-\alpha)S_j + \alpha s_j$로 작성되며, 갱신율 $\alpha$에 따라 과거 할당을 점진적으로 감쇠시킵니다. 중심점은 항상 최근 배치의 국소 평균을 추적하여 초기의 잘못된 할당을 부드럽게 걸러냅니다. 이 메커니즘은 과거 VQ-VAE 코드북 학습에 주로 사용되었으나, 정적 데이터셋에서도 뛰어난 수렴 성능을 발휘하는 것으로 나타났습니다.
단 2 에포크만에 25회 반복의 오차 수준 달성
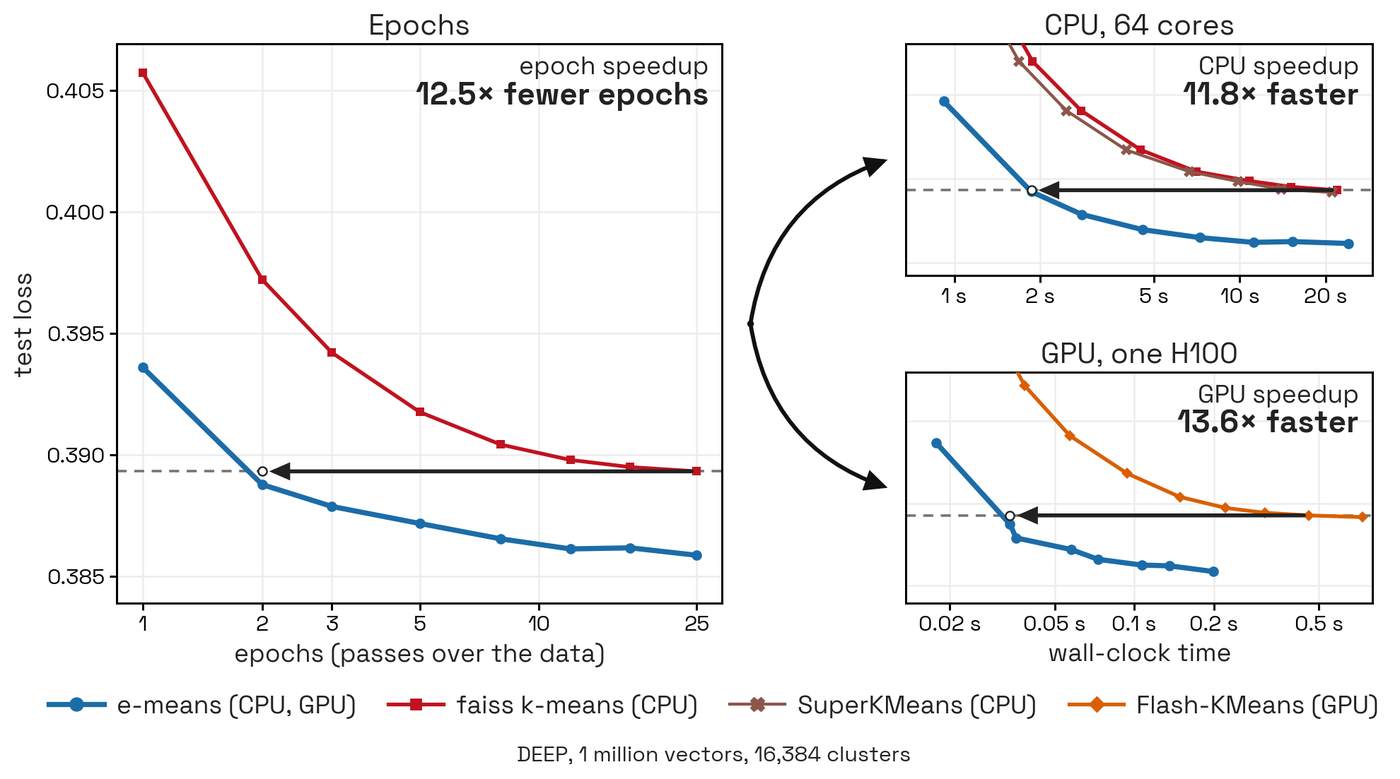 그림: 학습 에포크 수, CPU 소요 시간, GPU 소요 시간의 세 가지 측면에서 비교한 e-means와 Lloyd의 성능. 출처: e-means 프로젝트 홈페이지
11개의 VIBE 멀티모달 벤치마크 데이터셋에서 e-means는 매우 빠른 수렴 속도를 보여주었습니다. 테스트 벡터 차원은 200부터 3072까지 다양하며, 군집 중심 수는 8192개 및 16384개로 설정되었습니다. 새 알고리즘은 Lloyd가 25회 반복을 완주했을 때의 테스트 오차를 불과 1.6~2.4 에포크만에 달성했습니다. 이제 군집화 과정에서 수십 번의 지루한 전체 반복이 필요하지 않으며, 단 두 번의 데이터 순회만으로 전역 분포에 근접합니다.
과거 군집화 최적화는 주로 정확도를 희생하여 처리량을 높이는 방식을 취했지만, e-means는 이러한 절충안을 허물었습니다. 단일 NVIDIA H100(bf16 정밀도)에서 진행된 실측 결과에 따르면 Flash-KMeans 대비 실행 시간이 10배에서 최대 45배 단축되었습니다. Faiss 네이티브 구현과 비교한 CPU 환경에서도 종단간 가속비가 8배에서 15배에 달했습니다. 속도의 비약적 향상과 손실의 감소가 동일한 알고리즘 체계 안에서 동시에 실현된 것입니다.
알고리즘 차원의 에포크 단축이 실제 벽시계 시간(Wall-clock time)의 단축으로 이어지려면 저수준 연산자의 지원이 필수적입니다. 1,000만 개의 벡터와 65,536개의 클러스터를 처리하는 극한 환경에서 순수 PyTorch Lloyd는 140초 이상 소요되었고, Flash-KMeans는 14초에서 22초가 걸렸습니다. e-means는 전용 융합 커널을 개발하여 최근접 중심점 할당과 이동평균 갱신을 단일 실행 경로로 통합했습니다. 메모리 대역폭 오버헤드가 대폭 절감되면서, 알고리즘 반복 수의 단축이 수십 배의 실제 속도 향상으로 직결되었습니다.
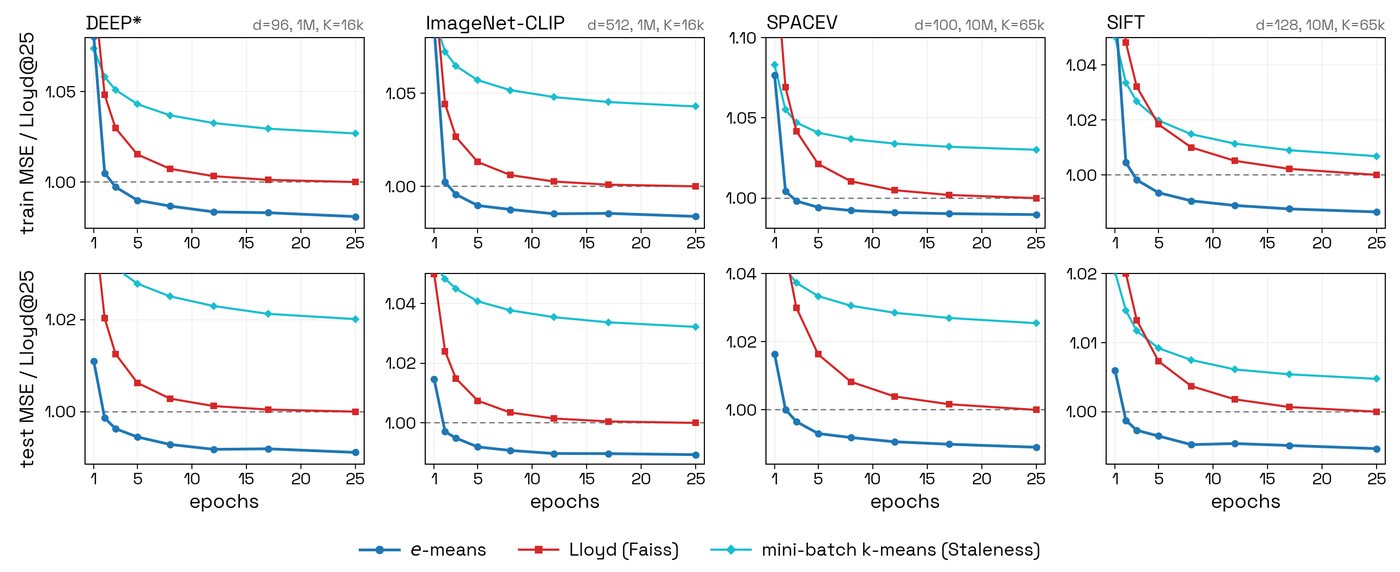 그림: Lloyd 제25회 반복 대비 학습 및 테스트 평균제곱오차 수렴 곡선. 출처: e-means 프로젝트 홈페이지
학습 및 테스트 평균제곱오차(MSE) 곡선을 살펴보면 두 알고리즘의 수렴 궤적 차이가 확연합니다. Lloyd는 전체 평균에 의존하여 초반에 빠르게 하락하지만, 중후반부에 접어들면서 급격히 정체 상태에 빠집니다. 반면 e-means는 불과 1.5 에포크만에 테스트 오차 수준에 도달하고 이후 에포크에서 더욱 낮은 수치를 기록합니다. 학습이 끝날 때 알고리즘은 중심점을 마지막 에포크의 실제 평균 위치로 이동시켜 이동평균으로 인한 미세한 지연 오차를 완전히 제거합니다.
미니배치의 무작위 노이즈가 국소 최적해 탈출을 견인하다
군집화 목적 함수는 비볼록(Non-convex) 특성을 지니고 있어 결정론적 최적화가 막다른 골목에 갇히기 쉽습니다. Lloyd 알고리즘의 매 갱신 단계는 학습 MSE를 엄격하게 단조 감소시킵니다. 그러나 이러한 단조 감소는 국소 함정으로 작용하여, 중심점이 차선의 수렴 영역으로 빠져들면 영원히 벗어나지 못합니다. 잘못된 초기 중심 배치가 알고리즘에 의해 최종 군집화 결과로 고착되는 것입니다.
미니배치 샘플링이 도입하는 무작위 섭동(Perturbation)은 매개변수 공간을 탐색하는 동력을 제공합니다. 규모 차이가 매우 큰 두 군집으로 구성된 합성 데이터에서 200회 반복 실험을 진행한 결과, Lloyd는 26%의 확률로 국소 극값에 갇혔습니다. 반면 동일한 설정에서 e-means는 실패 확률을 3.5%까지 낮췄습니다. 5개의 군집이 일직선상에 배치된 위상 구조에서 Lloyd의 국소 최적해 고착률은 46%에 달했으나, e-means는 0%의 고착률을 기록했습니다.
배치 샘플링의 무작위 분산은 안장점과 좁은 에너지 장벽을 뛰어넘는 내재적 능력을 지닙니다. 복잡한 휴리스틱 재시작 기법 없이도 무작위 섭동이 중심점의 이동 궤적을 스스로 재구성합니다. 심층 신경망에서 탐색 도구로 작동하는 무작위 노이즈가 군집화 작업에서도 동일한 가치를 발휘하는 것입니다. 차선책을 건너뜀으로써 전반적인 군집화 품질이 크게 향상됩니다.
탐색 후반부의 안정적인 수렴을 보장하기 위해 보폭 스케줄링에도 어닐링 전략이 도입되었습니다. 코사인 감쇠 곡선을 사용하여 갱신 보폭을 초기값 $\alpha_0$에서 $0.1\alpha_0$까지 점진적으로 줄여나갑니다. 초반의 큰 보폭은 중심점이 경계를 넘나들며 탐색하도록 돕고, 후반부의 줄어든 보폭은 안정적인 수렴을 보장합니다. 동적 보폭은 무작위 진동을 억제하여 폭넓은 탐색 범위와 정밀한 최종 위치 결정을 모두 충족합니다.
두 개의 경험 공식으로 수동 튜닝 비용 제거
과거 미니배치 군집화가 프로덕션 환경에서 Lloyd를 대체하기 어려웠던 핵심 이유는 하이퍼파라미터 튜닝 비용 때문이었습니다. Lloyd 알고리즘은 실행 시간이 오래 걸리지만 군집 수와 반복 횟수 외에 추가 파라미터를 설정할 필요가 없습니다. 반면 미니배치 메커니즘은 배치 크기와 학습률을 직접 결정해야 하는 난제를 안겨줍니다. 그리드 탐색에 소모되는 시간과 연산 자원은 개별 실행을 통해 절약한 컴퓨팅 자원을 상쇄하기 일쑤였습니다.
e-means는 딥러닝의 스케일링 법칙(Scaling Laws)을 활용하여 하이퍼파라미터 자동 적응 문제를 해결했습니다. 연구진은 표본 수 $n$, 중심 수 $k$, 컴퓨팅 예산 $T$를 바탕으로 최적의 하이퍼파라미터를 도출하는 두 개의 경험 공식을 도출했습니다. 이 공식은 배치 크기 $B$와 초기 보폭 $\alpha_0$를 직접 계산해 냅니다. 별도로 분리된 테스트 세트에서 두 공식의 결정계수($R^2$)는 각각 0.96과 0.95에 달했습니다.
자동 선정된 하이퍼파라미터의 실제 성능은 광범위한 데이터셋을 통해 검증되었습니다. 연구진이 전수 그리드 탐색 결과와 비교했을 때, 경험 공식 적용에 따른 성능 저하(Regret)의 중앙값은 0.06%~0.20%에 불과했습니다. 엔지니어가 시행착오를 겪으며 파라미터를 미세 조정할 필요 없이, 알고리즘이 스스로 최적의 수렴 경로를 찾아냅니다. 하이퍼파라미터 탐색을 없앤 자동 적응 능력은 실제 서비스 적용 장벽을 대폭 낮췄습니다.
극한의 정밀도를 추구하는 양자화 시나리오를 위해 연구진은 품질 중심의 공식 변형도 함께 제공합니다. 이 설정은 갱신 속도를 적절히 조절하여 약간의 처리량을 희생하는 대신 더 낮은 MSE를 달성합니다. 대규모 벡터 인덱스를 구축할 때 이러한 미세한 손실 개선은 검색 재현율 향상으로 직결됩니다. 엔지니어링 팀은 컴퓨팅 예산과 정밀도 요구사항에 따라 최적화 모드를 유연하게 전환할 수 있습니다.
비례 분할로 1만 개 이상의 양자화 중심을 되살리다
미니배치 군집화를 실제 산업에 적용할 때 마주치는 또 다른 고질적인 문제는 중심 기아 현상으로 인한 ‘죽은 클러스터(Dead clusters)’ 문제입니다. 특정 군집 중심이 현재 배치에서 아무런 표본도 할당받지 못하면 통계량이 0이 되어 갱신이 중단됩니다. 대규모 코드북($k \ge 16384$) 환경에서 죽은 클러스터는 유효 코드북 용량을 급격하게 축소시킵니다. 방치된 수많은 빈 중심점은 양자화 해상도를 떨어뜨리고 컴퓨팅 자원을 낭비합니다.
오디오 압축 모델인 EnCodec은 죽은 클러스터가 발생했을 때 현재 배치에서 무작위로 표본을 추출하여 빈자리를 메우는 방식을 사용합니다. 그러나 무작위 보충은 위상적 근거가 부족하여 재배치된 중심점이 다시 소외되기 쉽습니다. e-means는 Faiss의 풍부한 엔지니어링 경험을 흡수하여 클러스터 규모에 비례하는 확률로 거대 클러스터를 표본 추출한 뒤 둘로 분할하는 방식을 채택했습니다. 잉여 연산 자원을 밀도가 가장 높은 데이터 영역에 투입하여 데이터 다양체 분포에 맞게 분할을 진행합니다.
DEEP 데이터셋에서 진행된 소거 연구는 부활 전략에 따른 뚜렷한 격차를 보여줍니다. 100만 개의 벡터와 16,384개의 군집 중심을 대상으로 한 5 에포크 학습에서 부활 메커니즘을 끄면 4,313개(26.3%)의 죽은 클러스터가 발생하고 테스트 MSE는 0.39448을 기록했습니다. EnCodec 방식의 무작위 재샘플링은 2,343개의 죽은 클러스터를 남겼고 테스트 오차는 0.39124였습니다. 반면 비례 분할 메커니즘을 적용하자 죽은 클러스터가 단 47개(0.3%)로 억제되었으며, 테스트 MSE도 0.38762로 더욱 낮아졌습니다.
SIFT 특징점 벤치마크에서도 동일한 양상이 확인되어 분할 전략을 통해 죽은 클러스터의 수가 2,080개에서 10개로 대폭 줄어들었습니다. 벡터 양자화 및 오디오 압축 파이프라인에서 완전히 활용되는 코드북은 신호 복원력을 결정짓습니다. 죽은 클러스터가 활성화되면서 유휴 상태였던 컴퓨팅 대역폭이 실질적인 양자화 변별력으로 전환됩니다.
e-means는 고전적 군집화와 딥러닝 최적화 기술 사이에 존재하던 장벽을 허물었습니다. 이동평균, 코사인 어닐링, 분할 부활 기법을 유기적인 결합체로 완성하여 단 몇 번의 순회만으로 70년 동안 이어진 알고리즘 관성을 넘어섰습니다. 수렴 속도와 품질을 모두 잡은 미니배치 최적화 덕분에 대규모 벡터 양자화 인프라는 새로운 진화 국면을 맞이하게 되었습니다.
참고 링크:
- e-means 프로젝트 홈페이지 및 인터랙티브 데모
- arXiv 논문: e-means: k-means is fast and accurate with modern optimization
- Faiss 오픈소스 리포지토리 기여 모듈: contrib/e_means
- Hacker News 기술 토론