七十年全批量惯性被小批量移动平均打破
深度学习早已转向小批量优化,古典聚类却固守全量扫描七十年。传统 Lloyd 算法每轮重算样本均值,面对千万级向量往往耗尽时间。2026 年 11 月,Matthijs Douze、Hervé Jégou 等 Faiss 维护者联合研究者推出 e-means。项目源自 Meta FAIR 关于小批量 k-means 的早期工作。新算法将现代优化工具系统性带入聚类任务。
Lloyd 算法自 1957 年提出以来,一直主导着向量量化与聚类。每个簇维护样本向量和 $S_j$ 与计数 $N_j$,两者的商决定质心坐标。每一轮更新前,算法必须重置累加器并重读全部数据。随着中心数扩展至数万且样本达到千万,反复全量扫描会耗尽内存带宽。
学术界在 1967 年提出 MacQueen 规则,尝试小批量更新。MacQueen 在流式处理中持续累加统计量,从不衰减历史权重。初期分配错误的样本点,会永久污染质心坐标。早期噪声无法排出,导致聚类中心在后期偏离真实分布。
e-means 选择用指数移动平均接管累加过程。更新公式写作 $S_j \leftarrow (1-\alpha)S_j + \alpha s_j$,按速率 $\alpha$ 逐步衰减旧分配。质心始终跟踪近期批次的局部均值,平滑过滤掉初期错误分配。这套机制此前多用于 VQ-VAE 码本训练,在静态数据集上同样展现出高效收敛。
2 个 epoch 抹平 25 轮迭代误差
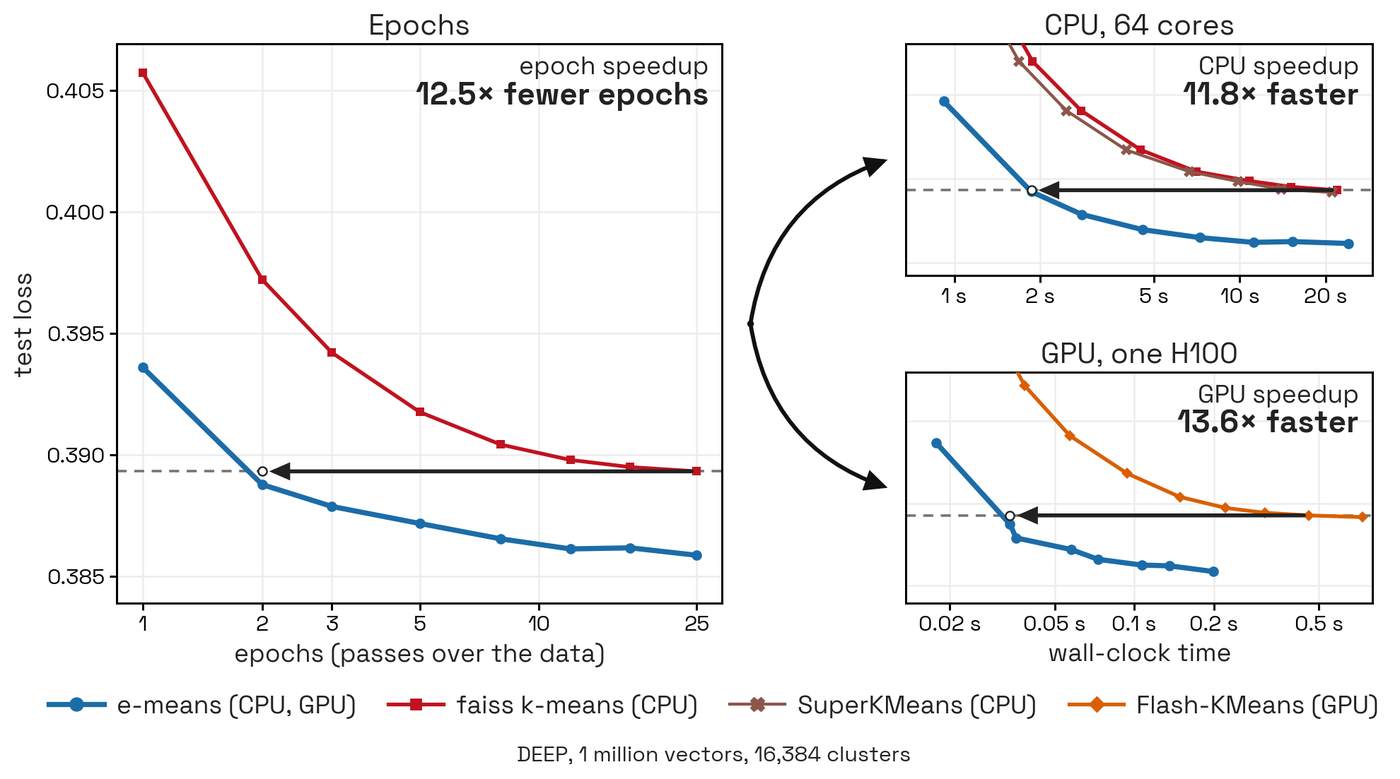 图:e-means 与 Lloyd 在训练轮数、CPU 耗时与 GPU 耗时三个维度上的性能对比。来源:e-means 项目主页
在 11 个 VIBE 多模态基准数据集上,e-means 收敛十分迅猛。测试向量维度横跨 200 到 3072,聚类中心数设定为 8192 与 16384。新算法达到 Lloyd 跑满 25 轮的测试误差,仅需 1.6 到 2.4 个 epoch。聚类流程不再需要数十轮漫长计算,两轮遍历即可逼近全局分布。
以往聚类优化常靠牺牲精度换取吞吐,e-means 打破了这种折中。根据作者在单张 NVIDIA H100(bf16 精度)上的实测数据,运行时间比 Flash-KMeans 缩短 10 到 45 倍。在 CPU 环境下对比 Faiss 原生实现,端到端加速比也达到 8 到 15 倍。速度倍增与更低损失在同一套算法体系中同时兑现。
算法层面的轮数缩减,依赖底层算子支持才能转化为真实墙钟优势。面对 1000 万向量与 65536 个簇的严苛负载,纯 PyTorch Lloyd 耗时超过 140 秒,Flash-KMeans 耗时约为 14 到 22 秒。e-means 开发了专用融合算子,将最近质心分配与移动平均更新合并执行。显存带宽开销得到有效压缩,轮数收益直接折算成数十倍的墙钟加速。
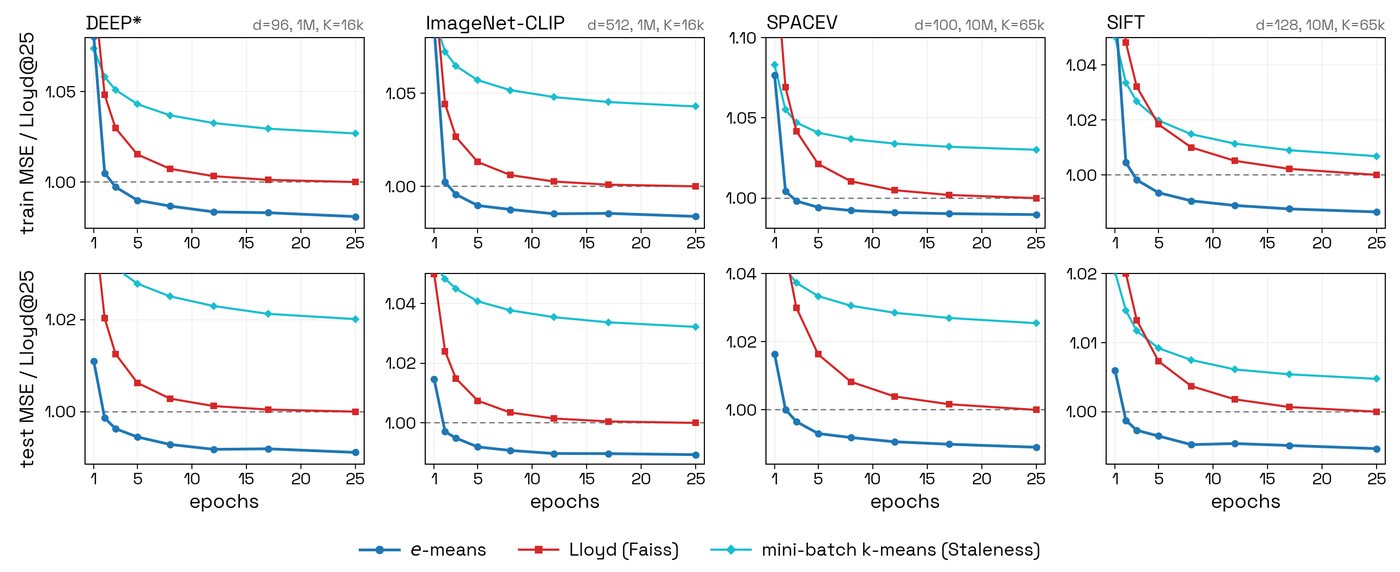 图:相对 Lloyd 第 25 轮的训练与测试均方误差收敛曲线。来源:e-means 项目主页
观察训练与测试均方误差曲线,两者的收敛轨迹差异明显。Lloyd 依靠全量平均在初期快速下降,但在中后期迅速陷入停滞。e-means 仅需一个半 epoch 即可追平测试误差,后续轮次继续刷新更低数值。训练结束时,算法将质心移至最后一轮真实均值,消除了移动平均带来的微小滞后。
小批量随机噪声帮算法跳出局部最优
聚类目标函数具备非凸特性,确定性优化容易陷入死胡同。Lloyd 算法每一步更新都在严格单调降低训练均方误差。这种单调下降构成了局部陷阱,质心滑入次优吸引盆后便无法脱离。糟糕的初始中心分布,往往被算法固化为最终的聚类结果。
小批量采样引入的随机扰动,为探索参数空间提供了动力。在 200 次重复训练测试中,面对规模悬殊的两团合成数据,Lloyd 有 26% 的概率卡死在局部极值。e-means 在相同设置下将卡死概率压低至 3.5%。在五团共线的拓扑结构中,Lloyd 的卡死概率高达 46%,e-means 则实现了 0% 的卡死率。
批次采样的随机方差,天然具备跨越鞍点与狭窄能量壁垒的能力。算法无需复杂的启发式重启,随机扰动自发重塑了质心运动轨迹。随机噪声在深度网络中是探索工具,在聚类任务中展现出相同价值。 次优点被跳过之后,整体聚类质量获得显著提升。
为了保证探索后期平稳收敛,步长调度同样引入了退火策略。算法采用余弦调度曲线,将更新步长从初始值 $\alpha_0$ 缓慢退火至 $0.1\alpha_0$。前期较大步长支持质心穿插探索,后期衰减步长确保收敛稳定。动态步长抑制了随机震荡,兼顾了参数搜索范围与最终定位精度。
两条经验公式免去人工调参成本
小批量聚类过去难以在生产环境取代 Lloyd,关键阻碍在于调参成本。Lloyd 算法虽然耗时漫长,但除了聚类数与迭代轮数外无需设定额外参数。小批量机制则引入了批大小与学习率的选择难题。网格搜索消耗的时间与算力,常常抵消单次运行节省的计算资源。
e-means 借助深度学习中的规模法则,攻克了超参自适应难题。作者拟合了两条经验公式,根据样本量 $n$、中心数 $k$ 与计算预算 $T$ 推导最优超参。公式直接输出批大小 $B$ 与初始步长 $\alpha_0$。在保留测试集上,两条公式的拟合优度 $R^2$ 分别达到 0.96 与 0.95。
自动选定超参的实际表现,经受住了广泛数据集的检验。作者对比详尽网格搜索结果,经验公式配置带来的性能遗憾中位数仅为 0.06% 到 0.20%。工程师不需要投入试错成本微调参数,算法即可自主输出优异的收敛轨迹。免除超参搜索的自适应能力,大幅降低了工程落地门槛。
针对追求极限精度的量化场景,研究团队还提供了偏重质量的公式变体。该配置适当放缓更新节奏,允许算法以适度吞吐换取更低均方误差。在大规模向量索引构建中,这类微小损失收益能够直接改善检索召回率。工程团队可以依据算力预算和精度诉求,灵活切换优化模式。
大簇按比例分裂救活万个量化中心
小批量聚类在工业部署时面临另一大痼疾:中心饥饿导致的死簇现象。当某些聚类中心在当前批次中没有分到样本时,统计量归零,质心便停止更新。在高基数码本($k \ge 16384$)场景中,死簇会急剧压缩有效码本容量。大量空置质心拖累了量化分辨率,造成计算资源浪费。
语音压缩模型 EnCodec 的做法是在出现死簇时,从当前批次随机抽取样本填补空缺。这种随机填补缺乏拓扑依据,重采样的质心极易再次边缘化。e-means 吸收了 Faiss 经典工程经验,改为按簇规模概率抽样大簇并一分为二。算法把富余算力投向密度最高的样本区域,顺应数据流形分布进行分裂。
DEEP 数据集上的消融测试揭示了不同复活策略的显著差距。在 100 万向量、16384 个聚类中心的 5 轮训练中,关闭复活机制会产生 4313 个死簇,占比达到 26.3%,测试均方误差为 0.39448。EnCodec 式随机重采样残留 2343 个死簇,测试误差降为 0.39124。按比例分裂机制将死簇压制到仅剩 47 个(0.3%),测试均方误差进一步降低至 0.38762。
相同趋势在 SIFT 特征基准上再次得到验证,分裂策略将死簇数量从 2080 个压缩至 10 个。在向量量化与音频编码流水线中,满载码本决定了信号保真度。死簇被激活后,原本闲置的计算带宽转化为实际的量化辨识度。
e-means 打破了古典聚类与深度学习优化技术之间的壁垒。算法将移动平均、余弦退火与分裂复活融合为有机整体,用极少轮数跨越了长达七十年的算法惯性。小批量优化兼顾了收敛速度与质量,大规模向量量化基础设施随之迈入新的演化周期。
参考链接:
- e-means 项目主页与交互式演示
- arXiv 论文:e-means: k-means is fast and accurate with modern optimization
- Faiss 开源仓库贡献模块 contrib/e_means
- Hacker News 技术讨论