Mini-Batch-Gleitmittelwerte durchbrechen 70 Jahre Full-Batch-Trägheit
Während Deep Learning längst auf Mini-Batch-Optimierung umgestellt hat, verharrte das klassische Clustering sieben Jahrzehnte lang im Paradigma vollständiger Datensatzdurchläufe. Der traditionelle Lloyd-Algorithmus berechnet in jedem Schritt die Mittelwerte über den gesamten Datenbestand neu – was bei zweistelligen Millionen-Vektormengen enorme Rechenzeit verschlingt. Im November 2026 stellten Matthijs Douze, Hervé Jégou und weitere Maintainer der Faiss-Bibliothek gemeinsam mit Forschenden e-means vor. Das Projekt geht auf frühe Arbeiten von Meta FAIR zu Mini-Batch-k-Means zurück und führt moderne Optimierungsmethoden systematisch in Clustering-Workloads ein.
Seit seiner Formulierung im Jahr 1957 dominiert Lloyds Algorithmus die Vektorquantisierung und das Clustering. Jeder Cluster führt die Vektorsumme $S_j$ und die Zählung $N_j$; ihr Quotient bestimmt die Koordinaten des Schwerpunkts (Zentroids). Vor jeder Aktualisierungsrunde muss der Algorithmus die Akkumulatoren zurücksetzen und den gesamten Datensatz erneut parsen. Wenn die Anzahl der Zentroiden in die Zehntausende wächst und Datenmengen dutzende Millionen Vektoren umfassen, erschöpfen wiederholte vollständige Scans die Speicherbandbreite.
Bereits 1967 schlug MacQueen eine Regel vor, um Aktualisierungen im Streaming-Verfahren durchzuführen. MacQueens Ansatz akkumuliert Statistiken jedoch kontinuierlich, ohne historische Gewichte abklingen zu lassen. In der Anfangsphase fehlerhaft zugeordnete Datenpunkte kontaminieren die Schwerpunktkoordinaten dauerhaft. Da dieses frühe Rauschen nicht bereinigt wird, driften die Clusterzentren im weiteren Verlauf von der tatsächlichen Datenverteilung ab.
e-means ersetzt die simple Akkumulation durch einen exponentiell gleitenden Mittelwert (EMA). Die Aktualisierungsformel lautet $S_j \leftarrow (1-\alpha)S_j + \alpha s_j$, wodurch vergangene Zuweisungen mit der Rate $\alpha$ sukzessive abklingen. Die Zentroiden folgen kontinuierlich dem lokalen Mittelwert aktueller Batches und filtern frühe Fehlzuweisungen zuverlässig heraus. Dieser Mechanismus, der sich zuvor vor allem im Codebook-Training von VQ-VAEs bewährt hat, entfaltet auch auf statischen Datensätzen eine bemerkenswert schnelle Konvergenz.
2 Epochen genügen für die Fehlerwerte aus 25 Iterationen
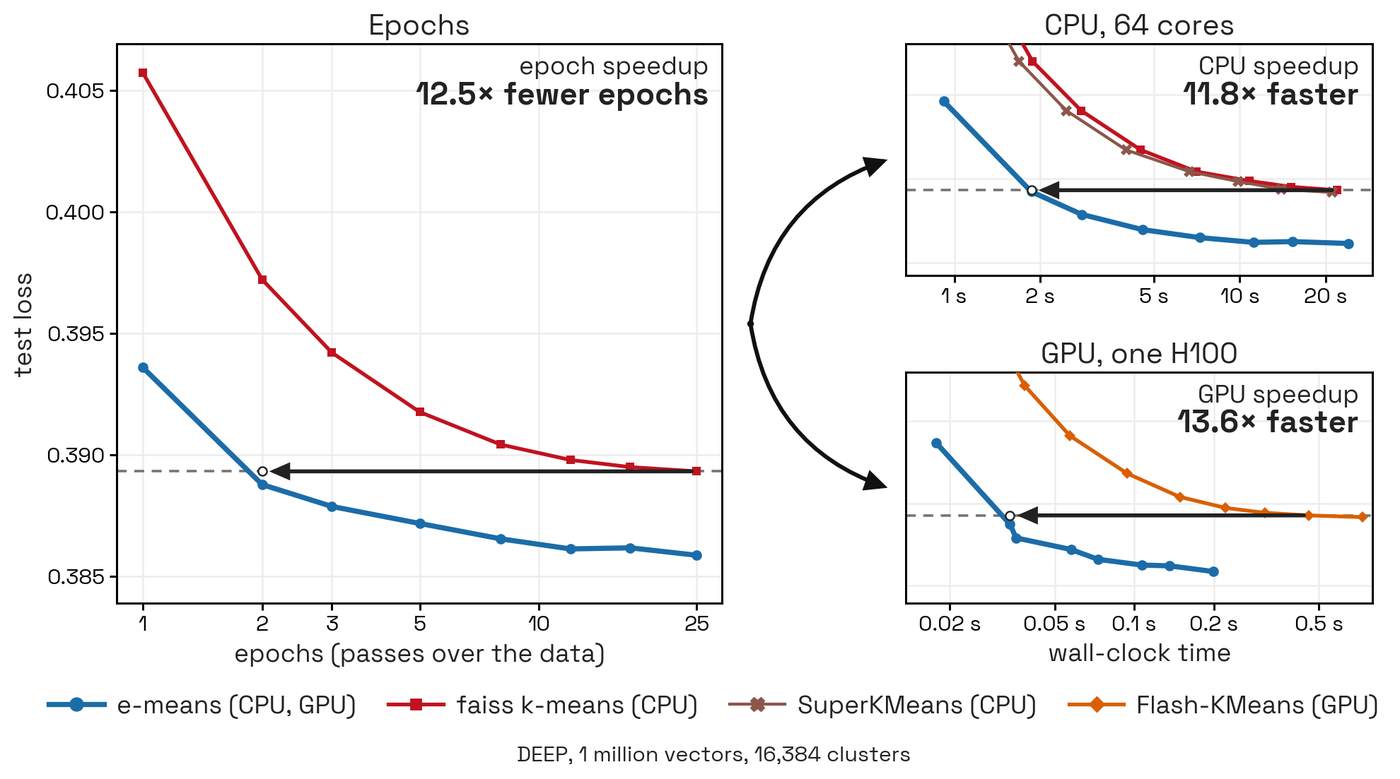 Abbildung: Leistungsvergleich zwischen e-means und Lloyd hinsichtlich Epochenanzahl, CPU-Laufzeit und GPU-Laufzeit. Quelle: e-means Projektseite
Auf 11 multimodalen VIBE-Benchmark-Datensätzen konvergiert e-means außerordentlich schnell. Die getesteten Vektordimensionen reichen von 200 bis 3.072 bei 8.192 und 16.384 Clusterzentren. Um denselben Testfehler wie Lloyd nach 25 vollen Iterationen zu erreichen, benötigt e-means lediglich 1,6 bis 2,4 Epochen. Der Clustering-Prozess erfordert keine Dutzenden langwierigen Rechenrunden mehr; zwei Datendurchläufe reichen aus, um sich der globalen Datenstruktur anzunähern.
Bisherige Clustering-Optimierungen erkauften Durchsatzgewinne oft durch Genauigkeitseinbußen – ein Kompromiss, den e-means auflöst. Auf einer einzelnen NVIDIA H100 (bf16-Präzision) verkürzt sich die Laufzeit gegenüber Flash-KMeans um das 10- bis 45-Fache. Auch auf CPUs im Vergleich zur nativen Faiss-Implementierung erzielt der Algorithmus eine 8- bis 15-fache End-to-End-Beschleunigung. Höhere Geschwindigkeit und geringerer Verlust greifen in demselben algorithmischen Gefüge nahtlos ineinander.
Um weniger Rechenepochen in tatsächliche Wall-Clock-Geschwindigkeitsvorteile umzusetzen, bedarf es optimierter Low-Level-Operatoren. Bei anspruchsvollen Lasten mit 10 Millionen Vektoren und 65.536 Clustern benötigt reines PyTorch-Lloyd über 140 Sekunden, während Flash-KMeans 14 bis 22 Sekunden beansprucht. e-means verwendet eigens entwickelte fusionierte Kernel, die die Zuweisung zum nächsten Zentrum und die Aktualisierung des gleitenden Mittelwerts in einem Durchgang zusammenfassen. Der Speicherbandbreiten-Overhead wird drastisch minimiert, wodurch sich der Epochenvorteil unmittelbar in Dutzendfache reale Laufzeitgewinne übersetzt.
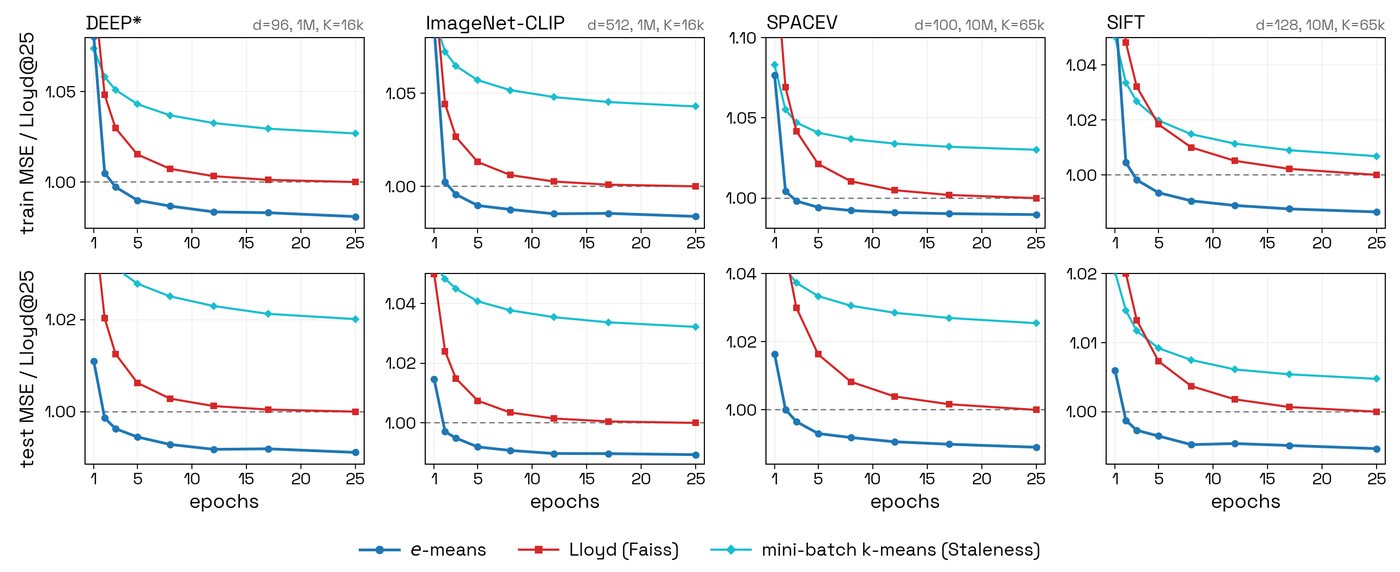 Abbildung: Konvergenzkurven des mittleren quadratischen Fehlers (MSE) für Training und Test relativ zur 25. Lloyd-Iteration. Quelle: e-means Projektseite
Die Gegenüberstellung der Trainings- und Test-MSE-Kurven verdeutlicht die unterschiedliche Konvergenzdynamik. Lloyd fällt anfangs dank vollständiger Mittelwertbildung rasch ab, stagniert im weiteren Verlauf jedoch zügig. e-means erreicht das Testfehlerniveau bereits nach rund anderthalb Epochen und verbessert die Verlustwerte in den darauffolgenden Epochen kontinuierlich weiter. Zum Abschluss des Trainings verschiebt der Algorithmus die Zentroiden auf den tatsächlichen empirischen Mittelwert der letzten Epoche und eliminiert so die minimale Verzögerung des exponentiell gleitenden Durchschnitts.
Mini-Batch-Rauschen überwindet lokale Minima
Da die Zielfunktion beim Clustering nicht konvex ist, laufen deterministische Optimierungsverfahren leicht in Sackgassen. Jeder Iterationsschritt bei Lloyd verringert den Trainings-MSE streng monoton. Diese monotone Abnahme wird zur lokalen Falle: Rutschen Schwerpunkte in ein suboptimales Einzugsgebiet ab, können sie sich nicht mehr daraus befreien. Eine unglückliche initiale Zentroidverteilung wird so vom Algorithmus unausweichlich als Endergebnis zementiert.
Die stochastische Streuung des Mini-Batch-Samplings liefert die kinetische Energie, um den Parameterraum flexibler zu erkunden. In 200 wiederholten Trainingsdurchläufen auf synthetischen Datensätzen mit zwei Clustern stark ungleicher Größe verfing sich Lloyd in 26 % der Fälle in lokalen Extrema. Unter identischen Rahmenbedingungen senkte e-means diese Blockierungsrate auf 3,5 %. In kollinearen Fünf-Cluster-Topologien, in denen Lloyd zu 46 % feststeckte, erreichte e-means eine Fehlerquote von 0 %.
Die Varianz stochastischer Batches besitzt die natürliche Fähigkeit, Sattelpunkte und schmale Energiebarrieren zu überwinden. Ohne aufwendige heuristische Neustarts ordnet das Rauschen die Bewegungspfade der Schwerpunkte dynamisch neu. Was im Deep Learning als etabliertes Explorationswerkzeug gilt, entfaltet beim Clustering denselben Wert. Durch das Überspringen lokaler Minima steigt die Gesamtqualität der Clusterstrukturen messbar.
Um gegen Ende der Optimierungsphase eine stabile Konvergenz sicherzustellen, setzt e-means auf eine Cosine-Annealing-Strategie für die Schrittweite. Entlang einer Kosinuskurve kühlt die Lernrate vom Ausgangswert $\alpha_0$ graduell auf $0,1\alpha_0$ ab. Größere Schritte zu Beginn ermöglichen weitreichende Erkundungen zwischen Clustern; die reduzierte Schrittweite in der Spätphase dämpft stochastische Schwingungen und garantiert eine präzise Feinpositionierung.
Zwei empirische Formeln machen manuelles Tuning überflüssig
Der Hauptgrund, warum Mini-Batch-Clustering Lloyd in Produktionsumgebungen bislang kaum verdrängen konnte, lag im hohen Aufwand für das Hyperparameter-Tuning. Lloyd benötigt abgesehen von Clusteranzahl und Iterationsbudget keine Parametrisierung. Das Mini-Batch-Verfahren erfordert hingegen die feinfühlige Wahl von Batch-Größe und Schrittweite. Die Rechenzeit für Gittersuchen fraß die Performancegewinne einzelner Durchläufe häufig wieder auf.
Mithilfe von Skalierungsgesetzen (Scaling Laws) aus dem Deep Learning löst e-means das Problem der automatischen Parameteranpassung. Die Autoren ermittelten zwei empirische Gleichungen, die aus Stichprobengröße $n$, Clusteranzahl $k$ und Rechenbudget $T$ die optimalen Einstellungen ableiten. Die Formeln berechnen direkt die Batch-Größe $B$ und die anfängliche Schrittweite $\alpha_0$. Auf separaten Testdaten erreichten beide Formeln Bestimmtheitsmaße ($R^2$) von 0,96 bzw. 0,95.
Die Praxistauglichkeit dieser abgeleiteten Hyperparameter bewährte sich über zahlreiche Datensätze hinweg. Verglichen mit erschöpfenden Gittersuchen lag der mediane Performanceverlust (Regret) der analytischen Konfiguration bei lediglich 0,06 % bis 0,20 %. Entwickler müssen keine Ressourcen für zeitaufwendiges Ausprobieren aufwenden; der Algorithmus wählt selbstständig einen optimalen Konvergenzpfad. Der Wegfall der Hyperparametersuche senkt die Hürde für den produktiven Praxiseinsatz erheblich.
Für Quantisierungsaufgaben mit Fokus auf maximale Güte stellt das Team zudem eine qualitätsorientierte Formelvariante bereit. Diese drosselt das Aktualisierungstempo geringfügig und tauscht ein wenig Durchsatz gegen einen noch niedrigeren mittleren quadratischen Fehler ein. Beim Aufbau großer Vektorindizes verbessert dieser feine Gewinn unmittelbar die Retrieval-Recall-Rate. Ingenieurteams können je nach Budget und Präzisionsanforderung flexibel zwischen den Modi wechseln.
Proportionale Aufspaltung reaktiviert tausende inaktive Zentren
Beim industriellen Einsatz leidet Mini-Batch-Clustering unter einer weiteren Schwachstelle: inaktiven Zentroiden (“Dead Clusters”), die durch Verhungern entstehen. Erhält ein Clusterzentrum in einem Batch keine Zuweisungen, sinkt seine Statistik auf null und die Aktualisierung bricht ab. Bei hochdimensionalen Codebüchern ($k \ge 16384$) schrumpft dadurch die nutzbare Kapazität drastisch. Verwaiste Schwerpunkte vermindern die Quantisierungsauflösung und vergeuden Rechenressourcen.
Das Audiokompressionsmodell EnCodec begegnet diesem Problem, indem es bei toten Zentren zufällige Vektoren aus dem aktuellen Batch als Ersatz wählt. Dieser zufälligen Neuzuweisung fehlt jedoch die topologische Bindung, wodurch reaktivierte Schwerpunkte rasch wieder an den Rand gedrängt werden. e-means greift auf bewährte Faiss-Entwicklungspraxis zurück: Große Cluster werden proportional zu ihrer Größe ausgewählt und in zwei neue Zentren aufgespalten. Überschüssige Rechenleistung wird gezielt in Zonen höchster Punktdichte gelenkt, wodurch sich die Spaltung harmonisch an die Datenmannigfaltigkeit anpasst.
Ablationstests auf dem DEEP-Datensatz belegen die gravierenden Unterschiede zwischen den Wiederbelebungsstrategien. Bei 1 Million Vektoren und 16.384 Clustern über 5 Epochen hinweg erzeugte das Training ohne Reaktivierung 4.313 tote Cluster (26,3 % des Codebuchs) bei einem Test-MSE von 0,39448. Der Zufallsansatz von EnCodec hinterließ noch 2.343 inaktive Cluster (MSE: 0,39124). Die proportionale Aufspaltung reduzierte die Zahl toter Zentren dagegen auf nur noch 47 (0,3 %) und drückte den Test-MSE auf 0,38762.
Derselbe Trend bestätigte sich im SIFT-Feature-Benchmark: Hier schrumpfte die Zahl inaktiver Zentroiden von 2.080 auf lediglich 10 zusammen. In Vektorquantisierungs- und Audiocodierungs-Pipelines bestimmt die lückenlose Ausnutzung des Codebuchs die Signalgenauigkeit. Durch das Wiederbeleben inaktiver Cluster verwandelt sich ungenutzte Rechenbandbreite direkt in messbare Auflösung.
e-means überbrückt die Kluft zwischen klassischem Clustering und modernen Deep-Learning-Optimierungsmethoden. Durch das Zusammenspiel von gleitenden Mittelwerten, Cosine Annealing und gezielter Clusteraufspaltung überwindet der Algorithmus die Trägheit von 70 Jahren Verfahrensgeschichte in nur wenigen Epochen. Da Mini-Batch-Optimierung Tempo und Modellgüte vereint, erreicht die Infrastruktur großskaliger Vektorquantisierung eine neue Evolutionsstufe.
Weiterführende Links:
- e-means Projektseite und interaktive Demo
- arXiv-Paper: e-means: k-means is fast and accurate with modern optimization
- Faiss Open-Source-Repository Modul: contrib/e_means
- Hacker News Fachdiskussion