ミニバッチ移動平均が打ち破る70年のフルバッチ慣性
深層学習がミニバッチ最適化へ移行して久しい一方、古典的クラスタリングは70年もの間、全データ走査の枠組みにとどまり続けてきました。伝統的なLloydのアルゴリズムは各反復で全サンプルの平均値を再計算するため、数千万規模のベクトルを前に膨大な時間を費やします。2026年11月、Matthijs Douze氏やHervé Jégou氏らFaissのメンテナ陣が研究チームと連携し、「e-means」を発表しました。このプロジェクトはMeta FAIRにおけるミニバッチk-meansの初期研究に端を発し、現代的な最適化技術をクラスタリングタスクへと体系的に持ち込みました。
1957年に提唱されて以来、Lloydのアルゴリズムはベクトル量子化とクラスタリングの分野を支配してきました。各クラスタはサンプルベクトルの総和 $S_j$ とカウント $N_j$ を保持し、両者の商から重心座標を算出します。各更新ステップの前に、アルゴリズムはアキュムレータを初期化し、全データを再度読み込まなければなりません。中心数が数万に拡大しサンプルが数千万に達すると、反復的なフルスキャンはメモリ帯域を枯渇させます。
学術界では1967年にMacQueen規則が提案され、ミニバッチ的な更新が試みられました。しかしMacQueen法はストリーミング処理で統計量を蓄積し続けるのみで、過去の重みを減衰させません。その結果、初期に誤分類されたサンプルが重心座標を永続的に汚染してしまいます。初期のノイズを排除できないため、クラスタ中心は次第に真の分布から乖離していきました。
e-meansは単純な累積に代わり、指数移動平均(EMA)を採用しました。更新式は $S_j \leftarrow (1-\alpha)S_j + \alpha s_j$ と表され、レート $\alpha$ に応じて古い割り当てを徐々に減衰させます。重心は直近バッチの局所平均を常に追随し、初期の誤分類を滑らかに除去します。この仕組みはこれまでVQ-VAEのコードブック学習などで広く使われてきましたが、静的データセットに対しても極めて優れた収束性を示すことが判明しました。
わずか2エポックで25反復の誤差に到達
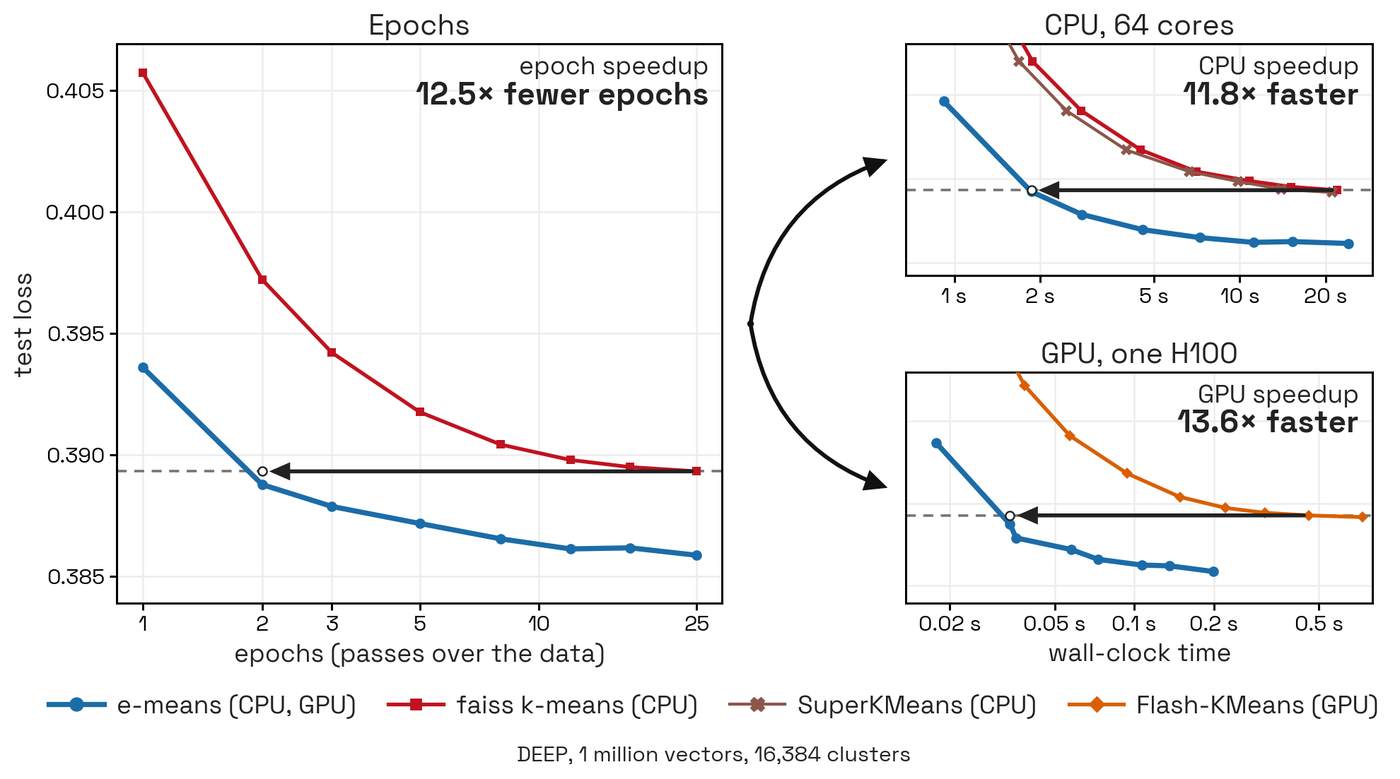 図:学習エポック数、CPU所要時間、GPU所要時間の3軸におけるe-meansとLloydの性能比較。出典:e-meansプロジェクトページ
11種類のVIBEマルチモーダルベンチマークにおいて、e-meansは目覚ましい収束速度を示しています。テストベクトルの次元数は200から3072、クラスタ中心数は8192および16384に設定されています。新アルゴリズムは、Lloydが25反復を完了したときのテスト誤差に、わずか1.6〜2.4エポックで到達しました。クラスタリングのプロセスに数十回もの時間のかかる全走査はもはや不要であり、データをわずか2周するだけで大局的な分布へ収斂します。
従来のクラスタリング最適化は精度を犠牲にしてスループットを得ることが通例でしたが、e-meansはこのトレードオフを打破しました。著者らによる単一のNVIDIA H100(bf16精度)での実測データによると、Flash-KMeansと比較して実行時間は1/10〜1/45に短縮されました。Faissネイティブ実装と比較したCPU環境でも、8〜15倍のエンドツーエンド高速化を達成しています。速度の向上と損失の低減が、単一のアルゴリズム体系の中で同時に実現されたのです。
アルゴリズム面での反復数削減を実際のウォールクロック時間短縮へと結びつけるには、低レベル演算子の最適化が不可欠です。1000万ベクトルかつ65536クラスタという過酷なワークロードにおいて、純粋なPyTorchによるLloydは140秒以上を要し、Flash-KMeansでも14〜22秒かかります。e-meansは専用の融合カーネルを開発し、最近傍重心の割り当てと移動平均の更新を1回の実行パスに統合しました。メモリ帯域幅のオーバーヘッドが大幅に削減され、反復数の削減効果が数十倍ものウォールクロック短縮へと直結しています。
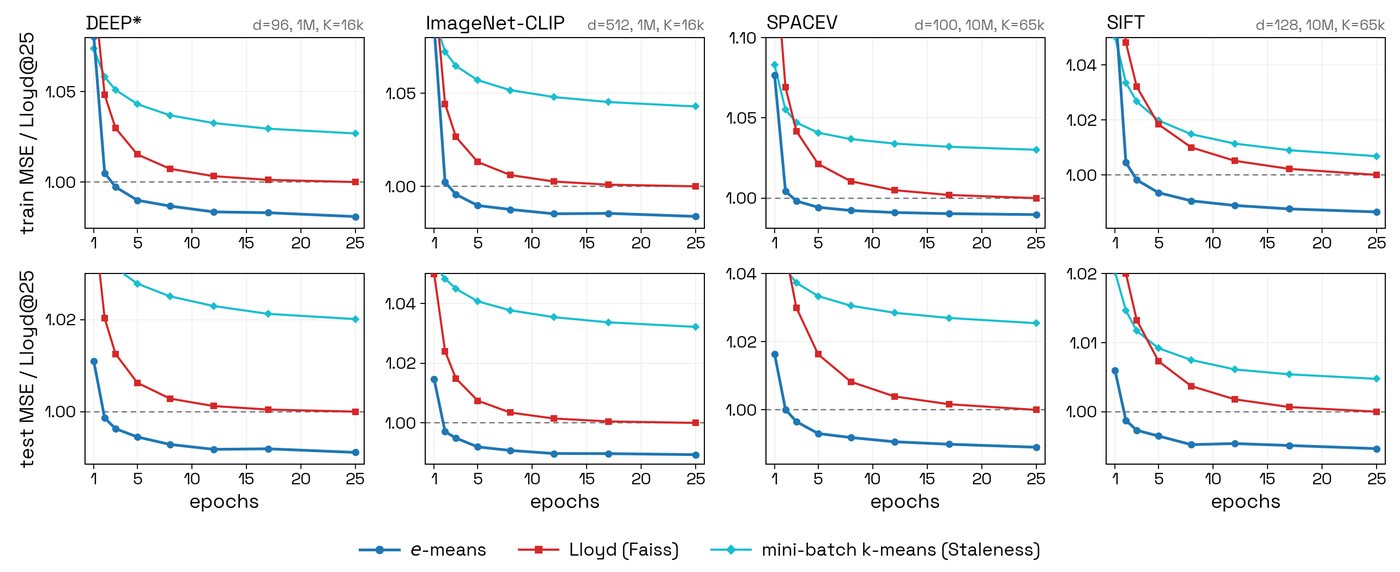 図:Lloyd第25反復に対する訓練およびテスト平均二乗誤差の収束曲線。出典:e-meansプロジェクトページ
訓練およびテストの平均二乗誤差(MSE)曲線を観察すると、両者の収束ダイナミクスには顕著な違いが見られます。Lloydは全量平均によって初期に急激に誤差を下げますが、中盤から終盤にかけて急速に停滞します。対してe-meansは1.5エポックでテスト誤差に追いつき、それ以降のエポックでさらに低い数値を記録し続けます。学習の終了時、アルゴリズムは重心を最終エポックの実平均へと移動させ、移動平均による微小な遅延を解消します。
ミニバッチの確率的ノイズが局所解脱出を促す
クラスタリングの目的関数は非凸性を持つため、決定論的な最適化は局所解に陥りやすくなります。Lloydのアルゴリズムは各更新ステップで訓練MSEを厳格かつ単調に減少させます。しかしこの単調減少こそが局所的な罠となり、重心がいったん準最適解の引力圏に入ると脱出できません。初期配置のばらつきが、そのまま劣ったクラスタリング結果として固定化されてしまうのです。
ミニバッチサンプリングがもたらす確率的な揺らぎは、パラメータ空間を探索する強力な駆動力となります。規模が大きく異なる2つのクラスタを持つ合成データにおける200回の繰り返し検証では、Lloydが局所解に捕まる確率は26%でした。一方、同一条件下におけるe-meansの失敗確率はわずか3.5%に抑えられました。さらに5つのクラスタが同一直線上に並ぶトポロジーにおいて、Lloydの局所解捕縛率は46%に達したのに対し、e-meansは0%を達成しました。
バッチサンプリングの分散は、鞍点や狭いエネルギー障壁を乗り越える能力を本質的に備えています。複雑なヒューリスティックによるリスタートを用いずとも、ランダムな擾乱が重心の移動軌道を自律的に再構成します。深層ネットワークにおいて探索ツールとして機能する確率的ノイズは、クラスタリングタスクにおいても同様の価値を発揮します。 局所解を回避することで、全体のクラスタリング品質は大きく向上します。
探索後半の安定した収束を保証するため、ステップサイズのスケジューリングにはアニーリング戦略が導入されています。コサイン減衰曲線を用い、更新ステップ幅を初期値 $\alpha_0$ から $0.1\alpha_0$ へと緩やかに減衰させます。序盤の大きなステップ幅でクラスタ間の探索を促し、終盤の減衰したステップ幅で確実に収束させます。動的なステップサイズが過度な振動を抑え、探索範囲の広さと最終的な位置決め精度を両立させています。
2つの経験則が手動チューニングのコストを排除
これまでミニバッチクラスタリングが本番環境でLloydを置き換えられなかった最大の要因は、ハイパーパラメータ調整のコストにありました。Lloydは処理こそ長時間を要するものの、クラスタ数と反復回数以外に設定すべきパラメータがありません。一方、ミニバッチ方式ではバッチサイズや学習率の選定という難題が生じます。グリッドサーチに費やされる時間と計算資源が、高速化によるメリットを相殺してしまうことが多々ありました。
e-meansは深層学習におけるスケーリング則に着想を得て、ハイパーパラメータの自動適合を実現しました。著者らはサンプル数 $n$、中心数 $k$、計算予算 $T$ に基づいて最適値を導出する2つの経験則を定式化しました。この数式により、バッチサイズ $B$ と初期ステップサイズ $\alpha_0$ を直接算出できます。テストセットにおいて、両式の決定係数($R^2$)はそれぞれ0.96および0.95に達しています。
自動選定されたパラメータの有効性は、多様なデータセットで実証されています。網羅的なグリッドサーチの結果と比較しても、経験則による設定の性能低下(リグレット)の中央値はわずか0.06%〜0.20%にとどまりました。エンジニアが試行錯誤して調整することなく、アルゴリズムが自律的に最適な収束経路を選択します。ハイパーパラメータ探索を不要にした自律適合能力は、実運用への導入ハードルを劇的に引き下げました。
極限の精度が求められる量子化シナリオ向けに、研究チームは品質重視型の公式バリアントも提供しています。この設定では更新ペースを意図的に緩め、適度なスループットと引き換えにさらに低いMSEを追求します。大規模なベクトルインデックス構築において、このような微小な損失改善は検索再現率の向上に直接寄与します。エンジニアリングチームは計算予算と精度要件に応じて、最適化モードを柔軟に切り替えることが可能です。
プロポーショナル分割が万単位の量子化中心を蘇らせる
ミニバッチクラスタリングを産業展開する際、もうひとつの深刻な問題となるのが「中心の枯渇(死んだクラスタ)」です。あるバッチ内でサンプルが1つも割り当てられなかった中心は、統計量がゼロとなり更新が停止します。高基数コードブック($k \ge 16384$)の環境では、死んだクラスタが有効なコードブック容量を急速に圧迫します。多数の空き中心が量子化解像度を低下させ、計算リソースの浪費につながるのです。
音声圧縮モデルEnCodecでは、死んだクラスタが発生した際に現行バッチからランダムにサンプルを抽出して補充する手法をとっています。しかしランダムな補充にはトポロジー的な根拠が乏しく、再配置された中心が再び孤立しがちでした。e-meansはFaissの実践的知見を取り入れ、クラスタ規模に応じた確率で大きなクラスタをサンプリングし、2つに分割する手法を採用しました。余剰な計算力を最も密度の高いサンプル領域へと振り向け、データの多様体構造に沿って分割を行います。
DEEPデータセットでのアブレーション実験は、復活戦略による顕著な性能差を明らかにしています。100万ベクトル・16384クラスタ中心の5エポック学習において、復活メカニズムを無効にすると4313個(全体の26.3%)の死んだクラスタが生じ、テストMSEは0.39448でした。EnCodec方式のランダムサンプリングでは2343個の死んだクラスタが残り、テストMSEは0.39124でした。これに対しプロポーショナル分割を適用したところ、死んだクラスタはわずか47個(0.3%)に激減し、テストMSEも0.38762へと大幅に改善しました。
SIFT特徴量ベンチマークでも同様の傾向が確認され、分割戦略によって死んだクラスタ数は2080個から10個へと圧縮されました。ベクトル量子化や音声符号化パイプラインにおいて、フル稼働するコードブックは信号の忠実度を左右します。休眠していたクラスタが活性化されることで、遊休計算帯域が実質的な量子化精度へと変換されます。
e-meansは、古典的クラスタリングと深層学習の最適化技術との間に存在した障壁を取り払いました。指数移動平均、コサインアニーリング、分割復活機構を有機的に融合させることで、わずか数エポックで70年におよぶアルゴリズムの慣性を乗り越えました。収束速度と品質を両立させたミニバッチ最適化により、大規模ベクトル量子化インフラは新たな進化の段階へと足を踏み入れました。
参考リンク:
- e-meansプロジェクトページ・インタラクティブデモ
- arXiv論文:e-means: k-means is fast and accurate with modern optimization
- Faissオープンソースリポジトリ貢献モジュール:contrib/e_means
- Hacker News技術ディスカッション