Siete décadas de inercia full-batch rotas por medias móviles en mini-batches
El aprendizaje profundo adoptó la optimización por mini-batches hace años, pero el clustering clásico permaneció anclado a escaneos completos del conjunto de datos durante siete décadas. El algoritmo tradicional de Lloyd recalcula la media de todas las muestras en cada ronda, agotando el tiempo de procesamiento ante decenas de millones de vectores. En noviembre de 2026, Matthijs Douze, Hervé Jégou y otros mantenedores de Faiss presentaron e-means en colaboración con un equipo de investigadores. El proyecto surge de trabajos iniciales de Meta FAIR sobre k-means por mini-batches y traslada de forma sistemática las herramientas modernas de optimización a las tareas de agrupamiento.
Desde su propuesta en 1957, el algoritmo de Lloyd ha dominado la cuantización vectorial y el clustering. Cada grupo mantiene la suma de vectores $S_j$ y el recuento $N_j$; el cociente de ambos determina las coordenadas del centroide. Antes de cada actualización, el algoritmo debe reiniciar los acumuladores y releer todos los datos. A medida que los centroides escalan a decenas de miles y las muestras alcanzan decenas de millones, los escaneos completos continuos saturan el ancho de banda de memoria.
En 1967, la comunidad académica propuso la regla de MacQueen para intentar actualizaciones continuas. No obstante, MacQueen acumula estadísticas sin atenuar los pesos históricos. Por ello, las muestras asignadas erróneamente en fases iniciales contaminan las coordenadas del centroide de forma irreversible. Al no poder purgar este ruido temprano, los centros de los clústeres se desvían de la distribución real en etapas avanzadas.
e-means opta por sustituir la acumulación directa por una media móvil exponencial (EMA). La regla de actualización se expresa como $S_j \leftarrow (1-\alpha)S_j + \alpha s_j$, reduciendo progresivamente el peso de asignaciones antiguas a un ritmo $\alpha$. Los centroides siguen en todo momento la media local de los lotes recientes, filtrando con suavidad los errores tempranos. Este mecanismo, empleado tradicionalmente en el entrenamiento de libros de códigos para VQ-VAE, demuestra una convergencia sumamente eficiente en conjuntos de datos estáticos.
2 épocas bastan para igualar el error de 25 iteraciones
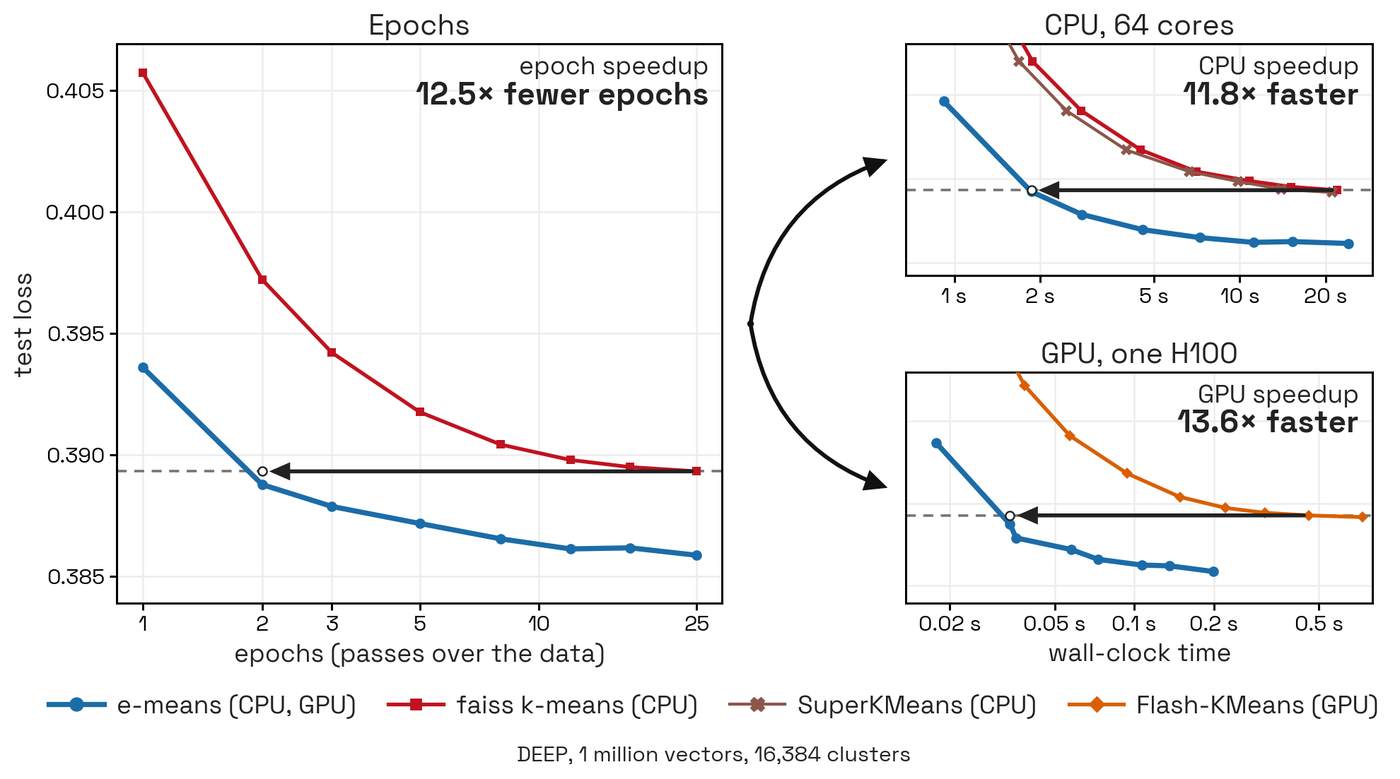 Figura: Comparativa de rendimiento entre e-means y Lloyd en tres dimensiones: épocas de entrenamiento, tiempo de cómputo en CPU y tiempo en GPU. Fuente: página oficial de e-means
En 11 conjuntos de datos del benchmark multimodal VIBE, e-means muestra una convergencia extraordinariamente rápida. Las dimensiones vectoriales evaluadas van de 200 a 3072, con configuraciones de 8192 y 16384 centroides. El nuevo algoritmo alcanza el error de test que Lloyd obtiene tras 25 iteraciones completas en solo 1,6 a 2,4 épocas. El flujo de agrupamiento ya no exige decenas de pasadas exhaustivas; dos recorridos bastan para aproximar la geometría global de los datos.
Las optimizaciones previas de clustering solían sacrificar precisión a cambio de rendimiento, un dilema que e-means supera por completo. En pruebas sobre una única GPU NVIDIA H100 (precisión bf16), el tiempo de ejecución se reduce entre 10 y 45 veces respecto a Flash-KMeans. En entornos de CPU frente a la implementación nativa de Faiss, la aceleración de extremo a extremo alcanza entre 8 y 15 veces. Mayor velocidad y menor pérdida convergen de manera simultánea en el mismo marco algorítmico.
La reducción de épocas a nivel algorítmico depende de operadores de bajo nivel optimizados para traducirse en ahorros reales de tiempo de reloj. Ante cargas exigentes de 10 millones de vectores y 65.536 clústeres, PyTorch Lloyd puro supera los 140 segundos, mientras que Flash-KMeans toma entre 14 y 22 segundos. e-means implementa kernels fusionados específicos que ejecutan de forma conjunta la asignación del centroide más cercano y la actualización de la media móvil. El cuello de botella de ancho de banda de memoria se comprime eficazmente, transformando la reducción de épocas en decenas de veces de aceleración real.
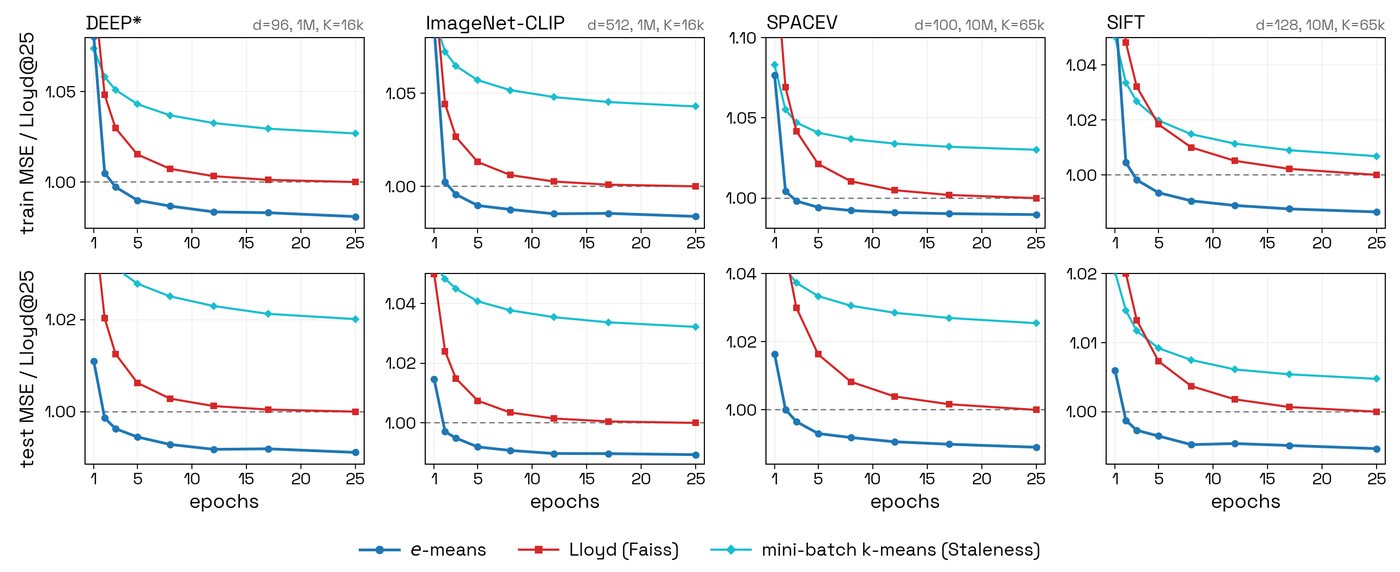 Figura: Curvas de convergencia del error cuadrático medio (MSE) de entrenamiento y test en relación con la iteración 25 de Lloyd. Fuente: página oficial de e-means
Al analizar las curvas de error cuadrático medio (MSE) de entrenamiento y test, se aprecian dinámicas de convergencia muy diferenciadas. Lloyd cae rápidamente al inicio gracias al promedio completo, pero se estanca enseguida en fases intermedias y finales. e-means iguala el error de test en solo época y media y continúa registrando pérdidas más reducidas en las rondas posteriores. Al finalizar el entrenamiento, el algoritmo desplaza los centroides a la media empírica de la última época, eliminando cualquier desfase residual de la media móvil.
El ruido estocástico del mini-batch ayuda a escapar de óptimos locales
Dado que la función objetivo del clustering no es convexa, la optimización determinista suele quedar atrapada en callejones sin salida. Cada paso de actualización en Lloyd reduce de forma estrictamente monótona el MSE de entrenamiento. Este descenso monótono actúa como una trampa local: una vez que los centroides caen en una cuenca de atracción subóptima, no pueden escapar. Una distribución inicial deficiente queda fijada irremediablemente como el resultado final del agrupamiento.
La perturbación aleatoria introducida por el muestreo de mini-batches aporta la energía cinética necesaria para explorar el espacio de parámetros. En 200 repeticiones de entrenamiento sobre datos sintéticos con dos agrupaciones de tamaño dispar, Lloyd quedó bloqueado en extremos locales el 26% de las veces. Bajo las mismas condiciones, e-means redujo esa tasa de estancamiento al 3,5%. En topologías con cinco clústeres colineales, donde Lloyd se bloqueó en el 46% de los casos, e-means logró un 0% de fallos.
La varianza del muestreo por lotes posee una capacidad natural para superar puntos de silla y barreras energéticas estrechas. Sin requerir reinicios heurísticos complejos, las perturbaciones estocásticas remodelan por sí solas las trayectorias de los centroides. El ruido aleatorio, utilizado habitualmente como herramienta de exploración en redes profundas, aporta el mismo valor en tareas de clustering. Al sortear los mínimos locales, la calidad global del agrupamiento mejora sensiblemente.
Para asegurar una convergencia estable en la fase final, la tasa de aprendizaje incorpora una estrategia de recocido (annealing). Mediante una curva de decaimiento cosenoidal, el paso de actualización disminuye suavemente desde un valor inicial $\alpha_0$ hasta $0,1\alpha_0$. Un paso mayor al principio favorece la exploración libre de los centroides, mientras que el ritmo atenuado en etapas finales afianza la estabilidad. La tasa dinámica suprime oscilaciones y equilibra la amplitud de búsqueda con la precisión final.
Dos fórmulas empíricas eliminan el coste del ajuste manual
La principal barrera que impedía al clustering por mini-batches sustituir a Lloyd en producción era el coste de sintonizar hiperparámetros. Aunque Lloyd es lento, no exige parámetros adicionales más allá del número de clústeres y las iteraciones. En cambio, los mini-batches introducen la dificultad de seleccionar el tamaño de lote y la tasa de aprendizaje. El tiempo y cómputo invertidos en búsquedas por malla solían anular el ahorro obtenido en ejecuciones individuales.
Inspirándose en las leyes de escala (scaling laws) del aprendizaje profundo, e-means resuelve la selección automática de hiperparámetros. Los autores ajustaron dos fórmulas empíricas que derivan los parámetros óptimos a partir del número de muestras $n$, el número de centros $k$ y el presupuesto computacional $T$. Las ecuaciones determinan directamente el tamaño de lote $B$ y el paso inicial $\alpha_0$. En conjuntos de prueba independientes, el coeficiente de determinación ($R^2$) de ambas expresiones alcanza 0,96 y 0,95.
La eficacia práctica de estos hiperparámetros automatizados se confirmó en una amplia variedad de datos. Frente a búsquedas exhaustivas por malla, la pérdida de rendimiento mediana (regret) provocada por las fórmulas empíricas oscila entre un 0,06% y un 0,20%. Los ingenieros no necesitan gastar recursos en pruebas de ensayo y error: el algoritmo traza de manera autónoma una trayectoria de convergencia óptima. Eliminar la búsqueda de hiperparámetros reduce de forma sustancial la barrera de adopción en producción.
Para aplicaciones de cuantización que exigen máxima fidelidad, el equipo ofrece además una variante de formulación orientada a la calidad. Esta opción modera el ritmo de actualización, cediendo un margen de rendimiento a cambio de un MSE todavía más bajo. En la construcción de índices vectoriales a gran escala, estas pequeñas mejoras en la pérdida repercuten de forma directa en la precisión de recuperación (recall). Los equipos de ingeniería pueden alternar entre modos según su presupuesto computacional y sus requisitos de precisión.
La división proporcional rescata miles de centros inactivos
En entornos industriales, el clustering por mini-batches se enfrenta a otro problema crónico: los clústeres muertos ocasionados por la inanición de centros. Cuando determinados centroides no reciben muestras en un lote concreto, sus estadísticas quedan a cero y su actualización se interrumpe. En libros de códigos con alta cardinalidad ($k \ge 16384$), los clústeres muertos reducen drásticamente la capacidad efectiva. Numerosos centroides vacíos merman la resolución de la cuantización y desperdician recursos de cómputo.
El modelo de compresión de audio EnCodec aborda este problema seleccionando muestras aleatorias del lote en curso para ocupar las posiciones inactivas. Sin embargo, este relleno aleatorio carece de fundamento topológico y los centroides reubicados tienden a quedar marginados de nuevo. e-means adopta la experiencia práctica de Faiss y opta por muestrear clústeres grandes de forma proporcional a su volumen para dividirlos en dos. El algoritmo canaliza la capacidad de cómputo hacia las regiones de mayor densidad muestral, dividiendo los centros en armonía con la variedad de los datos.
Las pruebas de ablación en el conjunto de datos DEEP reflejan diferencias contundentes entre las estrategias de reactivación. En un entrenamiento de 5 épocas con 1 millón de vectores y 16.384 centros, desactivar la resurrección produjo 4.313 clústeres muertos (26,3% del total) con un MSE de test de 0,39448. El remuestreo aleatorio tipo EnCodec dejó 2.343 centros inactivos y un MSE de 0,39124. En contraste, la división proporcional redujo los clústeres muertos a solo 47 (0,3%), recortando el MSE de test a 0,38762.
La misma tendencia se repite en el benchmark de características SIFT, donde la estrategia de división contrajo el número de clústeres muertos de 2.080 a tan solo 10. En canalizaciones de cuantización vectorial y compresión de audio, un libro de códigos plenamente aprovechado define la fidelidad de la señal. Al reactivar los centros muertos, el ancho de banda computacional inactivo se convierte directamente en mayor nitidez de cuantización.
e-means rompe las barreras tradicionales entre el clustering clásico y la optimización en aprendizaje profundo. Al combinar medias móviles, recocido cosenoidal y resurrección por división en un esquema unificado, deja atrás siete décadas de inercia algorítmica en un número mínimo de épocas. Gracias a una optimización por mini-batches que aúna velocidad de convergencia y calidad, la infraestructura de cuantización vectorial a gran escala da el salto hacia una nueva etapa evolutiva.
Enlaces de referencia:
- Página del proyecto e-means y demostración interactiva
- Artículo en arXiv: e-means: k-means is fast and accurate with modern optimization
- Módulo contribuido en el repositorio de Faiss: contrib/e_means
- Discusión técnica en Hacker News