Sept décennies d’inertie en batch complet bousculées par les moyennes mobiles en mini-batches
Alors que l’apprentissage profond a adopté depuis longtemps l’optimisation par mini-batches, le clustering classique est resté figé pendant sept décennies dans le paradigme des balayages complets de données. L’algorithme traditionnel de Lloyd recalcule les moyennes de tous les échantillons à chaque itération, ce qui épuise rapidement le temps de calcul face à des dizaines de millions de vecteurs. En novembre 2026, Matthijs Douze, Hervé Jégou et d’autres mainteneurs de la bibliothèque Faiss ont dévoilé e-means en collaboration avec des chercheurs. Issu de travaux exploratoires menés chez Meta FAIR sur le k-means par mini-batches, ce nouvel algorithme introduit systématiquement les outils modernes d’optimisation au cœur du partitionnement de données.
Depuis sa formulation en 1957, l’algorithme de Lloyd domine la quantification vectorielle et le clustering. Chaque cluster conserve la somme vectorielle de ses échantillons $S_j$ et leur nombre $N_j$ ; le quotient des deux définit les coordonnées du centroïde. Avant chaque passe de mise à jour, l’algorithme doit réinitialiser ses accumulateurs et reparcourir l’intégralité des données. Lorsque les centroïdes se comptent par dizaines de milliers et les échantillons par dizaines de millions, ces balayages complets répétés saturent la bande passante mémoire.
Dès 1967, la communauté académique a proposé la règle de MacQueen pour tenter des mises à jour en continu. Cependant, MacQueen accumule les statistiques au fil de l’eau sans jamais atténuer les poids historiques. Par conséquent, les points de données mal assignés dans les premières phases contaminent durablement les coordonnées des centroïdes. Incapables d’évacuer ce bruit initial, les centres dérivent peu à peu de la distribution réelle au cours des étapes ultérieures.
e-means choisit de remplacer la simple accumulation par une moyenne mobile exponentielle (EMA). La règle de mise à jour s’écrit $S_j \leftarrow (1-\alpha)S_j + \alpha s_j$, appliquant une décroissance progressive aux assignations passées à un rythme $\alpha$. Les centroïdes suivent en permanence la moyenne locale des lots récents et filtrent harmonieusement les erreurs initiales. Ce mécanisme, principalement exploité jusqu’ici dans l’entraînement des dictionnaires (codebooks) de VQ-VAE, démontre une convergence tout aussi efficace sur des jeux de données statiques.
2 époques suffisent pour égaler l’erreur de 25 itérations
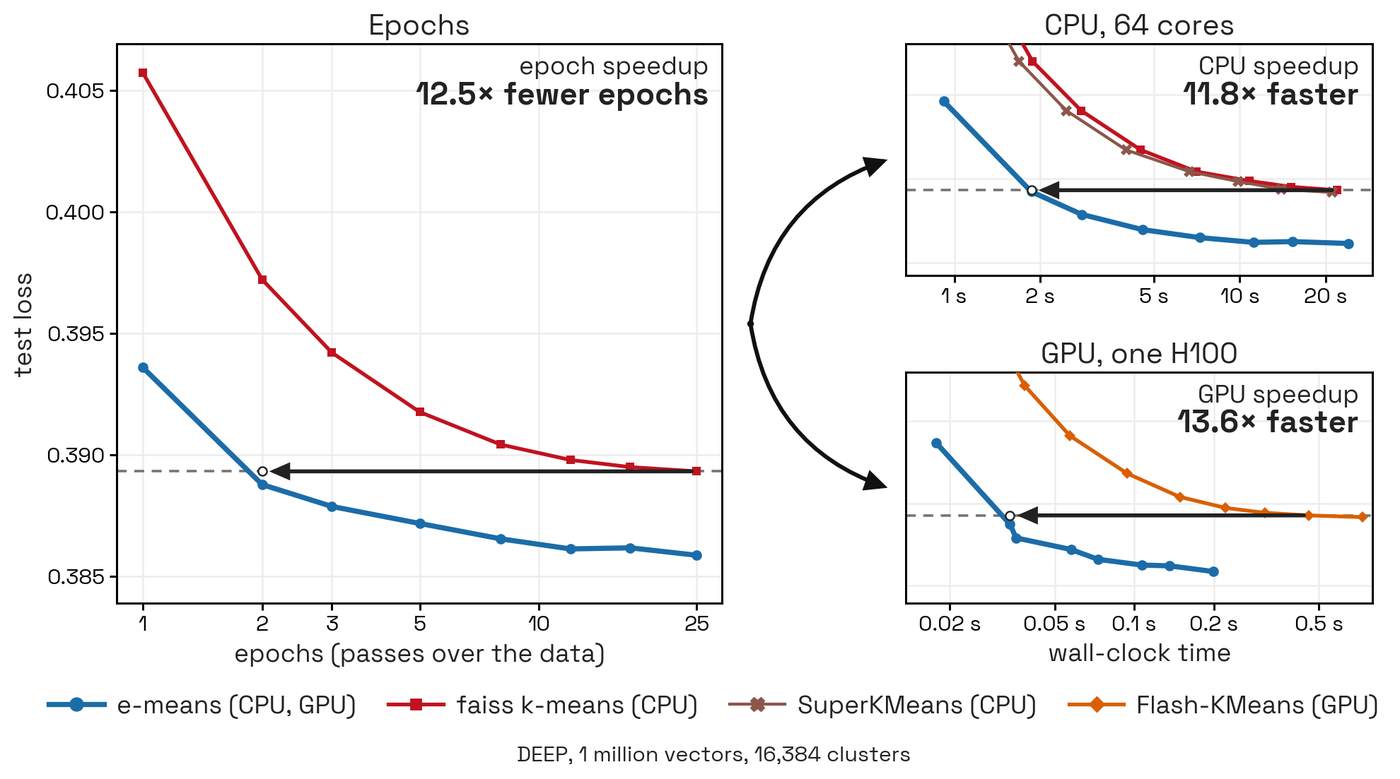 Figure : Comparaison des performances entre e-means et Lloyd selon le nombre d’époques, le temps CPU et le temps GPU. Source : page officielle du projet e-means
Sur 11 jeux de données de référence multimodaux VIBE, e-means affiche une convergence particulièrement vive. Les dimensions vectorielles évaluées s’échelonnent de 200 à 3 072, avec 8 192 et 16 384 centroïdes. Le nouvel algorithme atteint l’erreur de test produite par 25 itérations complètes de Lloyd en seulement 1,6 à 2,4 époques. Le processus de partitionnement n’exige plus des dizaines de passes exhaustives : deux traversées du jeu de données suffisent pour approcher la structure globale des données.
Auparavant, l’optimisation du clustering sacrifiait souvent la précision au profit du débit — un compromis qu’e-means fait voler en éclat. D’après les mesures effectuées sur un unique GPU NVIDIA H100 (précision bf16), le temps d’exécution est réduit d’un facteur 10 à 45 par rapport à Flash-KMeans. Sur CPU, face à l’implémentation native de Faiss, l’accélération de bout en bout atteint un facteur 8 à 15. Gain de vitesse et réduction de perte se matérialisent de concert au sein d’un même cadre algorithmique.
La diminution du nombre d’époques au niveau théorique doit s’appuyer sur des opérateurs de bas niveau pour offrir un réel gain en temps de calcul effectif. Face à une charge exigeante de 10 millions de vecteurs et 65 536 clusters, une exécution PyTorch native de Lloyd demande plus de 140 secondes, contre 14 à 22 secondes pour Flash-KMeans. e-means intègre des noyaux (kernels) fusionnés dédiés qui combinent l’assignation au plus proche centroïde et la mise à jour de la moyenne mobile en une seule passe. La consommation de bande passante mémoire est drastiquement comprimée, transformant le gain algorithmique en plusieurs dizaines de fois d’accélération concrète.
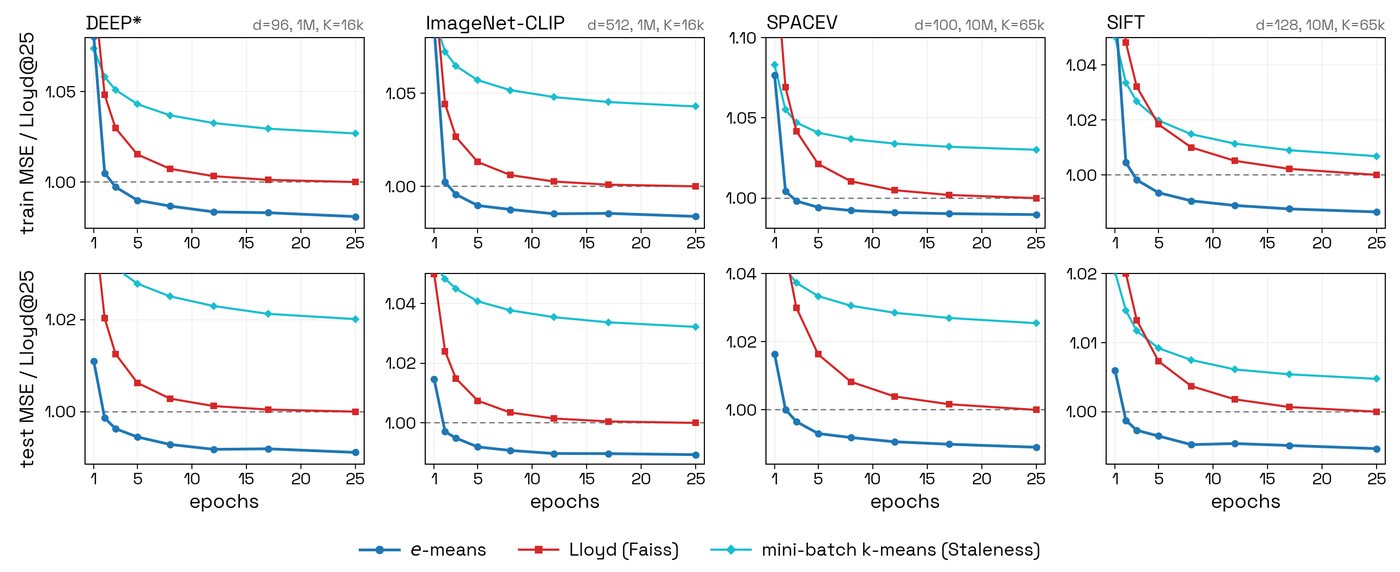 Figure : Courbes de convergence de l’erreur quadratique moyenne (MSE) en entraînement et en test par rapport à la 25e itération de Lloyd. Source : page officielle du projet e-means
L’observation des trajectoires de MSE d’entraînement et de test révèle des dynamiques très contrastées. Lloyd chute rapidement au début grâce au calcul exhaustif de la moyenne, mais stagne rapidement dans les phases intermédiaires et finales. e-means égale le niveau d’erreur de test en seulement une époque et demie, avant d’atteindre des valeurs encore plus faibles lors des tours suivants. À l’issue de l’entraînement, l’algorithme repositionne les centroïdes sur la moyenne empirique de la dernière époque, effaçant ainsi le léger décalage propre aux moyennes mobiles exponentielles.
Le bruit stochastique du mini-batch aide à échapper aux optima locaux
La fonction objectif du clustering étant non convexe, les méthodes d’optimisation déterministes s’enferment volontiers dans des impasses. Chaque pas de mise à jour dans l’algorithme de Lloyd réduit de façon strictement monotone la MSE d’entraînement. Cette décroissance monotone agit comme un piège local : dès lors qu’un centroïde glisse dans un bassin d’attraction sous-optimal, il ne peut plus en sortir. Une mauvaise configuration initiale des centres se trouve ainsi figée comme résultat définitif.
L’échantillonnage par mini-batches introduit des perturbations aléatoires qui fournissent l’énergie cinétique requise pour explorer l’espace des paramètres. Lors de 200 entraînements répétés sur des données synthétiques comportant deux groupes de tailles très inégales, Lloyd s’est retrouvé bloqué dans des extrema locaux dans 26 % des cas. Dans les mêmes conditions, e-means a réduit ce taux d’échec à 3,5 %. Dans une topologie à cinq clusters colinéaires où Lloyd échouait à 46 %, e-means a atteint un taux de blocage de 0 %.
La variance propre à l’échantillonnage par lots dispose d’une aptitude naturelle à franchir les points-selles et les barrières de potentiel étroites. Sans exiger de redémarrages heuristiques complexes, les perturbations aléatoires reconfigurent d’elles-mêmes la trajectoire des centroïdes. Véritable moteur d’exploration dans les réseaux profonds, le bruit stochastique déploie la même valeur ajoutée dans les tâches de partitionnement. En évitant les minima locaux, la qualité d’ensemble du clustering progresse de façon notable.
Afin de garantir une convergence stable en phase finale, la planification du pas d’apprentissage s’appuie sur une politique de recuit. Selon une courbe de décroissance en cosinus, le pas de mise à jour descend en douceur d’une valeur initiale $\alpha_0$ vers $0,1\alpha_0$. Des pas plus larges au départ facilitent l’exploration entre clusters, tandis que le pas réduit en fin de parcours verrouille la stabilité. Cette dynamique élimine les oscillations et concilie vaste champ d’exploration et précision du positionnement final.
Deux formules empiriques dispensent du réglage manuel des hyperparamètres
Par le passé, la difficulté majeure qui empêchait le clustering par mini-batches de remplacer Lloyd en production résidait dans le coût de réglage des hyperparamètres. Bien que Lloyd soit lent, il ne nécessite aucun paramètre en dehors du nombre de clusters et du nombre d’itérations. Le mécanisme des mini-batches impose en revanche de choisir la taille de lot et le taux d’apprentissage. Le temps et la puissance de calcul consacrés aux recherches sur grille (grid search) effaçaient souvent les gains obtenus lors des exécutions individuelles.
En s’inspirant des lois d’échelle (scaling laws) issues de l’apprentissage profond, e-means résout l’épineux problème de l’auto-adaptation. Les auteurs ont établi deux formules empiriques déduisant les hyperparamètres optimaux à partir du nombre d’échantillons $n$, du nombre de clusters $k$ et du budget de calcul $T$. Ces formules prédisent directement la taille de lot $B$ et le pas initial $\alpha_0$. Sur des jeux de test distincts, le coefficient de détermination ($R^2$) de ces deux équations atteint respectivement 0,96 et 0,95.
L’efficacité pratique de ces hyperparamètres automatisés a été confirmée sur de nombreux bancs d’essai. Comparé à une recherche exhaustive sur grille, le déficit médian de performance (regret) lié à ces formules n’est que de 0,06 % à 0,20 %. Les ingénieurs n’ont plus à investir de temps dans des ajustements par tâtonnement : l’algorithme sélectionne de manière autonome sa trajectoire de convergence optimale. Cette capacité d’adaptation sans recherche d’hyperparamètres abaisse considérablement la barrière du déploiement industriel.
Pour les applications de quantification nécessitant une fidélité extrême, l’équipe propose également une variante de formule axée sur la qualité. Ce profil tempère légèrement le rythme des mises à jour, échangeant une petite fraction de débit contre une MSE encore plus faible. Dans la construction d’index vectoriels à très grande échelle, ces gains minimes sur la perte améliorent directement le taux de rappel (recall). Les équipes d’ingénierie peuvent ainsi alterner entre les modes en fonction de leur budget de calcul et de leurs exigences de précision.
La scission proportionnelle ranime des milliers de centres inactifs
En environnement de production, le clustering par mini-batches se heurte à une autre anomalie récurrente : les clusters morts provoqués par l’inanition de certains centres. Lorsqu’un centroïde ne reçoit aucun échantillon lors d’un lot donné, ses statistiques tombent à zéro et sa mise à jour s’interrompt. Dans des dictionnaires à haute cardinalité ($k \ge 16384$), ces clusters morts amputent drastiquement la capacité utile. De nombreux centres vacants dégradent la résolution de quantification et gaspillent les ressources de calcul.
Le modèle de compression audio EnCodec réagit à ce problème en tirant au sort des échantillons dans le lot courant pour combler les vides. Toutefois, ce réapprovisionnement aléatoire manque de fondement topologique et les centroïdes réinjectés ont tendance à se retrouver rapidement isolés. e-means met à profit le savoir-faire acquis sur Faiss en adoptant un échantillonnage des grands clusters proportionnel à leur taille, avant de les scinder en deux. L’algorithme réoriente la puissance disponible vers les zones de données les plus denses, épousant ainsi la variété des données.
Les tests d’ablation sur le jeu de données DEEP démontrent l’écart considérable entre les stratégies de réanimation. Sur un entraînement de 5 époques portant sur 1 million de vecteurs et 16 384 centres, la désactivation du mécanisme génère 4 313 clusters morts (26,3 % du total) pour une MSE de test de 0,39448. Le rééchantillonnage aléatoire inspiré d’EnCodec laisse encore 2 343 clusters inactifs pour une MSE de 0,39124. En revanche, la scission proportionnelle comprime le nombre de centres morts à seulement 47 (0,3 %), faisant descendre la MSE de test à 0,38762.
La même tendance se confirme sur le banc d’essai SIFT, où la stratégie de scission fait passer le nombre de clusters morts de 2 080 à 10. Dans les pipelines de quantification vectorielle et de codage audio, un dictionnaire pleinement exploité conditionne la fidélité du signal. En réactivant les clusters dormants, la bande passante de calcul inactive se convertit directement en gain de résolution.
e-means fait tomber les cloisons qui séparaient le clustering classique des techniques d’optimisation en deep learning. En associant moyennes mobiles, recuit en cosinus et résurrection par scission dans une architecture cohérente, il dépasse sept décennies d’inertie algorithmique en un nombre d’époques dérisoire. En réunissant vitesse de convergence et qualité de partitionnement, l’optimisation par mini-batches ouvre un nouveau chapitre pour les infrastructures de quantification vectorielle à grande échelle.
Liens de référence :
- Page du projet e-means et démonstration interactive
- Article arXiv : e-means: k-means is fast and accurate with modern optimization
- Module du dépôt open-source Faiss : contrib/e_means
- Discussion technique sur Hacker News