Ende 2026 stieg die Commit-Frequenz im zentralen Monorepo von OpenAI im Vergleich zu vor zwei Jahren um 2.442 % an. Der produktive Einsatz von Codex revolutionierte den Entwicklungstakt grundlegend: Ein einzelner Ingenieur trieb zeitgleich dutzende Feature-Branches voran. Die Verfügbarkeit der alten Server-Infrastruktur sank zeitweise unter 90 %.
Am 2. November 2026 stellte OpenAI sein selbst entwickeltes Git-Server-Backend namens Pando vor. Das neue System bewältigt täglich ein Datenvolumen von knapp 1 PB und senkt die mediane Push-Latenz um rund 80 %. Um diese gewaltige Flut paralleler Agenten-Aufrufe abzufangen, mussten zwei Grundannahmen über Bord geworfen werden, die das serverseitige Git seit zwei Jahrzehnten dominiert hatten.
In der Praxis wird der Engpass bei der Versionskontrolle meist auf die Client-Architektur oder die schiere Größe von Monorepos geschoben. Pando beweist jedoch, dass die tatsächliche Leistungsgrenze in der vom Server erzwungenen globalen Konsistenz und dem dynamischen Packen liegt. Sobald autonome Software-Agenten die Frequenz von Code-Commits um eine Größenordnung steigern, müssen die architektonischen Grundlagen des Servers neu gedacht werden.
Ver-24-fachung der Commits bringt alte Cluster zum Einsturz
Das Wachstum des Commit-Aufkommens sprengte alle bisherigen Prognosen. Frühe interne Modelle hatten für Ende 2026 einen Anstieg um 1.378 % erwartet; die Realität lag bei 2.442 %. Autonome Agenten übernahmen das Schreiben von Code und Tests, sodass einzelne Entwickler dichte Serien von Pull Requests generierten.
Jeder Push löste im Hintergrund hunderte Build-Container aus. Tausende Jobs fragten exakt in derselben Sekunde den neuesten Stand ab, was die Schnittstellen unter massiven Lastspitzen kollabieren ließ. Ende 2025 gehörten Warteschlangen bei Push-Vorgängen, fehlgeschlagene Merges und Fetch-Timeouts zum Alltag.
Das Absinken der Systemverfügbarkeit unter 90 % deckte die physikalischen Grenzen zentralisierter Server-Cluster schonungslos auf. Mit der flächendeckenden Automatisierung wurde die Commit-Rate direkt von den Datenstürmen paralleler KI-Agenten bestimmt. Die überholte Architektur konnte die exponentiell wachsenden Codeänderungen nicht mehr tragen – ein radikaler Neuentwurf war unausweichlich.
Traditionelle verteilte Ansätze scheitern an seriellen Sperren
Bei hoher Nebenläufigkeit greift die Industrie üblicherweise auf eine Drei-Phasen-Commit-Replikation (3PC) zurück. Jeder Replikationsknoten hält eine vollständige Kopie des Repositories vor, und Packfiles müssen auf einer Mehrheit der Knoten persistiert sein, bevor Referenzen aktualisiert werden dürfen. Netzwerkverzögerungen und Schreibgeschwindigkeiten landen direkt auf dem kritischen Pfad und zwingen Branch-Aktualisierungen in eine rein serielle Abarbeitung.
Ein alternativer Weg setzt auf geteilten Objektspeicher und Write-Ahead-Logs (WAL). Pushes können zwar Packfiles parallel hochladen, konkurrieren jedoch über Compare-and-Swap (CAS) um die Schreibrechte für das Manifest. Die CAS-Netzwerkrunden setzen dem Durchsatz repo-weiter Schreibvorgänge harte Grenzen, während lesende Replikate beim Nachführen der Indizes leicht ins Hintertreffen geraten.
Beide Architekturen kranken am selben Problem: dem Versuch, repo-weit eine global konsistente Momentaufnahme aufrechtzuerhalten. Obwohl Agenten weitgehend auf isolierten Feature-Branches arbeiten, blockieren sich voneinander unabhängige Änderungen gegenseitig durch globale Sperren. Solange ein Monorepo auf globaler Snapshot-Isolation beharrt, bleibt der Schreibdurchsatz an einer zentralen Koordinationsstelle gedeckelt.
Verzicht auf globale Konsistenz zugunsten paralleler Schreibvorgänge
Pando brach radikal mit den traditionellen Paradigmen. Das System verabschiedete sich von der repository-weiten starken Konsistenz und begrenzte den Konsistenzbereich streng auf die Referenz des einzelnen Branches. Voneinander unabhängige Branch-Aktualisierungen bleiben auf Metadatenebene vollständig entkoppelt, wodurch die Lese- und Schreibkomplexität im Schreibpfad auf O(1) sinkt.
Vom Client erzeugte Packfiles werden als unveränderliche Datenblöcke direkt in den Objektspeicher geschrieben. Der Server hängt im Metadatenspeicher lediglich eine schlanke Referenzversion (Ref-Version) an, die den neuen Commit mit den abhängigen Vorgängerversionen verknüpft. Beim Fetching müssen Clients nur diese Versionskette zurückverfolgen, wodurch der Metadaten-Overhead bei O(log Δ) bleibt.
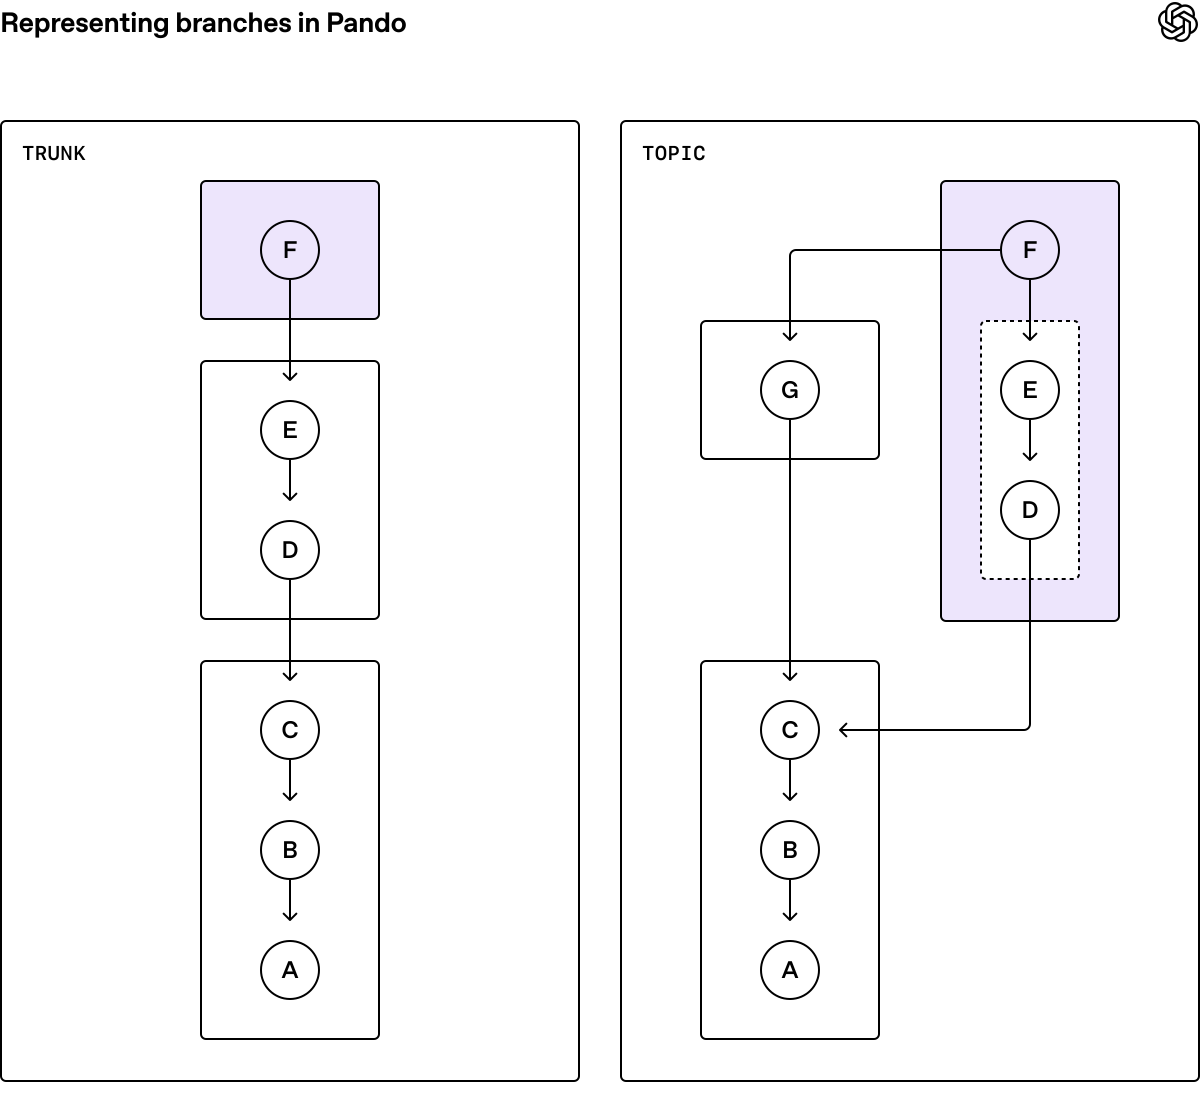 Grafik: Pando Ref-Versionen und Packfile-Abhängigkeiten. Trunk und Topic-Branch verzweigen sich bei Commit C; der Topic-Branch hängt von Commit G des Trunks ab. Quelle: OpenAI Engineering Blog, „Scaling Git at OpenAI“
Dieser architektonische Wechsel brachte sofortige Leistungssteigerungen beim Schreiben. Wenn Clients mehrere Branches parallel abfragen, wird nicht mehr vorausgesetzt, dass diese aus exakt demselben Moment stammen. Reale Workflows erfordern ohnehin nur die kausale Entwicklung entlang eines bestimmten Branches. Indem globale Konsistenz durch kausale Konsistenz ersetzt wurde, konnten sich unzählige parallele Branches aus der Blockade globaler Sperren befreien.
Direkte Cache-Auslieferung und Skip-Lists gegen Server-Last
Historisch gesehen entstand die größte Serverlast beim Erstellen von Paketen während des Fetch-Vorgangs. Bei jedem Pull durchlief der Server den Objektgraphen, berechnete Differenzen und komprimierte Objekte in Echtzeit. Pando eliminiert diesen maßgeschneiderten Pack-Mechanismus vollständig und liefert stattdessen direkt die beim Push gespeicherten unveränderlichen Original-Packfiles aus. Der Server wird so zu einem reinen Dateiverteilungsknoten und verbraucht kaum noch CPU-Ressourcen.
In einem riesigen Monorepo mit Millionen Branches kann allein das Annoncieren aller Referenzen eine Antwortgröße von über 100 MiB erreichen. Pando annonciert standardmäßig nur definierte Trunk-Branches; Clients erstellen ihre Änderungen ausschließlich relativ zum Verlauf dieser Haupt-Branches. Dadurch liegt die mediane Größe von Push-Packfiles unter 20 KiB, und selbst das 99. Perzentil bleibt unter 3 MiB.
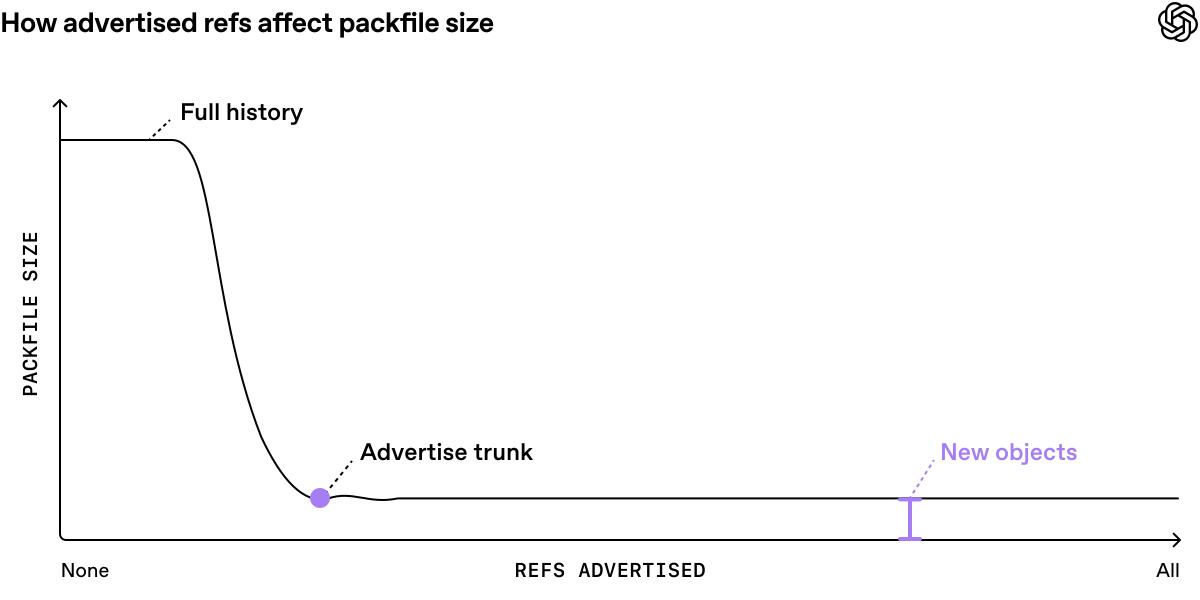 Grafik: Verhältnis zwischen annoncierten Refs und Packfile-Größe. Die Beschränkung auf Trunk-Branches reduziert das Übertragungsvolumen drastisch und schont Bandbreite sowie Server-Ressourcen. Quelle: OpenAI Engineering Blog, „Scaling Git at OpenAI“
Um statische Packfiles mit maximaler Leitungsgeschwindigkeit auszuliefern, bindet das System das Git-Feature packfile-uri tief ein. Die eigentliche Protokollantwort liefert nur eine minimale Hülle, während die massiven Binärdaten über lokale regionale Express-Edge-Caches verteilt werden. Bei einer Cache-Trefferquote von über 99 % lastet das System eine 10-Gbps-Netzwerkkarte mit nur wenigen CPU-Kernen problemlos aus.
Da häufige kleine Pushes viele winzige Dateien erzeugen, setzt Pando auf eine mehrstufige Verdichtung, inspiriert von Log-Structured Merge-Trees (LSM). Pushes erzeugen L0-Basispakete, die Hintergrundprozesse regelmäßig zu größeren Paketen zusammenfassen. Diese hierarchischen Pakete fungieren als Skip-List: Sie steigern die Kompressionsrate und ermöglichen die Fetch-Planung in logarithmischer Zeit.
Formale Verifikation und architektonische Kompromisse
Von der ersten Konzeption bis zum produktiven Einsatz vergingen lediglich 10 Wochen. Ein einzelner Entwickler entwarf die Kernarchitektur, ein Verbund autonomer Agenten übernahm die Implementierung, und ein kleines Team steuerte das Deployment. Seit April 2026 wickelt dieses in Rust geschriebene System ohne Altlasten den gesamten Produktivverkehr ab.
Um sicherzustellen, dass agentengenerierter Code auch in komplexen Randbereichen fehlerfrei arbeitet, baute das Team eine lückenlose Testsuite auf, die jedes Detail mit dem Standardverhalten von Git abgleicht. Mittels GPT-6 Astra wurden formale Spezifikationen in Lean und TLA+ verfasst, um die Sicherheitsmerkmale des Systems mathematisch zu beweisen. Agenten liefen über hunderte Stunden in Dauerschleifen zur Erkennung von Race Conditions, ergänzt durch Red-Teaming mit Modellen auf Daybreak-Niveau.
Die enormen Durchsatzgewinne erforderten bewusste Kompromisse. Die Wiederverwendung von Packfiles führt dazu, dass Clients vereinzelt bereits vorhandene Objekte außerhalb der Trunk-Baseline erneut herunterladen. Auch die Abkehr vom globalen Snapshot verlangt Anpassungen bei älteren Analysetools, die auf eine einheitliche Gesamtsicht angewiesen sind. Gutes Engineering basiert auf klaren Abwägungen: Wenn paralleler Schreibdurchsatz zur Überlebensfrage wird, ist ein begrenzter Speicher-Overhead ein vollkommen vertretbarer Preis.
Das grundlegende DAG-Objektmodell von Git hat sich erneut als extrem robust erwiesen. Die früheren Leistungsgrenzen lagen nicht im Datenmodell, sondern in den zentralisierten Annahmen klassischer Server. Da autonome Agenten die Frequenz von Code-Commits vervielfachen, transformiert sich das Versionskontrollsystem in eine hochgradig skalierbare, kausal konsistente Daten-Pipeline. Die Zukunft moderner Entwicklungs-Infrastruktur liegt in Systemen, die das kontinuierliche Zusammenspiel von Mensch und Maschine reibungslos ermöglichen.
Weiterführende Links:
- OpenAI Engineering Blog: „Scaling Git at OpenAI“