Fin 2026, la fréquence des commits dans le monorepo central d’OpenAI a bondi de 2442 % par rapport à deux ans auparavant. L’intégration de Codex dans le quotidien des développeurs a métamorphosé la cadence de production logicielle, permettant à un seul ingénieur de mener de front plusieurs dizaines de branches de modifications. À certains moments critiques, la disponibilité des serveurs historiques est passée sous la barre des 90 %.
Le 2 novembre 2026, OpenAI a levé le voile sur Pando, son backend de serveur Git développé en interne. Ce nouveau système absorbe près de 1 Po de données par jour et réduit la latence médiane des push de près de 80 %. Pour soutenir cette vague colossale de requêtes d’agents simultanés, l’équipe a dû balayer deux postulats architecturaux qui régissaient les serveurs Git depuis vingt ans.
On impute souvent les goulots d’étranglement de la gestion de versions aux spécificités du client ou au gigantisme des monorepos. Pando démontre au contraire que le plafond de performance provenait de la cohérence forte à l’échelle du dépôt et de l’empaquetage à la volée imposés par le serveur. Quand des armées d’agents décuplent la densité des commits, les fondations mêmes de l’architecture serveur doivent être repensées.
Une explosion des commits par un facteur 24 qui submerge l’infrastructure historique
La déferlante des commits a pris de court les prévisions de l’équipe. Les premiers modèles prévoyaient une hausse de 1378 % pour fin 2026 ; la réalité a culminé à 2442 %. Les agents autonomes ayant pris en charge la rédaction et les tests de code, un ingénieur isolé pouvait désormais générer un flot ininterrompu de pull requests.
Chaque push déclenchait en coulisses des centaines de conteneurs d’intégration continue. Des milliers de jobs réclamaient le dernier commit à la même seconde, provoquant des pics d’accès qui asphyxiaient les interfaces réseau. Fin 2025, l’ancien serveur enchaînait files d’attente interminables, échecs de fusion et dépassements de délai lors des fetch.
La chute de la disponibilité sous 90 % a mis en lumière la limite absolue des architectures centralisées. Sous l’effet des pipelines d’automatisation, la cadence des commits est devenue directement tributaire des tempêtes de données levées par les agents concurrents. Le modèle de collaboration d’hier ne pouvait plus absorber un tel foisonnement de code : une refonte intégrale s’imposait.
Les approches distribuées classiques s’enlisent dans les verrous séquentiels
Pour gérer une forte concurrence, l’industrie mise traditionnellement sur la réplication par validation à trois phases (3PC). Chaque réplica conserve une copie intégrale du dépôt, et les packfiles doivent être enregistrés sur une majorité de réplicas avant toute mise à jour de référence. La latence réseau et les performances d’écriture sur disque se retrouvent directement sur le chemin critique, condamnant les mises à jour de branches à un défilement strictement séquentiel.
Une autre piste s’appuie sur le stockage d’objets partagé combiné à des journaux d’écriture anticipée (WAL). Si les push peuvent téléverser des packfiles en parallèle, l’actualisation du manifeste reste soumise à une compétition féroce par Compare-And-Swap (CAS). Le délai d’aller-retour réseau imposé par le CAS fixe un plafond infranchissable aux écritures globales, tandis que les réplicas de lecture peinent constamment à rattraper l’indexation.
Ces deux approches partagent le même écueil fondamental : vouloir préserver un instantané global cohérent sous une horloge universelle. Les agents travaillent pourtant sur des branches thématiques isolées, mais des modifications parfaitement indépendantes finissaient par se paralyser mutuellement sous des verrous globaux. Tant qu’un monorepo s’obstinera à garantir une isolation par instantané global, son débit d’écriture demeurera bridé par un mécanisme de coordination unique.
Renoncer à la cohérence forte au profit d’écritures hautement parallèles
Pando a choisi de renverser les postulats historiques à la racine. Le système a renoncé à la cohérence forte au niveau du dépôt complet pour restreindre son périmètre à chaque référence de branche individuelle. Les mises à jour de branches sans lien restent strictement cloisonnées au niveau des métadonnées, ce qui réduit la complexité de lecture et d’écriture sur le chemin d’enregistrement à O(1).
Les packfiles générés par les clients lors des push sont écrits directement dans le stockage d’objets en tant que blocs de données immuables. Le serveur se contente d’ajouter une version de référence (ref version) légère dans son magasin de métadonnées, reliant le nouveau commit aux versions antérieures dont il dépend. Lors d’un fetch, le client n’a plus qu’à remonter cette chaîne de versions, maintenant le coût de parcours des métadonnées à O(log Δ).
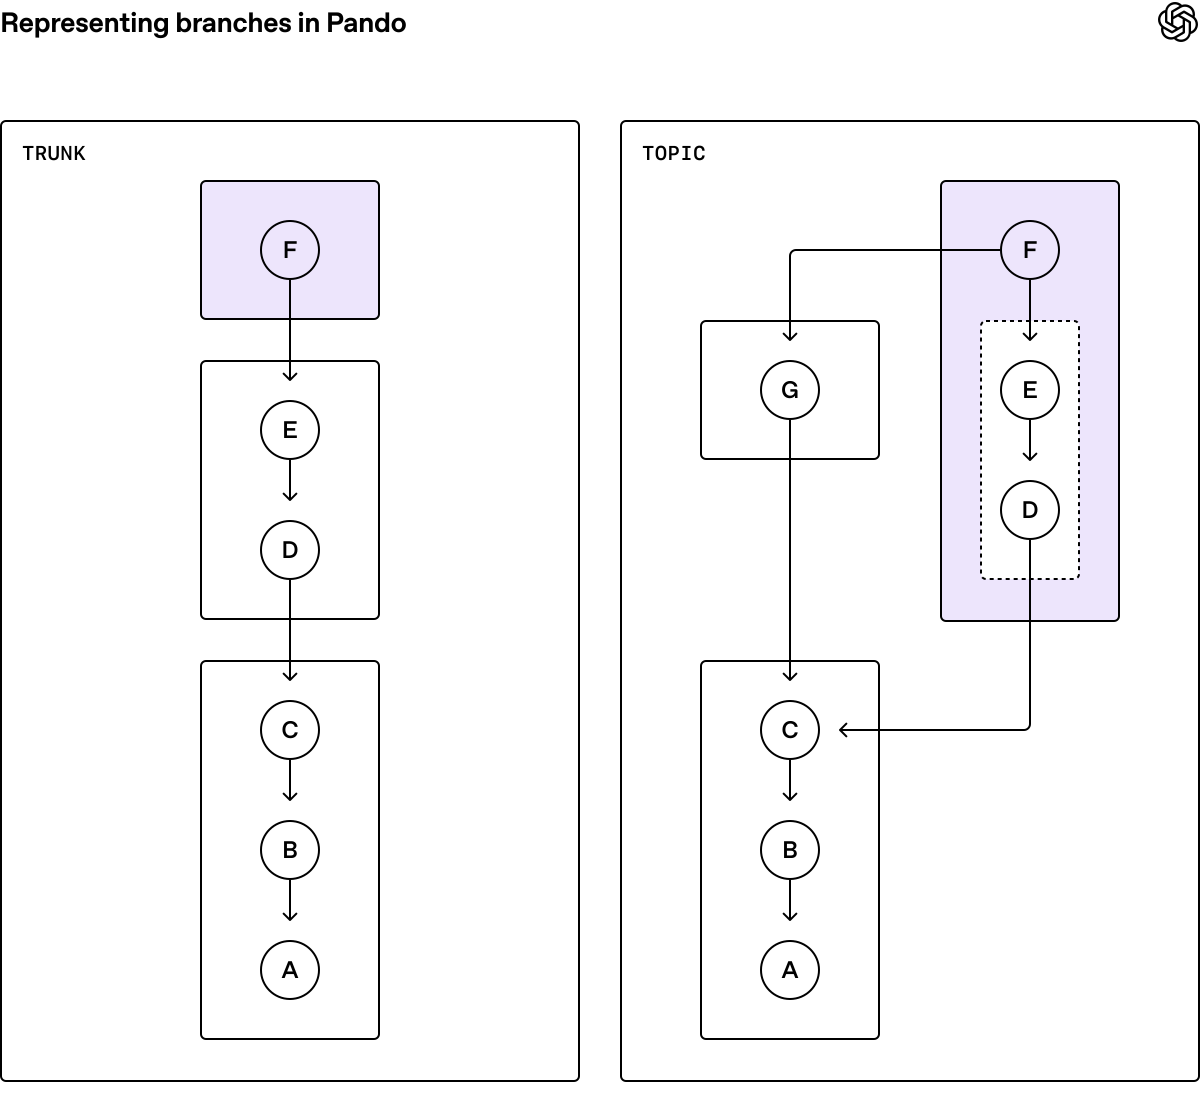 Schéma : Versions de ref et dépendances de packfiles dans Pando. Le tronc et la branche secondaire divergent au commit C ; la branche dépend du commit G du tronc. Source : Blog d’ingénierie d’OpenAI, « Scaling Git at OpenAI »
Cette rupture architecturale a immédiatement débloqué le débit d’écriture. Lorsqu’un client lit plusieurs branches simultanément, il ne présume plus qu’elles soient figées au même instant exact. Dans les faits, le flux de travail réel n’a besoin que de suivre l’évolution causale d’une branche précise. En substituant la cohérence causale à la cohérence globale forte, des millions de branches concurrentes se sont affranchies du joug des verrous globaux.
Zéro consommation CPU grâce au cache direct et aux skip lists
Par le passé, la charge de calcul la plus écrasante d’un serveur Git provenait de la génération de paquets lors des fetch. À chaque requête client, le serveur parcourait le graphe d’objets pour calculer les deltas et compresser les données en temps réel. Pando élimine purement et simplement ce mécanisme d’empaquetage dynamique pour réutiliser directement les packfiles d’origine stockés lors du push. Le serveur se métamorphose en un pur point de distribution de fichiers statiques, ne consommant pratiquement aucun cycle CPU.
Dans un monorepo hébergeant des millions de branches, annoncer l’intégralité des références disponibles (advertised refs) génère une charge initiale de plus de 100 Mo. Pando annonce par défaut uniquement les branches maîtresses (trunk), obligeant le client à élaborer ses paquets de modifications uniquement par rapport à l’historique du tronc. Grâce à cette stratégie, la taille médiane des packfiles envoyés lors d’un push tombe sous les 20 Ko, et le 99e centile reste sous la barre des 3 Mo.
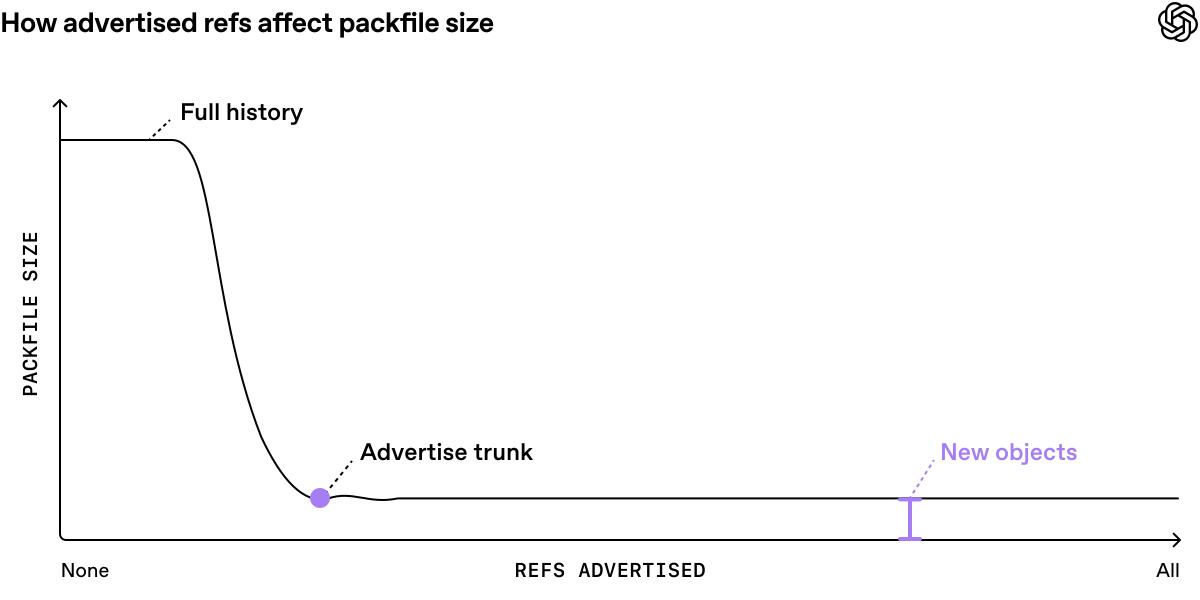 Schéma : Relation entre nombre de références annoncées et taille du packfile. N’annoncer que le tronc réduit drastiquement le volume de données transféré, conciliant bande passante réseau et efficacité de réutilisation du serveur. Source : Blog d’ingénierie d’OpenAI, « Scaling Git at OpenAI »
Afin de distribuer ces paquets statiques à la vitesse maximale du réseau, Pando exploite en profondeur la directive packfile-uri. La réponse standard du protocole Git ne renvoie qu’une enveloppe vide, déléguant le transit des données binaires volumineuses à des caches périphériques régionaux Express. Avec un taux de succès de cache sur disque supérieur à 99 %, l’infrastructure sature une bande passante de 10 Gbps avec seulement une poignée de cœurs CPU.
Les push fréquents générant une multitude de petits fichiers, Pando introduit un mécanisme de compactage étagé inspiré des arbres LSM (Log-Structured Merge). Les push génèrent des paquets de base L0, que des tâches d’arrière-plan fusionnent périodiquement en ensembles couvrant des intervalles plus larges. Ces paquets hiérarchiques agissent comme une skip list, maximisant le taux de compression tout en permettant une planification des fetch en temps logarithmique.
Vérification formelle et compromis d’ingénierie
Cette nouvelle infrastructure est passée de la table à dessin à la production en seulement 10 semaines. L’architecture centrale a été conçue par un seul ingénieur, une équipe d’agents autonomes a pris en charge l’implémentation du code et une équipe réduite a orchestré le déploiement. En avril 2026, cette solution écrite en Rust, sans aucune dette technique héritée, prenait en charge 100 % du trafic de production.
Pour s’assurer que le code produit par les agents ne flanche pas sur les cas limites, l’équipe a bâti une suite complète de tests de conformité alignée point par point sur le comportement canonique de Git. GPT-6 Astra a rédigé des spécifications formelles en Lean et TLA+ afin de prouver mathématiquement les propriétés d’invariance du système. Des agents ont tourné en boucle pendant des centaines d’heures pour débusquer d’éventuelles conditions de course, complétés par des campagnes de red teaming orchestrées par des modèles de classe Daybreak.
Atteindre un débit aussi phénoménal a exigé d’assumer lucidement des contreparties. Réutiliser des packfiles immuables signifie que les clients peuvent occasionnellement télécharger des objets qu’ils possèdent déjà en dehors du tronc. De même, l’abandon d’une horloge universelle a nécessité d’adapter les anciens outils d’analyse qui dépendaient d’un instantané exhaustif du dépôt. L’essence même de l’ingénierie réside dans l’art du compromis : dès lors que le parallélisme d’écriture devient une condition vitale, une redondance de stockage localisée constitue un prix tout à fait raisonnable.
Le modèle de données d’objets en graphe orienté acyclique (DAG) de Git demeure plus robuste que jamais. Les limitations de performance historiques ne provenaient pas du modèle lui-même, mais des hypothèses centralisées plaquées sur les serveurs. Avec l’avènement des agents autonomes qui démultiplient la cadence des commits, le système de gestion de versions se transmute en un pipeline de données fluide à cohérence causale. L’infrastructure logicielle de demain est désormais pensée pour accompagner, sans friction, la collaboration continue entre l’homme et la machine.
Références :
- Blog d’ingénierie d’OpenAI, « Scaling Git at OpenAI »