2026년 말, OpenAI 모노레포의 커밋 빈도는 2년 전에 비해 2442% 급증했다. 일상 개발 업무에 도입된 Codex가 코드 생산 흐름을 완전히 바꾸어 놓으면서, 개발자 한 명이 동시에 수십 개의 변경 브랜치를 운영하게 되었다. 기존 레거시 서버의 가용성은 한때 90% 아래로 떨어졌다.
2026년 11월 2일, OpenAI는 자체 개발한 Git 서버 백엔드인 Pando를 공개했다. 새 시스템은 하루에 약 1PB의 데이터를 처리하며, 푸시 지연 시간 중앙값을 80%가량 낮췄다. 급증한 동시성 에이전트 트래픽을 감당할 수 있었던 비결은 20년간 이어져 온 서버 측의 기본 가정 두 가지를 뒤엎은 데 있었다.
업계에서는 버전 관리의 병목 현상을 주로 클라이언트 구조나 모노레포의 방대한 규모 탓으로 돌리곤 한다. 하지만 Pando는 실제 성능 한계가 서버가 고집해 온 리포지토리 전체의 강한 일관성과 실시간 맞춤 패킹에서 비롯되었음을 증명했다. 동시 실행되는 에이전트들이 커밋 밀도를 한 단계 끌어올린 시점에서, 서버 아키텍처의 설계 가정은 근본적으로 재구성되어야 했다.
커밋 24배 폭증이 무너뜨린 기존 인프라
코드 커밋의 증가세는 엔지니어링 팀의 예측 한계를 뛰어넘었다. OpenAI의 초기 예측 모델은 2026년 말 증가율을 1378%로 보았으나 실제 증가율은 2442%에 달했다. 자율 에이전트가 코드 작성과 테스트를 주도하면서 단 한 명의 엔지니어도 밀도 높은 풀 리퀘스트를 연이어 쏟아낼 수 있게 되었다.
코드가 푸시될 때마다 백엔드에서는 수많은 빌드 컨테이너가 일제히 깨어났다. 수백, 수천 개의 작업이 동일한 순간에 최신 커밋을 요청하면서 트래픽 급증으로 인해 인터페이스가 수시로 마비되었다. 2025년 말에 이르러 기존 서버는 푸시 대기열 정체, 병합 실패, 패치 타임아웃을 끊임없이 겪었다.
서버 가용성이 90% 밑으로 떨어진 사태는 중앙 집중식 클러스터의 처리 한계를 여실히 드러냈다. 자동화 파이프라인이 보편화된 환경에서 코드 커밋 유입은 동시 실행 에이전트들이 일으키는 거대한 데이터 폭풍에 직결되었다. 구형 협업 아키텍처로는 눈덩이처럼 불어나는 코드 변경을 감당할 수 없었고, 시스템 전면 개편은 피할 수 없는 수순이었다.
직렬 잠금의 덫에 걸려 넘어진 분산 솔루션들
높은 동시성에 대응하기 위해 업계는 일반적으로 3단계 커밋(3PC) 복제를 선택해 왔다. 각 복제본이 전체 리포지토리를 온전히 보관하며, 팩파일이 과반수 복제본에 영구 저장된 뒤에야 브랜치 참조(ref)를 업데이트할 수 있다. 통신 지연 시간과 복제본 디스크 쓰기 속도가 임계 경로에 놓이면서 브랜치 참조 업데이트는 철저히 직렬로 처리될 수밖에 없다.
또 다른 대안은 공유 객체 스토리지와 미리 쓰기 로그(WAL)를 결합하는 방식이다. 푸시 시 팩파일 업로드는 병렬로 처리할 수 있지만, 매니페스트 수정 권한을 얻기 위해 여전히 CAS(Compare-And-Swap) 경쟁을 거쳐야 한다. CAS 네트워크 왕복 시간은 리포지토리 전체의 쓰기 처리량에 상한선을 긋고, 인덱스를 따라가는 읽기 전용 복제본 역시 쉽게 뒤처지곤 했다.
두 방식 모두 리포지토리 전체에서 일관된 단일 시점 스냅샷을 유지하려 했다는 공통된 문제를 안고 있었다. 에이전트들은 대부분 격리된 토픽 브랜치에서 작업하는데도, 전혀 상관없는 브랜치 변경 작업들이 글로벌 락 때문에 서로 발목을 잡았다. 리포지토리 전체의 스냅샷 격리를 고수하는 한, 모노레포의 쓰기 처리량은 단일 조정 메커니즘에 영원히 묶일 수밖에 없다.
강한 일관성과 동적 패킹을 포기하고 얻은 쓰기 병렬성
Pando는 기존 서버의 설계를 원점에서 다시 짚었다. 시스템은 리포지토리 단위의 강한 일관성을 포기하고 일관성의 범위를 개별 브랜치 참조 수준으로 좁혔다. 서로 무관한 브랜치 업데이트는 메타데이터 레이어에서 완전히 독립적으로 유지되며, 쓰기 경로에서의 메타데이터 읽기 및 쓰기 복잡도는 O(1) 수준으로 줄어들었다.
클라이언트 푸시로 생성된 팩파일은 불변 데이터 블록 형태로 객체 스토리지에 직접 기록된다. 서버는 메타데이터 저장소에 가벼운 참조 버전(ref version)만 덧붙여 새 커밋과 그것이 의존하는 이전 버전들을 연결한다. 클라이언트가 패치할 때는 버전 체인만 거슬러 올라가면 되므로 메타데이터 읽기 비용은 O(log Δ) 수준으로 안정화된다.
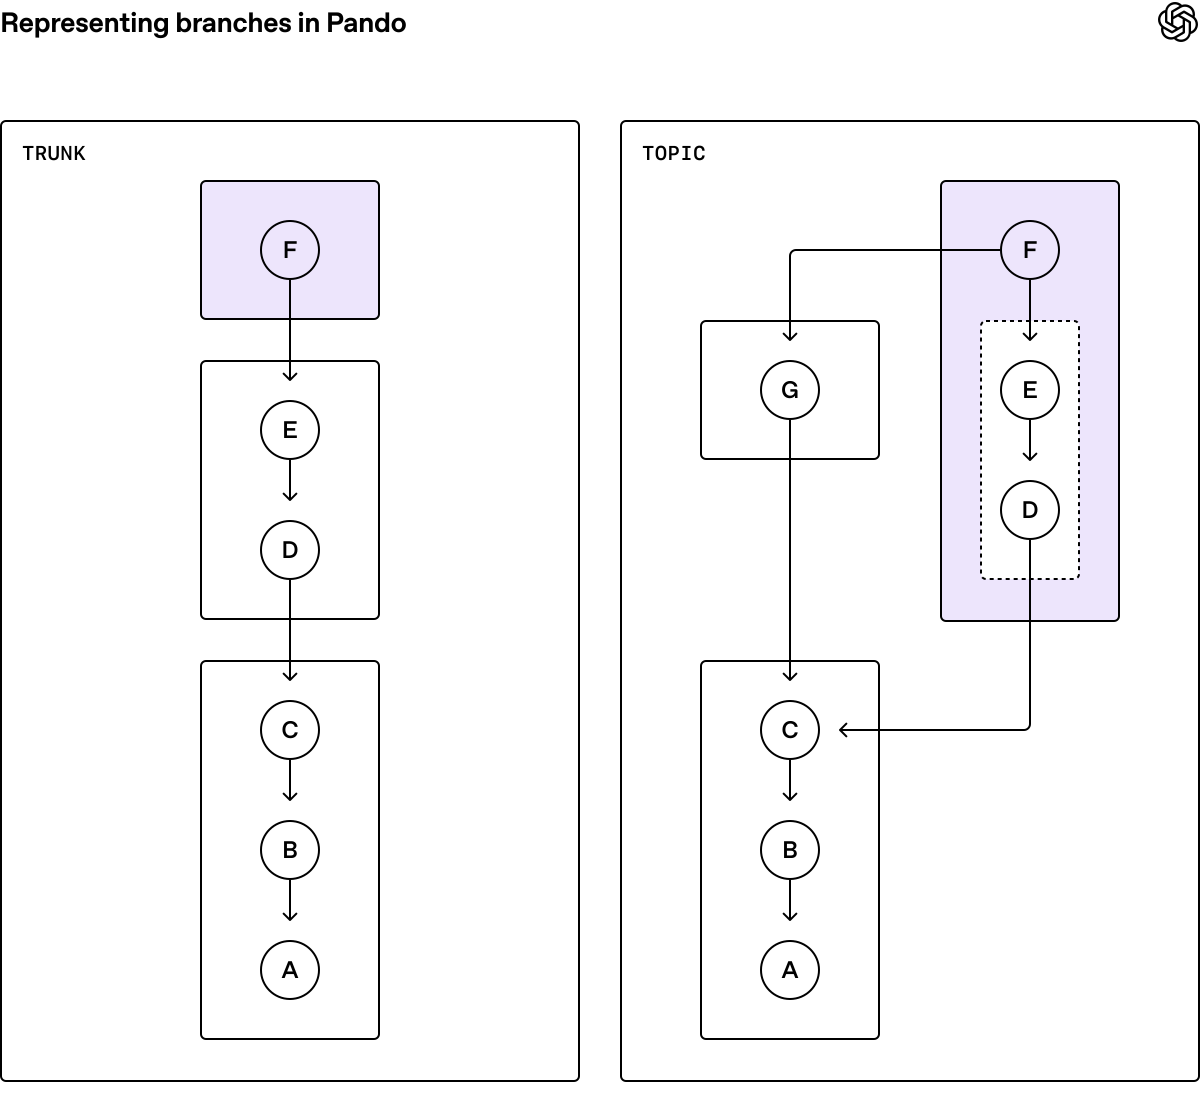 그림: Pando의 ref version 및 팩파일 의존 관계. trunk와 topic 브랜치는 커밋 C에서 분기하며, topic은 trunk의 커밋 G에 의존한다. 출처: OpenAI 엔지니어링 블로그 “Scaling Git at OpenAI”
이러한 구조적 전환은 쓰기 성능의 즉각적인 향상을 가져왔다. 클라이언트가 여러 브랜치를 동시에 읽을 때 이들이 완전히 동일한 시점의 상태일 것이라고 전제하지 않는다. 실제 개발 워크플로는 특정 브랜치가 거쳐 온 인과적 흐름에만 집중하면 충분하다. 전체 강한 일관성을 인과적 일관성으로 대체함으로써, 수많은 병렬 브랜치가 마침내 글로벌 락의 굴레에서 벗어났다.
캐시 직접 전달과 스킵 리스트 압축으로 서버 부담 제거
기존 Git 서버에서 가장 무거운 부하는 패치 시 발생하는 팩 파일 생성 작업이었다. 클라이언트가 가져오기를 요청할 때마다 서버는 객체 그래프를 탐색해 차이점을 계산하고 실시간으로 압축을 수행한다. Pando는 이러한 맞춤형 패킹 메커니즘을 전면 폐지하고, 푸시 시점에 저장된 원본 팩파일을 그대로 다운로드에 재사용한다. 서버는 순수한 파일 배포 노드로 전환되어 CPU 자원을 거의 소모하지 않는다.
수백만 개 브랜치가 존재하는 대규모 모노레포에서는 브랜치 참조 목록(advertised refs)을 전송하는 것만으로도 응답 페이로드가 100 MiB를 훌쩍 넘긴다. Pando는 기본적으로 지정된 메인 트렁크(trunk) 브랜치만 클라이언트에 공지하며, 클라이언트는 오직 트렁크 히스토리를 기준으로 패치 팩을 구성한다. 이 전략 덕분에 모노레포 푸시 팩파일 크기 중앙값은 20 KiB 미만으로 떨어졌고, 99번째 백분위수 역시 3 MiB 이하로 유지된다.
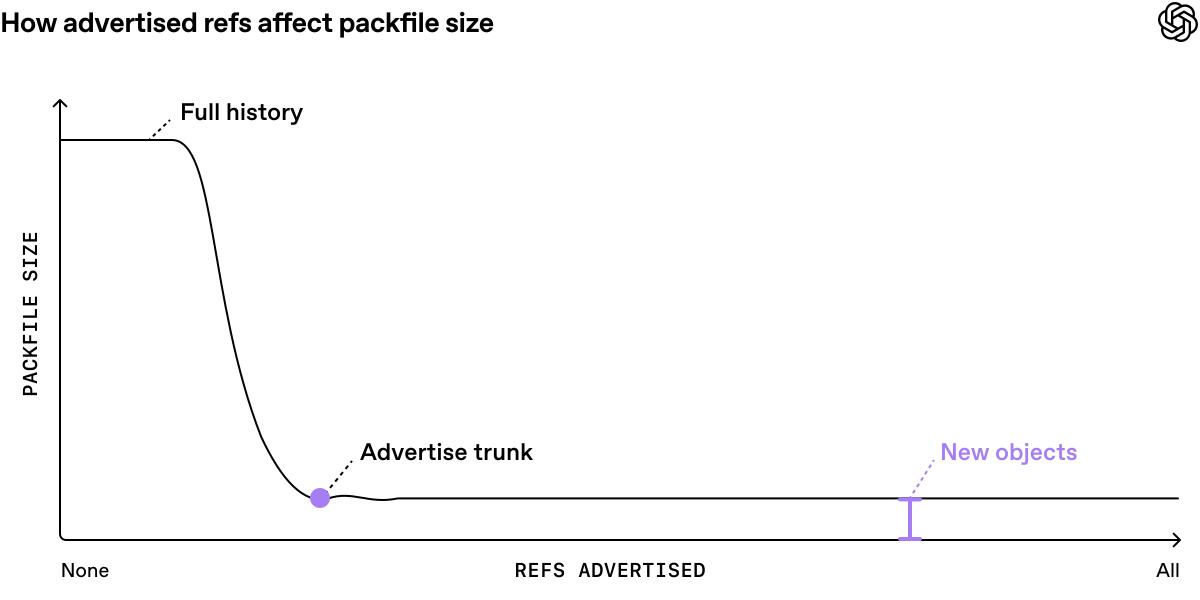 그림: 공지 ref 수와 팩파일 크기의 관계. 트렁크 브랜치만 공지해도 전송 데이터 크기를 대폭 줄이면서 네트워크 대역폭과 서버 재사용 효율을 동시에 잡을 수 있다. 출처: OpenAI 엔지니어링 블로그 “Scaling Git at OpenAI”
정적 팩파일을 네트워크 한계 속도로 전송하기 위해 시스템은 packfile-uri 기능을 깊이 있게 결합했다. 표준 Git 프로토콜 응답에는 빈 껍데기 패키지만 포함하고, 실제 대용량 데이터는 가장 가까운 익스프레스 지역 엣지 캐시에서 직접 전송한다. 디스크 캐시 적중률은 99%를 넘어서며, 시스템은 극소수의 CPU 코어만으로 10 Gbps 네트워크 인터페이스를 손쉽게 가득 채웠다.
잦은 푸시로 인해 발생하는 수많은 소형 파일 문제는 로그 구조화 병합 트리(LSM tree)에서 착안한 계층형 압축 구조로 해결했다. 푸시로 생성된 L0 기본 팩들을 백그라운드 워커가 주기적으로 더 넓은 범위를 포괄하는 통합 팩으로 병합한다. 이 계층화된 통합 팩은 스킵 리스트 역할을 수행하여 압축률을 높이는 동시에 패치 탐색 계획을 로그 시간 안에 마칠 수 있게 돕는다.
정형 검증과 아키텍처 선택으로 다시 세운 협업 경계
새 인프라는 기획부터 실제 프로덕션 적용까지 단 10주 만에 완성되었다. 핵심 구조는 한 명의 엔지니어가 설계했고, 자율 에이전트 팀이 코드 구현을 담당했으며, 소수의 엔지니어들이 배포를 이끌었다. 2026년 4월, 과거의 유산 없이 Rust로 작성된 신규 시스템이 전체 프로덕션 트래픽을 완벽하게 넘겨받았다.
에이전트가 작성한 코드가 복잡한 예외 상황에서 어긋나지 않도록, 엔지니어링 팀은 표준 Git 동작과 세밀하게 대조하는 적합성 테스트 스위트를 구축했다. 팀은 GPT-6 Astra를 활용해 Lean과 TLA+ 사양을 작성하고 시스템 안전성을 정형 수학적으로 증명했다. 에이전트들은 수백 시간 동안 연속 실행되며 경쟁 조건을 집요하게 추적했고, Daybreak급 모델 기반의 레드팀 훈련을 병행했다.
탁월한 처리량을 확보하는 과정에서 팀은 수반되는 비용을 담담히 수용했다. 팩파일을 그대로 재사용한다는 것은 클라이언트가 트렁크 기준선 외부에 이미 보유한 객체를 가끔 중복 다운로드할 수 있음을 의미한다. 전체 리포지토리의 단일 시계 스냅샷을 포기함에 따라 전역 상태에 의존하던 구형 분석 도구들도 추가 수정이 필요했다. 엔지니어링 설계의 본질은 균형과 선택이다. 동시 쓰기 처리량이 절대적 과제인 상황에서 부분적인 저장소 중복은 충분히 감수할 만한 비용이다.
Git 핵심의 방향성 비순환 그래프(DAG) 객체 모델은 여전히 견고하다. 과거의 성능 병목은 Git 모델 자체의 한계가 아니라 서버 측이 강제해 온 중앙 집중식 가정 때문이었다. 자율 에이전트가 커밋 빈도를 극적으로 끌어올린 지금, 버전 관리 시스템은 인과적 일관성을 갖춘 데이터 파이프라인으로 진화하고 있다. 미래의 개발 인프라는 사람과 인공지능 에이전트가 빚어내는 지속적인 협업의 흐름을 서버가 얼마나 매끄럽게 뒷받침할 수 있느냐에 달려 있다.
참고 링크:
- OpenAI 엔지니어링 블로그 “Scaling Git at OpenAI”