2026 年底,OpenAI 单体仓库的提交频率相比两年前暴涨了 2442%。接入日常研发的 Codex 重塑了代码产出节奏,一个人可以同时推进数十个改动分支。旧服务端的可用性一度跌破 90%。
2026 年 11 月 2 日,OpenAI 披露了自研 Git 服务端 Pando。新系统每天吞吐近 1 PB 数据,中位推送延迟压低了近 80%。支撑高并发流量的前提,是推翻了两条沿用二十年的服务端默认假设。
业界习惯把版本控制的瓶颈归咎于客户端结构或单体仓库体量。**Pando 表明,性能上限来自服务端维持的全库强一致与定制打包。**当并发智能体将提交密度推升一个量级,服务端的设计假设必须重构。
提交量暴涨 24 倍压垮传统集群
代码提交增长超越了团队极限。OpenAI 早期模型预测 2026 年底增幅为 1378%,实际增速却冲高至 2442%。智能体接管了编写与测试,单名工程师便能发起密集的合并请求。
每次代码推送都会在后台唤醒海量构建容器。成百上千个作业在同一秒索取最新提交,流量峰值频频冲垮接口。2025 年底,旧版服务端频繁出现推送排队、合并失败与拉取超时。
服务可用性跌破 90%,暴露出中心化集群的吞吐上限。自动化流水线普及后,代码提交直接受制于并发智能体掀起的数据风暴。老旧协同架构无法适应成倍膨胀的代码变更,系统重构已成定局。
传统分布式方案全部倒在串行锁上
面对高并发,行业通常首选 3PC 复制。每个副本需保存完整仓库,包文件在多数副本持久化后才能更新引用。通信延迟与副本磁盘性能进入关键路径,迫使分支引用只能串行推进。
另一条路径基于共享对象存储与预写日志(WAL)。推送可并行上传包文件,但提交仍需通过 CAS 争夺清单修改权。CAS 网络往返耗时设定了全库写入上限,追赶索引的只读副本也容易掉队。
两套方案的共同症结,在于试图维护全局一致的时钟快照。智能体大多在隔离分支上工作,不相关的分支改动却因全局锁相互拖累。只要坚持全库快照隔离,单体仓库的写入吞吐量就会被单点机制锁死。
放弃强一致与定制打包换取写并行
Pando 选择从系统原点推翻传统服务端的预设。系统放弃了仓库级强一致,将一致性范围收窄至单个分支引用。不相干的分支更新在元数据层保持独立,写路径的元数据读写复杂度由此降至 O(1)。
客户端推送产生的 packfile,作为不可变数据块直接写入对象存储。服务端在元数据存储中追加轻量引用版本,标记新提交与依赖的历史版本。客户端拉取时仅需回溯版本链,元数据读取开销保持在 O(log Δ) 级别。
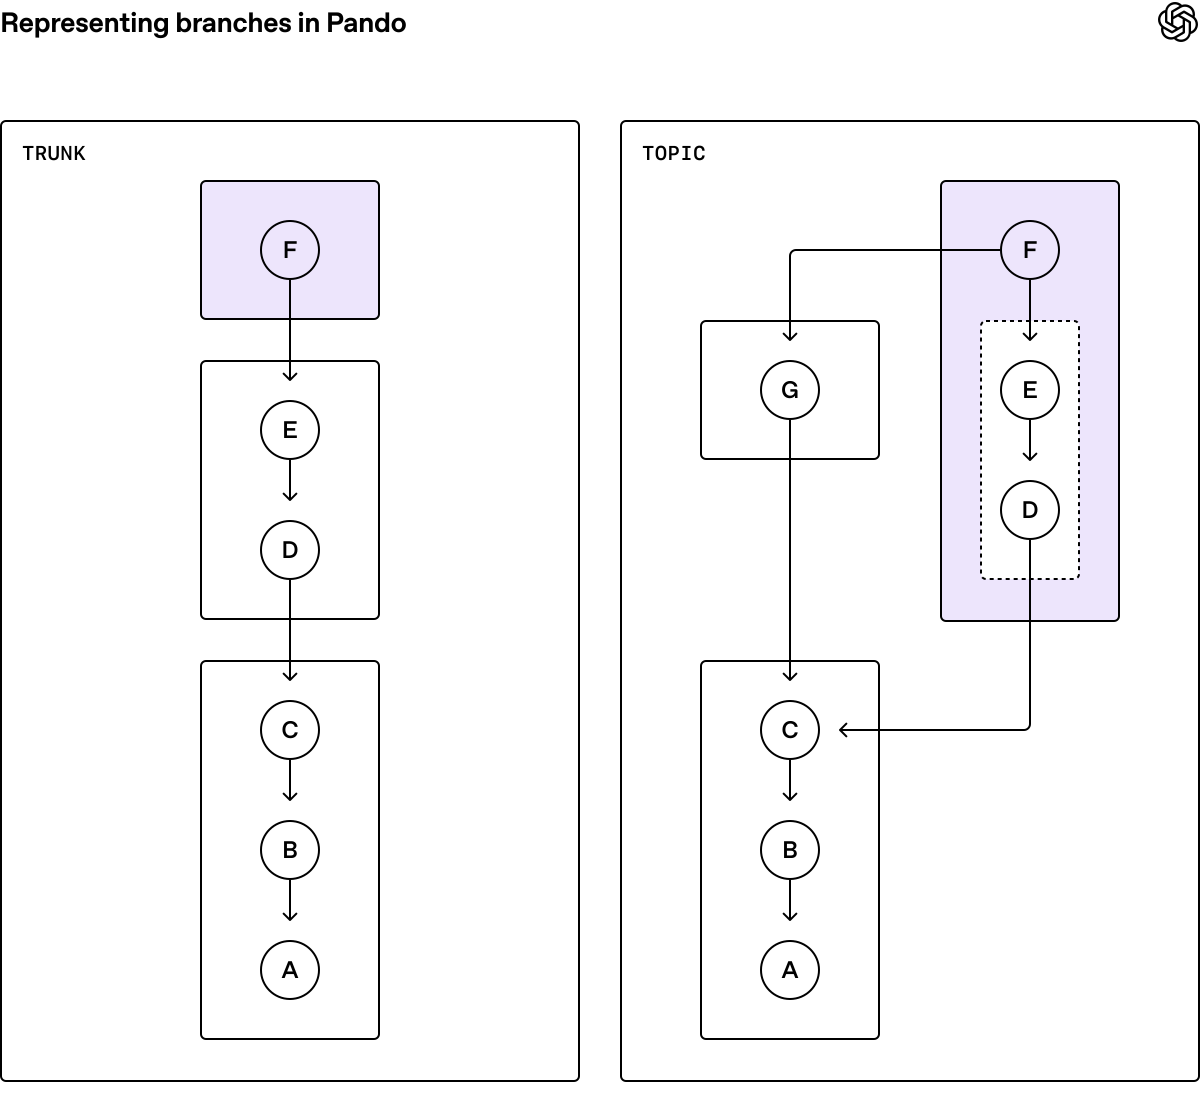 图:Pando 的 ref version 与 packfile 依赖关系。trunk 与 topic 分支在提交 C 分叉,topic 依赖主干分支的提交 G。来源:OpenAI 工程博客《Scaling Git at OpenAI》
这种架构调整带来了立竿见影的写性能提升。客户端同时读取多分支时,无法假定它们来自同一时刻。开发流程天然只需关注特定分支的因果演进。以因果一致替代全库强一致,海量并发分支解开了全局锁的束缚。
缓存直吐与跳表压缩消除服务端开销
传统服务端最沉重的负载来自拉取打包。每次客户端执行拉取,服务端都要遍历对象图计算差异并实时压缩。Pando 放弃了定制打包机制,直接复用推送时保存的原始 packfile 提供下载。服务端由此转变为纯粹的文件分发节点,几乎不再消耗 CPU 资源。
在百万级分支的大型单体仓库中,全量广告分支引用的报文会超过 100 MiB。Pando 默认只向客户端广告指定的主干分支,客户端仅基于主干历史构造补丁包。该策略下单体仓库推送的中位 packfile 小于 20 KiB,99 分位亦保持在 3 MiB 以下。
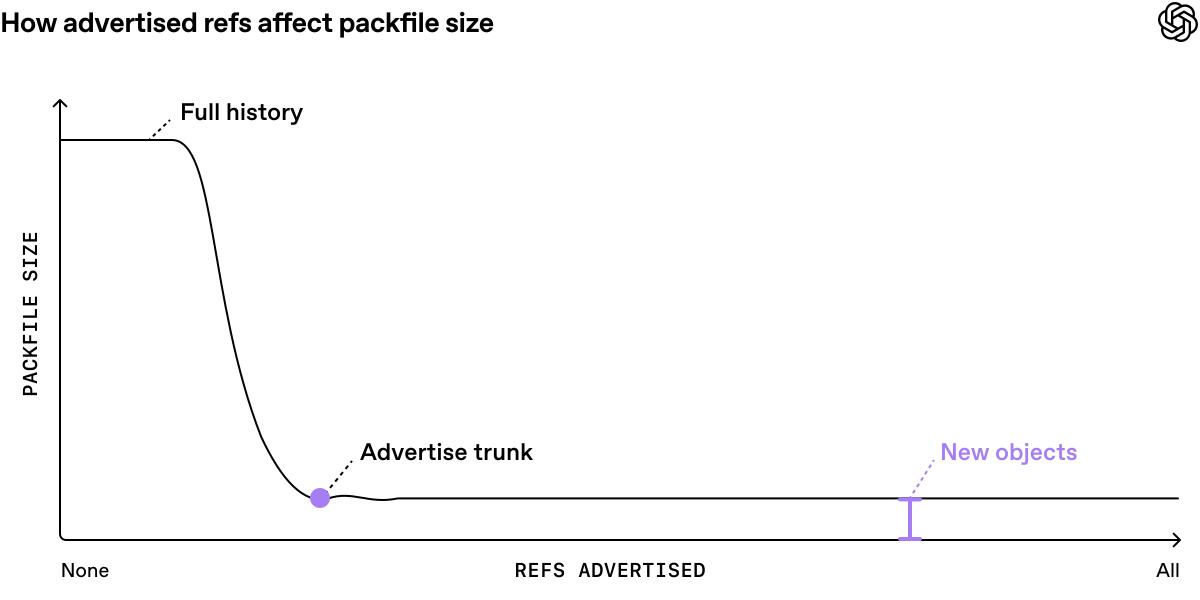 图:广告 ref 数量与 packfile 大小关系。只广告主干分支即可大幅削减传输包体积,兼顾网络带宽与服务端复用效率。来源:OpenAI 工程博客《Scaling Git at OpenAI》
为了让静态包的分发达到线速,系统深度集成了 packfile-uri 特性。Git 协议响应中仅内嵌空包,真实数据交由就近的 Express 区域缓存分发。磁盘缓存命中率超过 99%,系统仅用少量 CPU 核心便轻松打满了 10 Gbps 网卡。
频繁推送产生大量小文件,Pando 引入类似日志结构合并树的分层压缩机制。推送产生 L0 基础包,后台工作进程定期将其融合成覆盖更大区间的合并包。分层合并包充当跳表,既提升压缩比,又让拉取规划在对数时间内完成。
形式化验证与架构取舍重定协作边界
新基础设施从立项到上线仅用了 10 周。核心由一人设计,智能体团队完成代码实现,少量工程师推进部署。2026 年 4 月,这套使用 Rust 实现且无历史包袱的系统正式接管了全部生产流量。
为防止智能体写出的代码在复杂边界失守,工程团队建立了逐条比对标准 Git 行为的一致性测试套件。团队利用 GPT-6 Astra 编写 Lean 与 TLA+,形式化推导出系统性质证明。智能体连续运行数百小时排查竞态,并依托具备 Daybreak 能力的模型做红队演练。
工程团队在取得高吞吐的同时,坦然接纳了相应的代价。复用 packfile 意味着客户端偶尔会重复下载主干之外的已有对象。放弃全局时钟也给依赖全库快照的旧分析工具带来了适配成本。工程设计的本质是权衡取舍,当写并行成为刚需,局部存储冗余就是合理代价。
Git 核心的 DAG 对象模型依然稳固。过去的性能瓶颈实际上来自服务端加诸其上的中心化假设。智能体推升提交频率后,版本控制系统演进为具备因果一致性的数据管道。未来的研发基础设施,聚焦于服务端如何高效支撑人机协同的持续流动。
参考链接:
- OpenAI 工程博客《Scaling Git at OpenAI》