Hacia finales de 2026, la frecuencia de commits en el monorepositorio central de OpenAI se disparó un 2442% en comparación con dos años atrás. La integración de Codex en el flujo de trabajo habitual redefinió por completo el ritmo de producción de código, permitiendo que un solo ingeniero gestionara docenas de ramas simultáneamente. La disponibilidad de la infraestructura heredada llegó a caer por debajo del 90%.
El 2 de noviembre de 2026, OpenAI presentó Pando, su backend de servidor Git de desarrollo propio. El nuevo sistema mueve cerca de 1 PB de datos al día y reduce la latencia mediana de push en torno a un 80%. Para soportar semejante volumen de tráfico impulsado por agentes concurrentes, fue imprescindible derribar dos supuestos fundacionales que habían dominado el lado del servidor durante dos décadas.
En la industria se suele atribuir el cuello de botella del control de versiones a la estructura del cliente o a las dimensiones del monorepositorio. Sin embargo, Pando demuestra que el verdadero límite de rendimiento provenía de la consistencia fuerte global y del empaquetado en caliente impuestos por el servidor. Cuando los agentes concurrentes elevan la densidad de commits en un orden de magnitud, las premisas de diseño del backend deben reinventarse por completo.
Un salto de 24 veces en los commits desborda los servidores tradicionales
El ritmo de incremento de los commits desbordó todas las previsiones del equipo. Los modelos predictivos iniciales de OpenAI proyectaban un alza del 1378% para finales de 2026; la cifra real trepó hasta el 2442%. Los agentes autónomos asumieron la redacción de código y la ejecución de pruebas, posibilitando que un único desarrollador abriera ráfagas constantes de pull requests.
Cada push despertaba en segundo plano cientos de contenedores de compilación. Miles de tareas solicitaban el último commit en el mismísimo segundo, saturando los puntos de acceso ante picos inasumibles de tráfico. A finales de 2025, el servidor tradicional acumulaba colas de push interminables, fallos de fusión y cancelaciones por tiempo de espera en los fetch.
La caída de la disponibilidad por debajo del 90% dejó al descubierto el techo de rendimiento de los clústeres centralizados. Con la automatización plenamente implantada, la frecuencia de commits pasó a depender de las tormentas de datos generadas por agentes simultáneos. La vieja arquitectura de colaboración no podía sostener una masa de cambios en continuo crecimiento, haciendo inevitable una reestructuración de raíz.
Los modelos distribuidos clásicos tropiezan con los bloqueos en serie
Ante una concurrencia extrema, la industria suele inclinarse por la replicación mediante compromiso en tres fases (3PC). Cada réplica debe almacenar una copia completa del repositorio y los archivos pack deben persistir en la mayoría de los nodos antes de poder actualizar las referencias. La latencia de red y la velocidad de escritura en disco entran directamente en la ruta crítica, obligando a procesar las referencias de rama en una cola estrictamente secuencial.
La otra alternativa habitual combina almacenamiento de objetos compartido con registros de escritura previa (WAL). Aunque los push pueden subir archivos pack en paralelo, las modificaciones del manifiesto siguen compitiendo mediante operaciones CAS (Compare-And-Swap). El tiempo de ida y vuelta de las llamadas CAS en red impone un techo restrictivo a las escrituras en todo el repositorio, y las réplicas de solo lectura se rezagan con facilidad al sincronizar los índices.
Ambos modelos adolecen del mismo problema estructural: el empeño en sostener una instantánea coherente y sincronizada de todo el repositorio bajo un reloj universal. Los agentes trabajan casi siempre en ramas temáticas aisladas, pero ramas sin relación alguna terminaban bloqueándose entre sí por cerrojos globales. Mientras se insista en el aislamiento por instantánea global, el rendimiento de escritura de un monorepositorio quedará encadenado a un mecanismo de coordinación central.
Adiós a la consistencia fuerte: máxima concurrencia de escritura
Pando optó por cuestionar los axiomas tradicionales desde sus cimientos. Renunció a la consistencia fuerte a nivel de repositorio y acotó el alcance de la consistencia a cada referencia de rama de manera individual. Las actualizaciones de ramas independientes se aíslan por completo en la capa de metadatos, con lo que la complejidad de lectura y escritura en la ruta de guardado se reduce a O(1).
Los packfiles generados por los clientes se escriben directamente en el almacenamiento de objetos como bloques inmutables. El servidor se limita a añadir una versión de referencia (ref version) ligera en su almacén de metadatos, enlazando el nuevo commit con las versiones históricas de las que depende. Al realizar un fetch, el cliente solo tiene que recorrer esa cadena de versiones, manteniendo el coste de lectura de metadatos en un orden de O(log Δ).
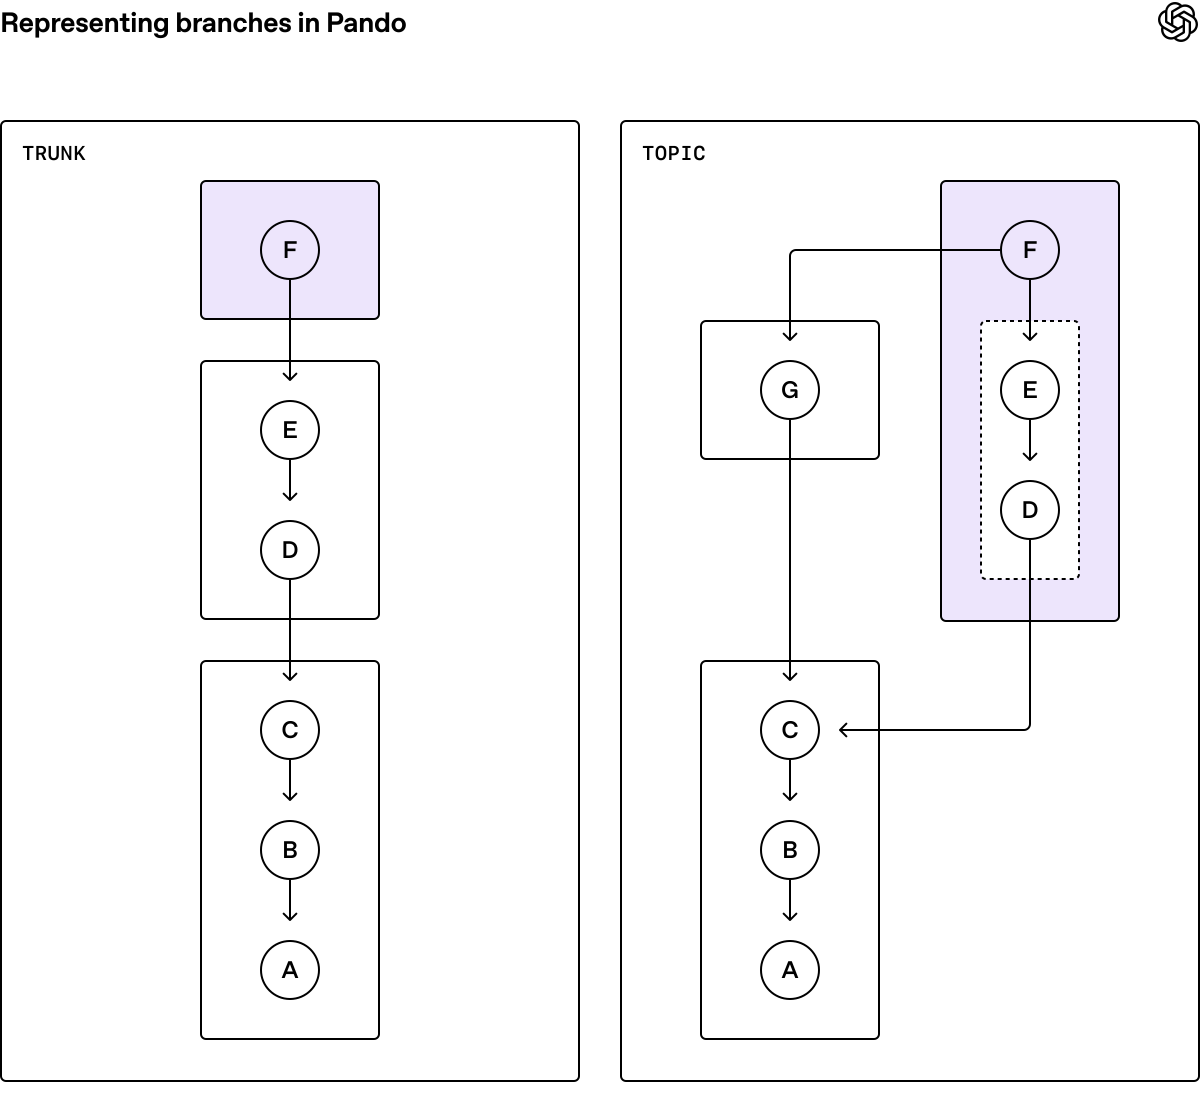 Gráfico: Esquema de versiones de ref y dependencias de packfiles en Pando. Trunk y topic divergen en el commit C; topic depende del commit G de trunk. Fuente: Blog de ingeniería de OpenAI, “Scaling Git at OpenAI”
Este cambio de arquitectura desbloqueó de inmediato el rendimiento de escritura. Cuando un cliente consulta varias ramas de forma concurrente, ya no asume que pertenezcan exactamente al mismo instante temporal. En la práctica, el flujo de trabajo solo necesita seguir la progresión causal de una rama concreta. Al sustituir la consistencia global por consistencia causal, millones de ramas concurrentes se liberaron de los bloqueos globales.
Cero carga de CPU mediante reutilización de caché y skip lists
Históricamente, la carga de procesamiento más pesada en un servidor Git residía en la creación de paquetes durante las lecturas. Cada vez que un cliente hacía pull o fetch, el servidor recorría el grafo de objetos para calcular diferencias y comprimir datos al vuelo. Pando suprime este empaquetado dinámico y reutiliza de forma directa los packfiles originales almacenados en el push. El backend se convierte así en un nodo de distribución estática que apenas consume recursos de CPU.
En un monorepositorio con millones de ramas, emitir todas las referencias disponibles (advertised refs) genera una carga inicial superior a 100 MiB. Pando anuncia por defecto únicamente las ramas principales (trunk), y el cliente genera sus paquetes de cambios calculando diferencias solo respecto a esa base. Con esta política, el tamaño mediano de los packfiles en un push es inferior a 20 KiB, e incluso el percentil 99 se mantiene por debajo de 3 MiB.
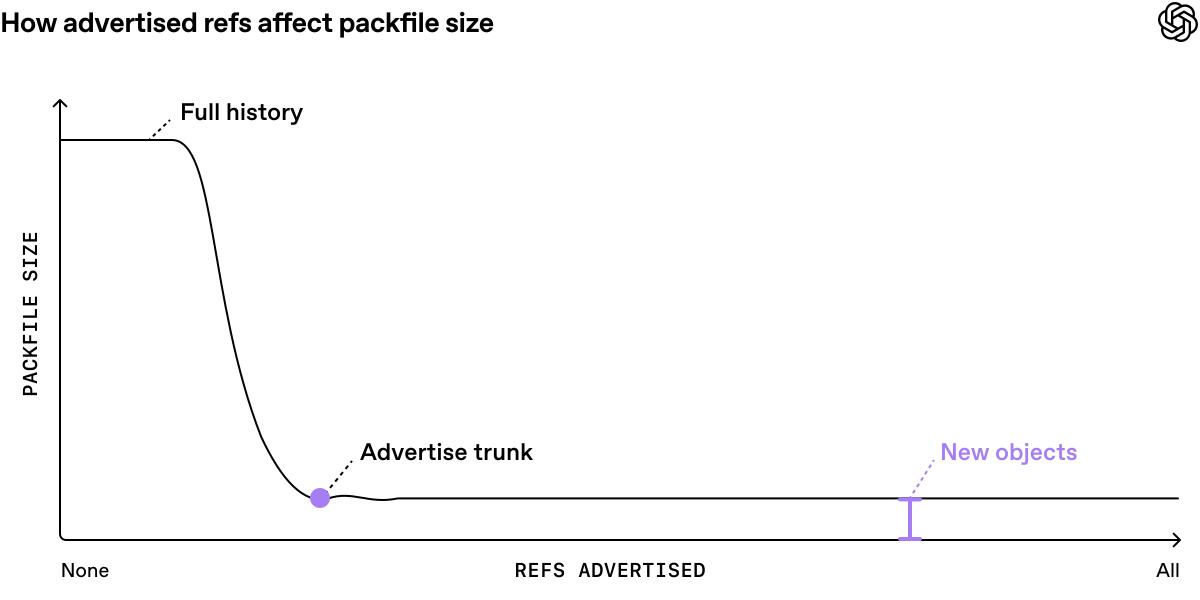 Gráfico: Relación entre el número de refs anunciadas y el tamaño del packfile. Anunciar solo las ramas principales reduce drásticamente el volumen transmitido, equilibrando ancho de banda y eficiencia del servidor. Fuente: Blog de ingeniería de OpenAI, “Scaling Git at OpenAI”
Para entregar los paquetes estáticos a velocidad de línea, el sistema integra la función packfile-uri. La respuesta básica de Git devuelve un paquete mínimo vacío, delegando los datos binarios voluminosos a cachés perimetrales regionales de alta velocidad (Express). Con tasas de acierto en disco superiores al 99%, la infraestructura satura enlaces de 10 Gbps con apenas un puñado de núcleos de CPU.
Dado que los envíos frecuentes generan multitud de archivos diminutos, Pando incorpora una compactación jerárquica inspirada en los árboles LSM (Log-Structured Merge). Los pushes generan paquetes base L0, que procesos en segundo plano consolidan periódicamente en paquetes que cubren rangos temporales mayores. Estos paquetes fusionados actúan como una skip list, mejorando la compresión y permitiendo que la resolución de los fetch se complete en tiempo logarítmico.
Verificación formal y compensaciones arquitectónicas
La nueva infraestructura pasó del diseño conceptual a producción en solo 10 semanas. Un único ingeniero concibió la arquitectura base, un enjambre de agentes autónomos programó el código y un reducido equipo de ingenieros coordinó el despliegue. En abril de 2026, esta solución implementada en Rust y libre de ataduras del pasado asumió el 100% del tráfico productivo.
Para garantizar que el código escrito por agentes respondiera con solvencia ante casos límite, el equipo creó una rigurosa batería de pruebas de conformidad frente al comportamiento canónico de Git. Se recurrió a GPT-6 Astra para redactar especificaciones formales en Lean y TLA+, demostrando matemáticamente las propiedades del sistema. Los agentes trabajaron cientos de horas continuas buscando condiciones de carrera, complementados por ejercicios de red team con modelos Daybreak.
Alcanzar un rendimiento tan masivo implicó asumir contrapartidas con total transparencia. Reutilizar packfiles conlleva que los clientes descarguen en ocasiones objetos que ya poseen fuera de la línea principal de trunk. De igual modo, prescindir de un reloj global requirió adaptar herramientas de análisis heredadas que dependían de capturas globales unificadas. El diseño de ingeniería reside en el equilibrio de compromisos: cuando la concurrencia de escritura es vital, una redundancia localizada en el almacenamiento es un precio plenamente asumible.
El modelo de objetos en grafo acíclico dirigido (DAG) de Git sigue siendo formidable. Las barreras de rendimiento del pasado no surgían del formato de datos, sino de las presunciones centralizadas impuestas en el servidor. A medida que los agentes disparan el ritmo de los commits, el control de versiones evoluciona hacia una canalización de datos regida por consistencia causal. El futuro de la infraestructura de desarrollo se centrará en servidores capaces de sostener el flujo constante de colaboración entre humanos y máquinas.
Referencias:
- Blog de ingeniería de OpenAI, “Scaling Git at OpenAI”