2026年末、OpenAIのモノレポにおけるコミット頻度は2年前と比べて2442%跳ね上がった。日常の開発フローに統合されたCodexがコード生成のテンポを根本から変え、1人のエンジニアが同時に数十もの変更ブランチを走らせるようになった。レガシーサーバーの可用性は一時90%を割り込む事態に陥った。
2026年11月2日、OpenAIは自社開発のGitサーバーバックエンド「Pando」を公表した。新システムは1日に約1PBのデータを処理し、プッシュ遅延の中央値を約80%削減した。この急増したエージェントトラフィックを支える土台となったのは、20年にわたり踏襲されてきたサーバー側の2つの前提を覆したことだ。
業界ではバージョン管理のボトルネックをクライアントの挙動やモノレポの規模に帰する傾向がある。**しかしPandoが示したのは、真の性能限界がサーバー側のリポジトリ全体に及ぶ強整合性の維持と動的パッキングに起因していたという事実だ。**並行稼働するエージェント群がコミット密度を一桁押し上げた今、サーバー設計の前提自体を根本から見直さなければならなかった。
コミット数24倍の急増が旧インフラを直撃
コードコミットの伸びはチームの予測を遥かに超えていた。OpenAIの初期予測モデルは2026年末の伸びを1378%と試算していたが、実際には2442%へと達した。自律エージェントがコード記述とテストを肩代わりしたことで、エンジニア1人が濃密なプルリクエストを次々と生成できるようになった。
コードがプッシュされるたび、バックエンドでは無数のビルドコンテナが一斉に立ち上がる。数百、数千のジョブが同一秒に最新コミットを取得しようとし、アクセス集中によってエンドポイントが頻繁にダウンした。2025年末には、プッシュのキューイングやマージの失敗、フェッチタイムアウトが日常茶飯事となっていた。
可用性が90%を下回ったことは、中央集権型クラスタの処理限界を浮き彫りにした。自動化パイプラインが浸透した結果、コードコミットの流入速度は並行エージェントが巻き起こすデータストームに直結するようになった。急激に肥大化するコード変更に旧来のコラボレーション基盤は耐えきれず、アーキテクチャの全面刷新は不可避となった。
直列ロックの前に倒れる従来の分散アプローチ
高並行への対策として、業界では3相コミット(3PC)によるレプリケーションが一般的だった。各レプリカが完全なリポジトリコピーを保持し、過半数のレプリカにパックファイルが永続化されて初めて参照(ref)が更新される。しかし、通信レイテンシやディスク書き込み速度がクリティカルパスに乗るため、ブランチ参照の更新は直列に制限されてしまう。
もうひとつのアプローチは、共有オブジェクトストレージと先行書き込みログ(WAL)を組み合わせる方式だ。プッシュ時のパックファイルアップロード自体は並行処理できるものの、マニフェスト更新の権利をCAS(Compare-And-Swap)で奪い合う構造は変わらない。CASのネットワーク往復時間がリポジトリ全体の書き込み上限を縛り、インデックスを追跡する読み取り専用レプリカも追従遅延を起こしやすかった。
両アプローチに共通する根本原因は、リポジトリ全体で単一の整合したクロックスナップショットを維持しようとしていた点にある。エージェントは大半が独立したトピックブランチで作業しているにもかかわらず、無関係なブランチの変更同士がグローバルロックの巻き添えを食らっていた。リポジトリ全体のスナップショット分離に固執する限り、モノレポの書き込みスループットは単一障害点となる調整メカニズムによって封じ込められる。
強整合性と動的パッキングを捨てて書き込み並行性を獲得
Pandoは、旧来のサーバーが置いていた前提を原点から覆した。リポジトリ単位の強整合性を捨て、整合性の保証範囲を単一のブランチ参照へと絞り込んだ。無関係なブランチ更新はメタデータ層で完全に独立を保ち、書き込みパスにおけるメタデータの読み書き計算量はO(1)にまで圧縮された。
クライアントのプッシュによって生成されたパックファイルは、変更不可能な不変ブロックとしてオブジェクトストレージに直接書き込まれる。サーバーはメタデータストアに軽量な参照バージョン(ref version)を追記し、新しいコミットとそれが依存する過去のバージョン履歴を紐付ける。クライアントがフェッチする際はバージョンチェーンを遡るだけでよく、メタデータの読み取りオーバーヘッドはO(log Δ)に抑えられる。
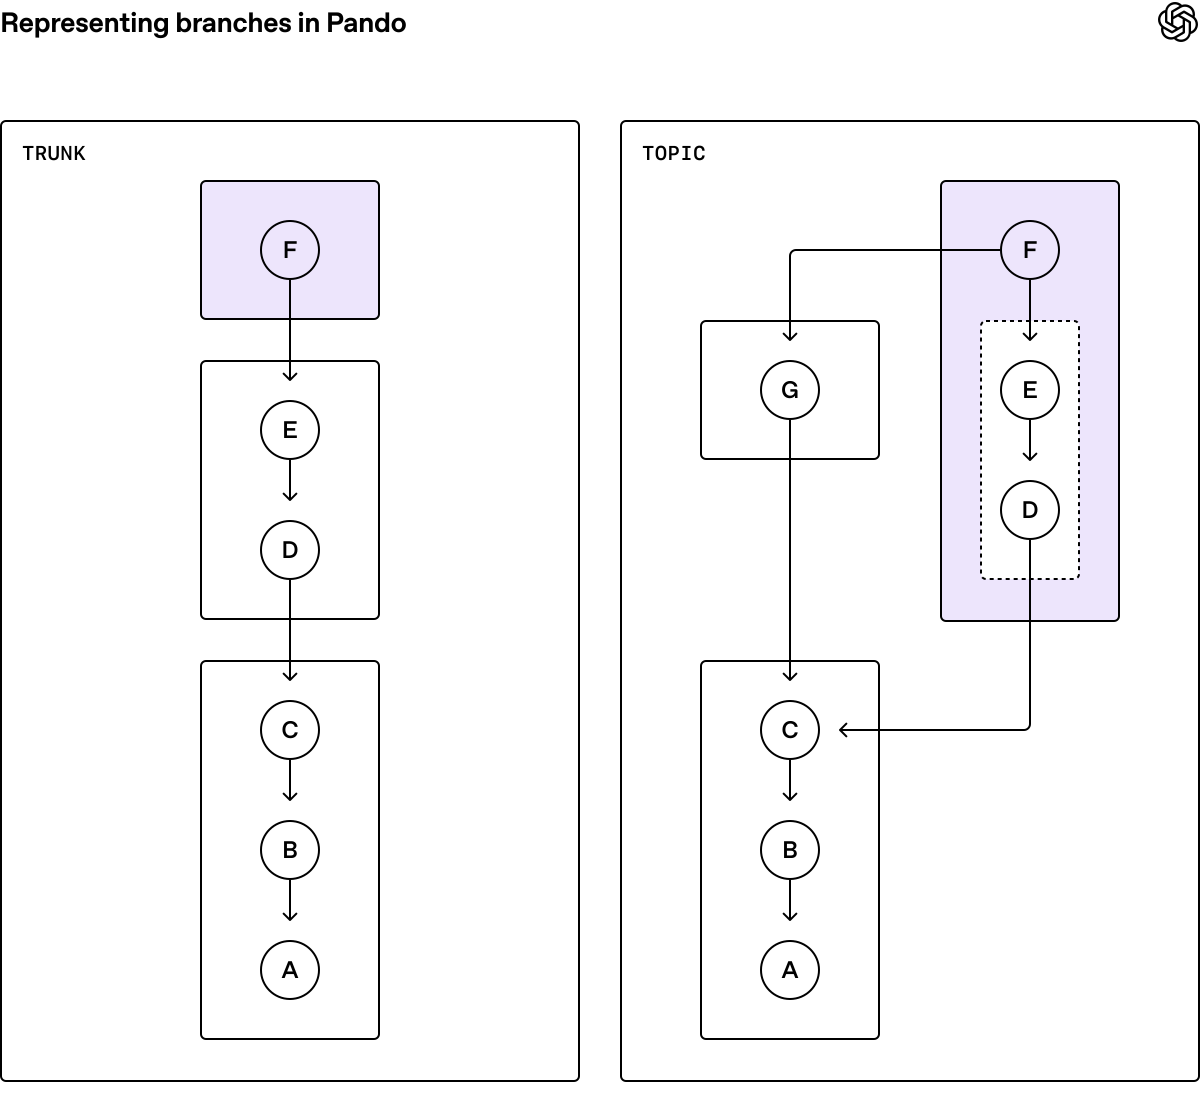 図:Pandoにおけるref versionとpackfileの依存関係。trunkとtopicブランチはコミットCで分岐し、topicはtrunkのコミットGに依存している。出典:OpenAI Engineering Blog “Scaling Git at OpenAI”
この設計変更は、書き込み性能に即座の劇的な向上をもたらした。クライアントが複数ブランチを同時に読み取る際、それらが同一時点のものであるという仮定は成り立たない。しかし実際の開発プロセスにおいて関心を向けるべきは、特定ブランチにおける因果関係の推移だけだ。全体強整合性を因果整合性に置き換えたことで、膨大な並行ブランチがグローバルロックの制約から解放された。
キャッシュの直接配信とスキップリスト圧縮でサーバー負荷をゼロ化
従来のGitサーバーで最も重い処理負荷は、フェッチ時のパック生成だった。クライアントからリクエストがあるたびに、サーバーはオブジェクトグラフを走査して差分を算出し、その場でリアルタイムに圧縮を施す。Pandoはこの動的パッキング処理を完全撤廃し、プッシュ時に保存されたオリジナルのパックファイルをそのままダウンロード用として再利用する。これにより、サーバーは純粋なファイル配信ノードへと変化し、CPUリソースの消費はほぼゼロになった。
数百万規模のブランチを抱えるモノレポでは、全ブランチ参照を広告(Advertise)するだけでレスポンスサイズが100 MiBを超えてしまう。Pandoはデフォルトで指定されたメインブランチ(trunk)のみをクライアントに広告し、クライアントはtrunkの履歴のみを基準にしてパッチパックを生成する。この戦略により、モノレポにおけるプッシュのパックファイルサイズ中央値は20 KiB未満、99パーセンタイルでも3 MiB以下に収まっている。
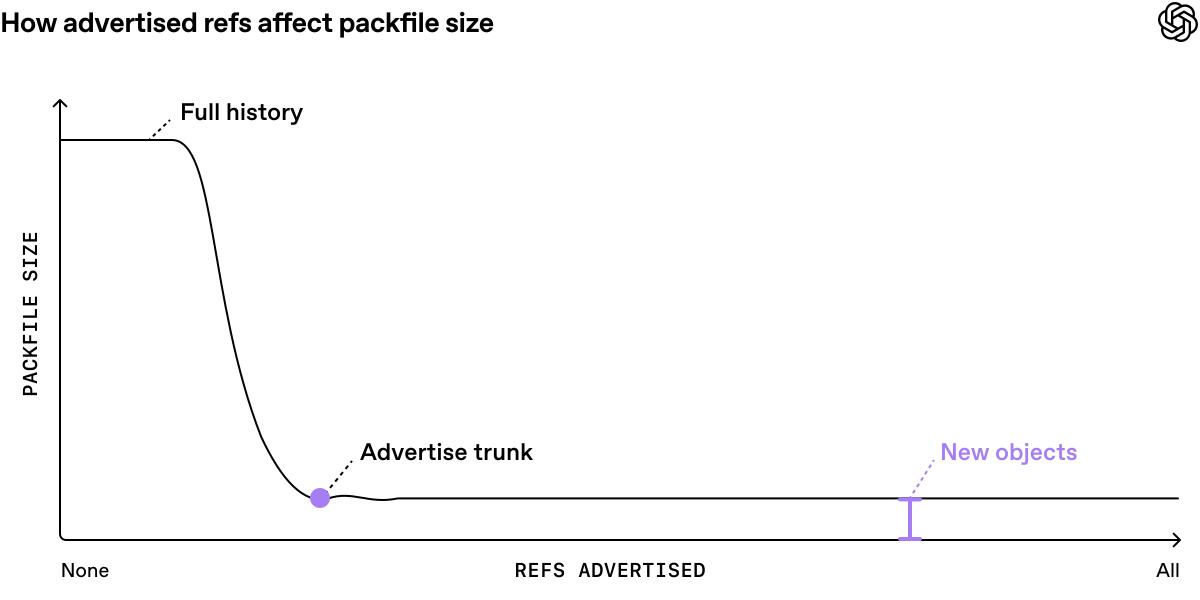 図:広告ref数とパックファイルサイズの関係。トランクブランチのみを広告することで転送データ量を大幅に削減し、帯域幅とサーバーの再利用効率を両立している。出典:OpenAI Engineering Blog “Scaling Git at OpenAI”
静的パックファイルを回線限界速度で配信するため、システムはpackfile-uri機能を全面的に統合した。通常のGitプロトコルの応答には空のエンベロープのみを含め、実際の大容量バイナリは最寄りのExpressリージョンエッジキャッシュから配信させる。ディスクキャッシュのヒット率は99%を超え、わずかなCPUコアだけで10 Gbpsの帯域を容易に使い切ることが可能となった。
細かなプッシュが頻発すると大量の小ファイルが生じるため、PandoはLSMツリー(Log-Structured Merge Tree)に着想を得た階層的コンパクション機構を導入した。プッシュ時に生成されるL0ベースパックを、バックグラウンドワーカーが定期的に広い範囲をカバーする統合パックへとマージする。この階層化パックがスキップリストとして機能することで、圧縮率を高めつつ、フェッチ時の探索計画を対数時間で完了させられる。
形式手法による検証とアーキテクチャのトレードオフ
この新インフラは、構想から本番稼働までわずか10週間で達成された。コアアーキテクチャを1人のエンジニアが設計し、自律エージェントのチームが実装を担当、少数のエンジニアチームがデプロイを指揮した。2026年4月、過去の負債を持たないRust実装のシステムが本番トラフィックの100%を引き継いだ。
エージェントが生成したコードがエッジケースで破綻するのを防ぐため、チームは標準Gitの仕様と挙動を網羅的に突き合わせる適合性テストスイートを構築した。GPT-6 Astraを活用してLeanおよびTLA+で形式仕様を記述し、システムの安全性を数学的に証明。さらに自律エージェントを数百時間連続稼働させて競合状態(レースコンディション)を洗い出し、Daybreakレベルのモデルによるレッドチーム演習を実施した。
桁外れのスループットを獲得した一方で、チームはそれに伴うトレードオフを率直に受け入れた。パックファイルの再利用は、クライアントがtrunkベースライン外で既に保持しているオブジェクトを重複してダウンロードする可能性を孕む。また、グローバルな単一クロックスナップショットを排したことで、リポジトリ全体の静止画に依存していた従来の分析ツールには改修が必要となった。エンジニアリングの本質はトレードオフにある。並行書き込みのスループットが最優先課題である以上、局所的なストレージの冗長性は十分に受け入れる価値のある代償だ。
Gitの根幹をなす有向非巡回グラフ(DAG)のオブジェクトモデルは今なお強固だ。かつて存在した性能の壁は、Git自体の欠陥ではなく、サーバー側に課された中央集権的な前提が生み出したものだった。自律エージェントがコミット頻度を飛躍的に高めたことで、バージョン管理システムは因果整合性に基づくデータパイプラインへと進化した。次世代の開発インフラは、人間とAIエージェントの継続的な協調をいかに淀みなく支えるかという点に注力している。
参考リンク:
- OpenAI Engineering Blog “Scaling Git at OpenAI”